Palavras Com Acentuação

Como lidar com acentuação em palavras no dia a dia
Muita gente travada quando precisa processar texto com acentos, seja para exportar planilhas, montar sistemas ou fazer scripts de automação. O problema é que a acentuação não é só uma questão visual, ela muda o código do caractere e qualquer ferramenta que não trate isso direito vai gerar bagunça. Vou explicar como funciona na prática, com os detalhes que realmente importam. Quando você vê uma palavra como "sábado" ou "avó", o computador não vê esses sinais como algo separado. Cada caractere acentuado tem dois códigos possíveis: o precomposto (único, como o Unicode U+00E1 para á) ou a composição decomposta (o "a" normal U+0061 mais o acento agudo U+0301). A grande maioria dos sistemas espera a forma precomposta. Quando algo vem em NFC versus NFD, letras com acento viram interrogações ou quadrados brancos em telas que não esperam por isso. Já me deparei com um caso específico em que precisei migrar dados de um banco legado para um sistema novo. As palavras com acentuação vinham em decomposição NFD porque o software antigo usava uma codificação proprietária. O resultado? Todas as consultas SQL com LIKE davam errado, os filtros da interface travavam e ninguém entendia o porquê. A solução foi rodar uma normalização NFC com a função unicodedata.normalize('NFC', texto) no Python antes de qualquer inserção no novo banco. Não adiantava apenas trocar a codificação do arquivo, o problema estava na representação dos caracteres dentro dos dados brutos.
Conhecendo palavras com acentuação na prática
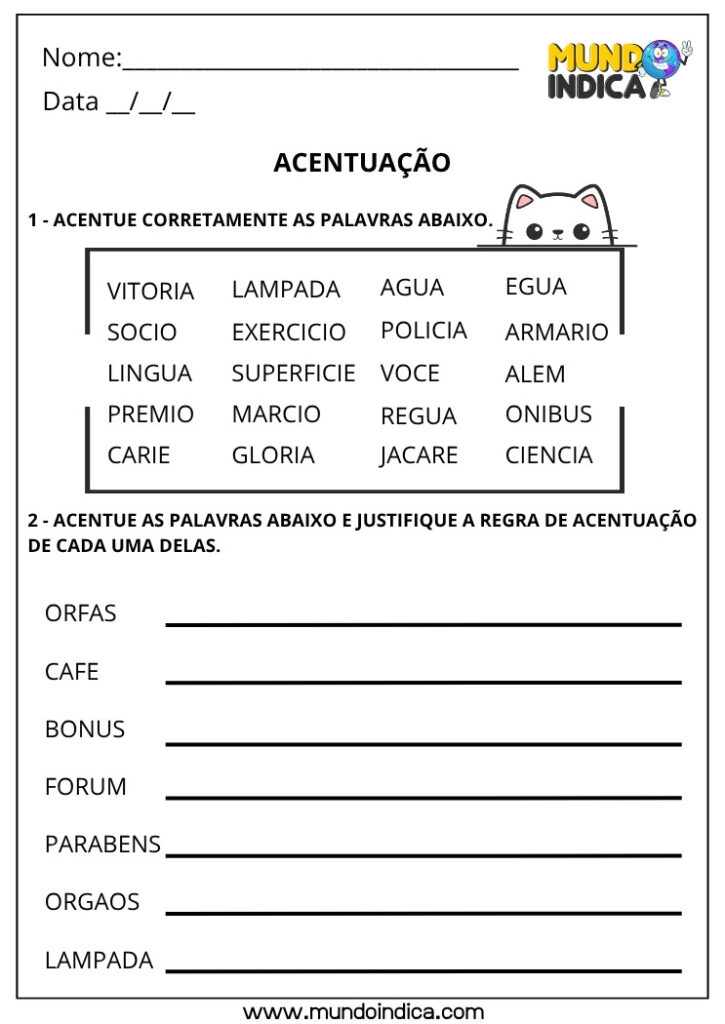
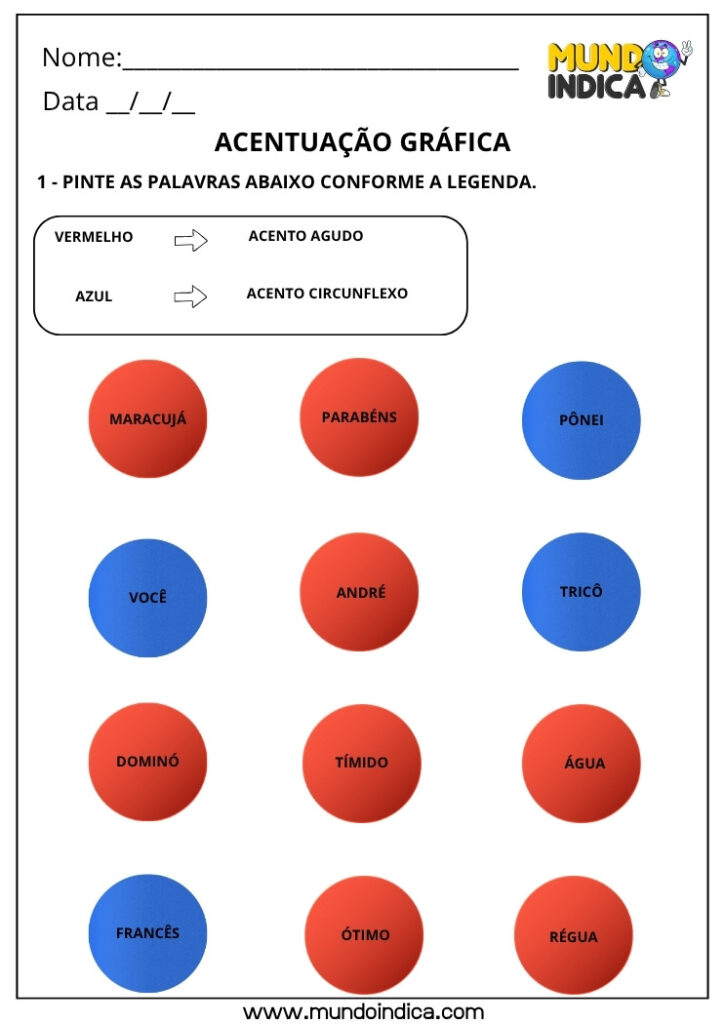
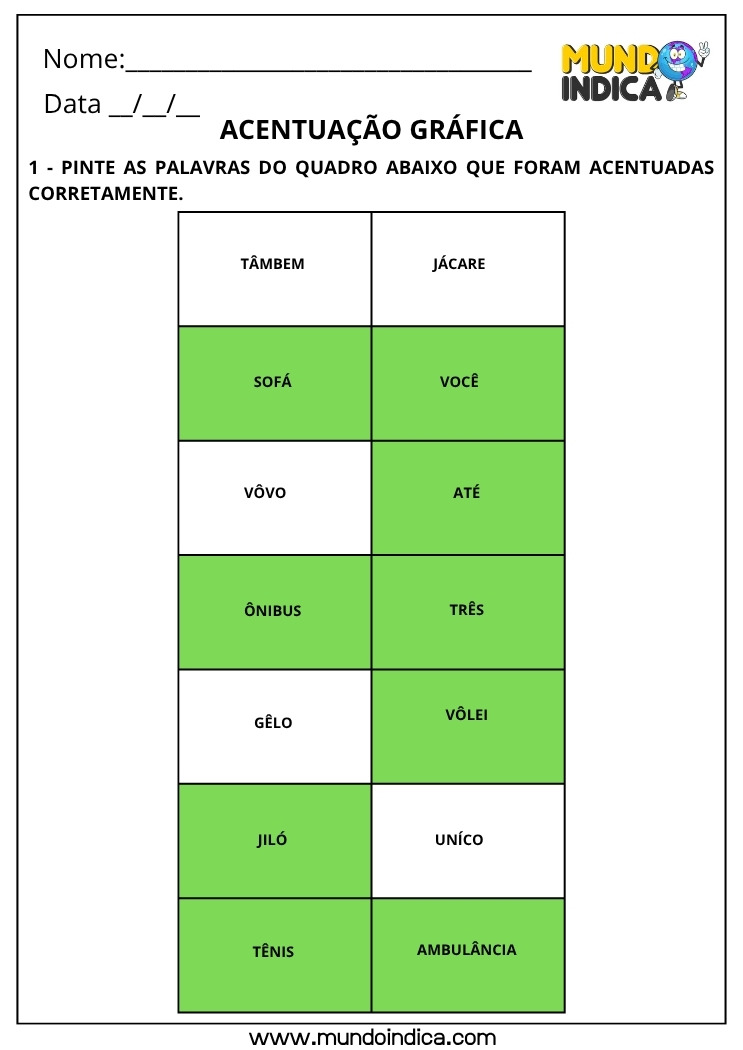
As principais classes de acentuação em português são: agudo (á, é, ó), circunflexo (â, ê, ô), til (ã, õ), grave (à) e cedilha (ç). Cada uma corresponde a pontos específicos no Unicode. O interessante é que o acento grave em português é quase exclusivo da crase (à, às), enquanto em outras línguas ele serve para marcas tonais. Se você estiver trabalhando com texto multilíngue, confusão entre acento grave e crase pode causar erros silenciosos de normalização. A norma ortográfica de 1990 mudou regras importantes sobre o uso do acento diferencial. Palavras como "pôde" (passado) versus "pode" (presente) ainda mantêm o acento, mas "para" (verbo) e "para" (preposição) perderam a distinção gráfica. Isso parece bobo, mas afeta ferramentas de processamento de linguagem que dependem de padrões fixos. Se você treina um modelo ou cria um regex baseado em regras antigas, vai pegar casos onde a distinção simplesmente não existe mais.
Como normalizar texto com acentos corretamente
O passo mais importante é decidir se você quer preservar a acentuação ou remover completamente. As duas abordagens são válidas, dependendo do objetivo. Para preservar os acentos, o essencial é garantir que a codificação do arquivo e do sistema seja UTF-8 em todos os níveis. Arquivos CSV exportados do Excel costumam vir em ANSI ou Windows-1252 sem que o usuário perceba. A dica prática é sempre abrir o arquivo com codificação explícita, nunca confiar na detecção automática. Em Python, o código é simplesmente open('arquivo.csv', encoding='utf-8'). Em Java, usar new InputStreamReader(stream, StandardCharsets.UTF_8). No JavaScript com Node, especificar { encoding: 'utf8' } nas operações de leitura. Para remover acentos, o método mais confiável em português é a normalização NFD seguida da remoção dos combinadores. O acento em NFD vira um caractere separado (combining diacritical mark), então basta filtrar por categoria de união. O resultado de "São Paulo" vira "Sao Paulo". Em Python, o código fica assim:
import unicodedata
texto = unicodedata.normalize('NFD', texto)
texto_sem_acento = ''.join(c for c in texto if unicodedata.category(c) != 'Mn') Esse processo funciona para português, espanhol, francês e a maior parte das línguas latinas. Tem uma exceção importante: letras com til como ã e õ podem se comportar de forma inconsistente em bibliotecas mais antigas de normalização. Teste sempre com os dados reais antes de confiar cegamente.
Pegadinhas que ninguém conta
A primeira pegadinha é o famoso "Acento gráfico versus acento fonológico". A palavra "rádio" tem acento gráfico porque a norma ortográfica exige, mas fonologicamente o acento tônico é outra história. Ferramentas que tentam identificar automaticamente onde o acento deve cair baseando-se apenas na pronúncia vão errar palavras like "órfão" versus "orfao" dependendo do dicionário que usam como referência. Sempre valide com um dicionário de referência, não confie em regras heurísticas. A segunda pegadinha é mais técnica. Tabelas de banco de dados com colunas do tipo VARCHAR e collation insensitive a acentos parecem resolver o problema, mas geram comportamento estranho em ordenações. "Açaí" pode aparecer antes ou depois de "abaixo" dependendo da collation configurada. Se a ordenação alfabética é importante para o seu sistema, teste explicitamente com os dados que você realmente vai consultar. A configuração padrão do MySQL, por exemplo, trata "a" e "á" como iguais na maioria das collations, o que quebra buscas que precisam de distinção.
Quando normalizar e quando manter os acentos originais
Se você está fazendo pesquisa de texto, comparação de strings ou integração entre sistemas que não são seus, remova os acentos antes de comparar. É mais seguro e cobre mais casos. Uma busca por "cafe" vai encontrar "café", "cafe", "CAFÉ" e assim por diante, desde que a normalização seja aplicada nos dois lados da comparação. Se o texto vai ser exibido para o usuário final, mantenha os acentos. Remover acentuação de nomes próprios, títulos ou conteúdo literário gera frustração imediata e parece amadorismo. O usuário não quer saber que você fez um processo de normalização por trás dos panos, ele quer ver o texto como espera ler. Em formulários e cadastros, a melhor prática é aceitar os dois formatos na entrada e padronizar na saída. Deixe o usuário digitar "cao" ou "cão" que o sistema normalize para a forma correta no banco. Isso reduz erros de preenchimento e evita rejeições desnecessárias. O downside é que você precisa de um mapeamento confiável, e não existe dicionário perfeito cobrindo todos os neologismos e nomes próprios. Mantenha uma lista de exceções manual para os casos mais frequentes no seu domínio.
Ferramentas úteis para quem trabalha com isso todo dia
Para normalização rápida sem programar, a biblioteca ICU (International Components for Unicode) é o padrão da indústria. Ela está disponível para Java, C++, Python e JavaScript. O Unicode Collation Algorithm dela lida com acentos de forma mais completa que qualquer regex caseiro. Para quem trabalha com planilhas, o Power Query do Excel tem função de normalização de texto nativa. A função Unicode.Normalize(Text, Form) resolve o problema sem precisar sair da ferramenta. Não é perfeito para todos os casos, mas cobre a maior parte do uso cotidiano. Se o problema for conversão de arquivos inteiros, o comando iconv do Linux e macOS faz a troca de codificação de forma eficiente. iconv -f WINDOWS-1252 -t UTF-8 input.txt > output.txt resolve a maioria dos problemas de arquivos herdados.
A realidade é que palavras com acentuação parecem um problema simples até você se deparar com um dataset mal codificado de três milhões de registros. A solução não é difícil, exige apenas atenção aos detalhes de codificação e normalização desde o início do projeto, não como correção tardia.
Galeria
-
Atividades de Português com Acentuação Gráfica para Imprimir -

12 Atividades com Acentuação Gráfica para Imprimir - Online Cursos ... -

Acentuação gráfica: regras, exemplos, Novo Acordo - Português
