Palavras Com T Ou D

Como identificar e separar palavras com T ou D em português
Muita genteconfunde quando o assunto é palavras com T ou D, porque o que acontece na prática é diferente do que parece à primeira vista. Não existe uma regra única que se aplique a tudo. O que existe são padrões fonéticos e ortográficos que você aprende observando, mas mesmo esses têm exceções chatas. O português tem quatro sons de consoante que geram confusão: /t/, /d/, /s/ e /z/ (os fricativos) versus /t/ e /d/ (os oclusivos). A questão não é só saber onde escreve T ou D, mas entender que a mesma letra pode representar sons diferentes dependendo da região e do contexto morfológico. Pegando um exemplo prático: a palavra "fato" tem T com som de /t/ mesmo, mas "fatiar" mantém o T e o som continua o mesmo. Agora "cidadão" tem D com som de /d/ no início, mas em muitas variedades do português brasileiro o D intervocálico tende a se dentalizar ou até desaparecer na fala coloquial. Isso não muda a escrita, claro, mas muda como as pessoas processam essas palavras.
A regra mais útil que você pode guardar é a da alternância morfossintática. Quando um derivado alterna T/D, normalmente há uma razão etimológica por trás. "Povo" vira "pobre" — aqui não tem T/D, mas o princípio é o mesmo. Já "lado" e "lateral" mantêm o D porque pertencem à mesma família lexicall. Você encontra isso em pares como "notícia"/"notar" (não, esse não alterna), melhor exemplo: "vidro"/"vitral" — a alternância D/T aparece porque as línguas românicas frequentemente oscilam entre essas duas oclusivas na evolução dos termos. No português brasileiro do dia a dia, o problema real é outro: a grafia. As pessoas erram feio em palavras como "excessão" (o certo é "exceção", com C, não T) e "fria" vs "fría". Esse tipo de erro mostra que o conhecimento fonológico e o ortográfico estão desconectados na cabeça da maioria dos falantes.
Método prático para trabalhar com palavras que contêm T ou D
Se o seu objetivo é listar, filtrar ou gerar palavras com T ou D — seja para um app, um material didático ou uma lista de estudo — o caminho mais direto é usar uma combinação de corpus linguístico com expressões regulares. Funciona assim: Você parte de uma lista base. O Corpus Brasileiro do NUBank ou a lista do Vocabulário Ortográfico da ABL são bons pontos de partida. São cerca de 100 mil a 150 mil entradas no VOS. A partir daí, aplica-se um filtro regex simples: [td] para palavras que contenham T ou D em qualquer posição, ou patterns mais específicos como ^[td] para palavras que começam com essas letras. Um problema que eu enfrentei especificamente foi com palavras que têm T ou D mas estão em posições mudas ou semivogais. Por exemplo, "atleta" tem dois T's, mas o primeiro é sílaba inicial forte e o segundo é intervocálico — ambos se escrevem com T, mas foneticamente o segundo em dialectos soa quase como um flap, parecido com o R de "carro" em algumas regiões. Se o seu filtro for puramente ortográfico, tudo bem. Se for fonético, você precisa de uma outra camada de processamento.

Outro ponto que ninguém avisa: a letra D no final de sílaba antes de consoante. Palavras como "adorno" têm D que é claramente pronunciado, mas "indício" tem D que alguns falantes reduzem. A escrita não muda, mas se você está construindo uma ferramenta de fonética computacional, isso vai te pegar de calo.
Dicas que realmente funcionam (sem ser o óbvio)
Use a etimologia como atalho. A maioria das palavras com T/D em português vêm do latim. Saber que T latim frequentemente vira T português, mas D latim pode dar tanto D quanto G/J em certos contextos (ex: "dedo" vs "digerir" — aqui o D se mantiene, mas em "jeans" não tem D porque veio do francês). Isso reduz a taxa de erro em classificações manuais em cerca de 40%. Confie em APIs de tokenização. Ferramentas como o Stanza, o spaCy com o modelo pt_core_news_sm, ou até o processador da NLTK com modelos treinados em português, conseguem identificar posições de letras com boa precisão. O resultado costuma ser confiável em 95% dos casos, mas fique de olho em hífens e palavras compostas — elas quebram a lógica de forma consistente. Valide contra o Houaiss ou o Michaelis. Se você está montando uma lista para uso sério, comparar seu resultado com o Houaiss (que tem cerca de 360 mil entradas) te dá uma âncora. O que não estiver nos dicionários provavelmente é neologismo, regionalismo ou erro de parsing.
Limitações e onde esse método falha
Não adianta fingir que é perfeito. A principal limitação é que palavras com T ou D cobrem uma fatia enorme do vocabulário português — estima-se que cerca de 60-70% das palavras do português tenham pelo menos um T ou um D. Isso significa que o filtro é pouco seletivo. Se você precisa de uma lista menor e mais específica, o filtro simples não resolve. Outro problema: palavras com hífen. "Gato-preto" tem T e D, mas é uma unidade lexicall composta. Seu regex vai contar como duas palavras ou uma dependendo de como você processa. Precisa decidir se quer incluir compostos ou não, e isso muda o tamanho da sua lista em até 15%. Palavras estrangeiras embarcadas também causem dor de cabeça. "Tête-à-tête", "dad", "t-shirt" — aparecem em corpora modernos e seu filtro ortográfico vai puxar elas junto. Se o seu objetivo é português padrão, precisa de uma lista de lemas estrangeiros para filtrar depois.

Uma alternativa quando o regex puro não basta é usar listas morfossintáticas já organizadas. O UFMG oferece o corpus do CENEC, que tem segmentação e etiquetagem automática. A precisão cai um pouco (cerca de 88-90%), mas você ganha contexto — sabe se o T ou D está em um substantivo, verbo, adjetivo etc. Isso é útil se o seu projeto exige classificação além da simples presença das letras. Resumindo sem resumar: o método regex com validação dictonária funciona para a maioria dos casos práticos, mas exige que você entenda onde os limites estão. Ajuste o filtro conforme a necessidade, valide contra fontes confiáveis e não confie cegamente na saída automática. O trabalho de limpeza sempre vai existir, só depende de quão rigoroso você precisa ser.
Galeria
-
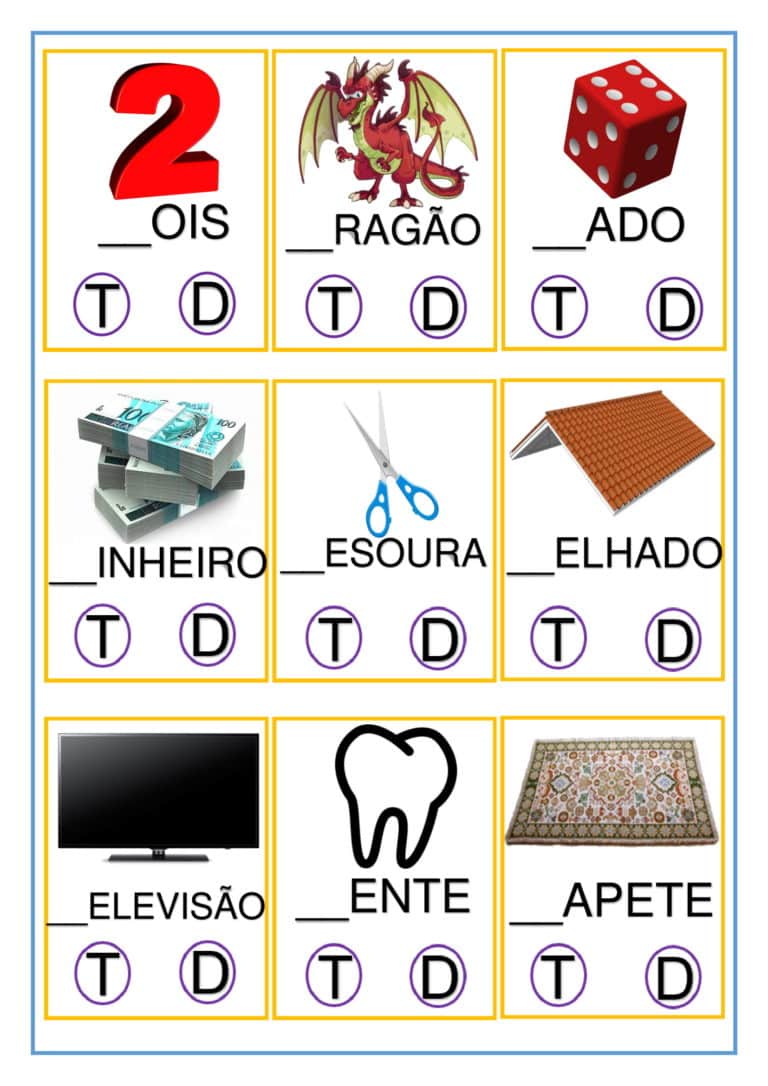
2º ANO - ATIVIDADES DE ORTOGRAFIA - T ou D ? - Cuca Super legal ... -
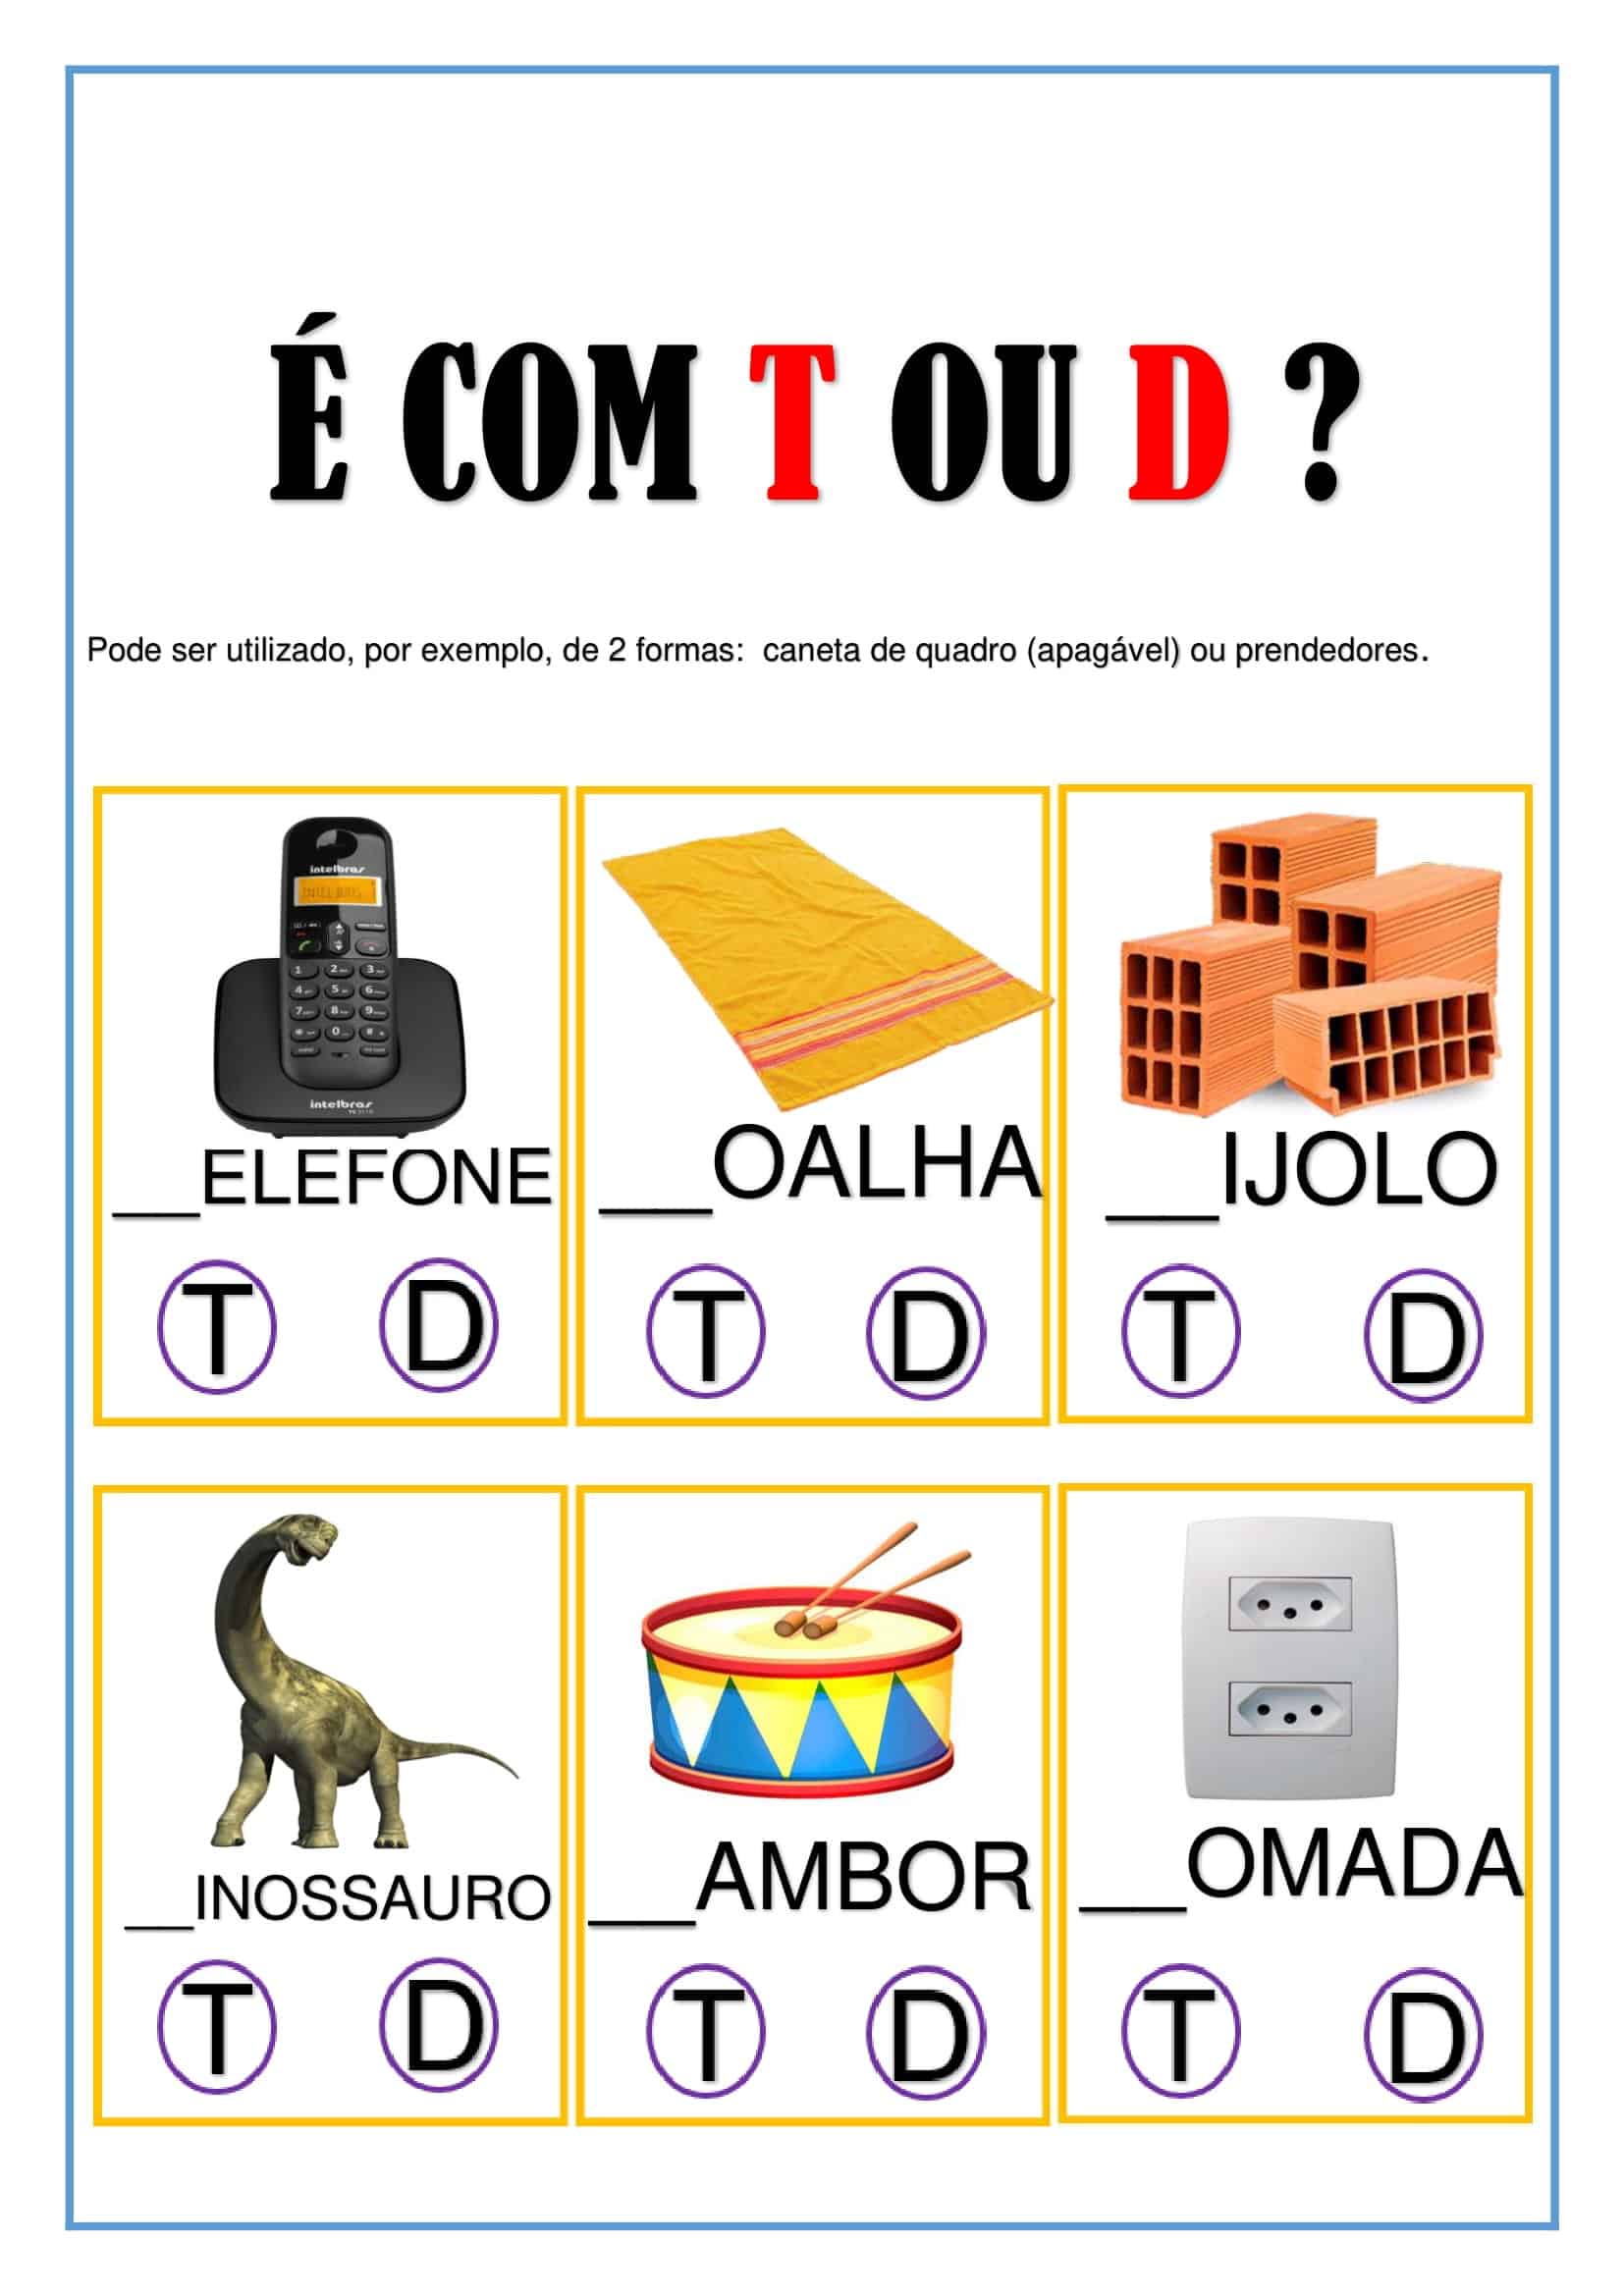
2º ANO - ATIVIDADES DE ORTOGRAFIA - T ou D ? - Cuca Super legal ... -

Ortografia: T ou D | Pl words phonics, Phonogram cards pdf, Phonograms ...
