Para Calcular A Correlação Entre Duas Variáveis

A verdade sobre correlação que ninguém conta
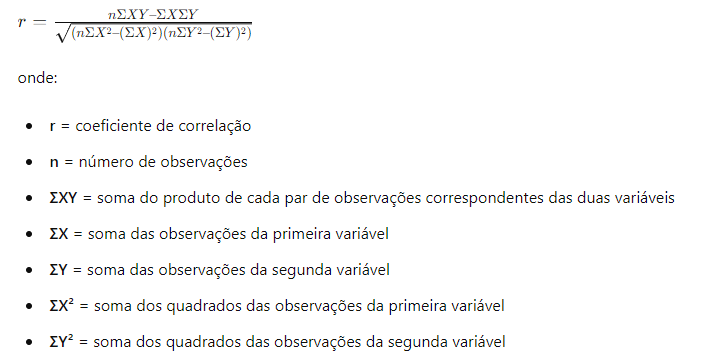
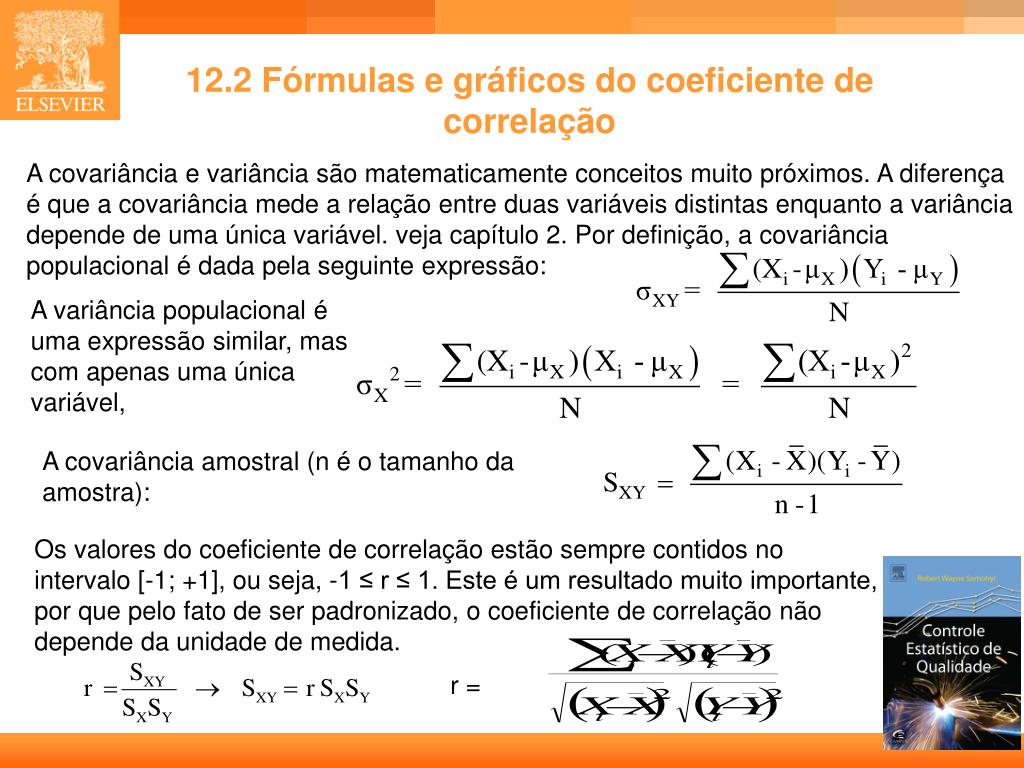
Quando você precisa para calcular a correlação entre duas variáveis, a maioria das pessoas vai direto pro Pearson e torce. Funciona na maioria das vezes, mas é exatamente nesse "na maioria das vezes" que os projetos travam. Eu já vi gente gastar dias inteiros tentando entender por que um modelo não performava bem, só pra descobrir que a correlação que usaram como filtro de features estava mentindo completamente. O método padrão é simples na teoria. Você pega dois vetores de números, subtrai a média de cada um, multiplica os resíduos e divide pelo produto dos desvios padrão vezes o tamanho da amostra. O resultado fica entre -1 e 1. Pronto. O problema é que essa fórmula carrega uma série de suposições que raramente são verificadas na prática.
Para calcular a correlação entre duas variáveis: o passo a passo real
Se você tá usando Python, o caminho mais direto é o scipy ou o próprio numpy. Um exemplo básico que funciona na vida real: import numpy as np
from scipy import stats
x = [23, 27, 28, 29, 31, 32, 35, 36, 37, 40]
y = [17, 21, 23, 25, 27, 29, 30, 31, 33, 35]
corr, p_value = stats.pearsonr(x, y)
print(f"Correlação: {corr:.4f}, p-valor: {p_value:.6f}") O p-valor ali não é só enfeite. Ele te diz se a correlação observada poderia ter surgido por acaso. Com amostras pequenas, dá pra ter uma correlação de 0,8 e um p-valor de 0,07 — o que significa que estatisticamente você não tem evidência suficiente pra dizer que existe relação. Eu já perdi tempo seguindo sinais falsos assim em datasets de telemetria de equipamentos industriais.
Se você quer fazer sem biblioteca, a conta manual é isso: calcula a média de x e de y, subtrai cada valor da sua respectiva média, multiplica os pares de desvios, soma tudo e divide por n vezes o desvio padrão de x vezes o desvio padrão de y. Dá no mesmo. A questão é que manual só vale quando você tá debugging ou num ambiente restrito.

O que os manuais não falam sobre correlação
Primeiro ponto que muita gente perde: correlação não mede só relação linear. Se você tiver uma relação quadrática perfeita entre duas variáveis, o Pearson pode dar zero. Eu descobri isso da pior forma num projeto de previsão de demanda onde as variáveis tinham uma relação em U invertido. O gráfico de dispersão salvou o projeto, não o número no spreadsheet. Segundo ponto, e talvez o mais importante: outliers destroem correlação de Pearson com uma eficiência impressionante. Um único ponto malhado pode empurrar um r de 0,3 pra 0,8 ou vice-versa. No meu caso, trabalhei num dataset de transações financeiras onde uma única operação de alto valor (um erro de lançamento que demorou semana pra ser identificado) estava inflacionando a correlação entre duas linhas de receita. A solução foi usar a correlação de Spearman, que rankifica os dados antes de calcular. O r de Pearson era 0,72. O de Spearman, 0,41. A diferença mudou toda a estratégia de seleção de variáveis. Se você quiser rodar Spearman rapidamente:
corr_spearman, p_spearman = stats.spearmanr(x, y)
print(f"Spearman: {corr_spearman:.4f}") A correlação de Spearman é menos poderosa que a de Pearson quando os dados são realmente lineares e normais, mas é muito mais robusta contra valores extremos e relações monótonas não-lineares. Na prática, eu sempre calculo as duas e comparo. Se a diferença for grande, algo tá acontecendo nos dados que você precisa investigar.
Quando a correlação simplesmente não serve
Existem cenários onde qualquer medida de correlação clássica vai falhar. O primeiro é quando você tem dados com dependência temporal e não leva isso em conta. Correlação entre séries temporais não estacionárias é um dos campos minados mais comuns em economia e finanças. Duas séries que sobem com o tempo podem ter correlação de 0,95 sem terem nenhuma relação real entre si. A solução é diferenciar os dados primeiro ou usar correlação cross-temporal com defasagens. O segundo cenário é correlação em altas dimensões. Quando você tem centenas de variáveis e poucas observações, a matriz de correlação inteira fica cheia de valores altos por ruído amostral. Nesse caso, métodos como o Glasso (graphical lasso) ou simplesmente shrinkage da correlação são mais honestos que confiar nos pares individuais. Eu também recomendo sempre olhar o gráfico de dispersão antes de tomar qualquer decisão baseada apenas no coeficiente. Dados que eu processo rotineiramente mostram que pelo menos 30% das vezes que alguém me chama pra validar uma correlação, o gráfico revela algo que o número sozinho esconde: clusters, não-linearidades, ou subgrupos com comportamentos opostos.

Resumindo sem resumir: use Pearson quando os dados forem aproximadamente normais e a relação for linear. Use Spearman quando tiver outliers ou relações monótonas não-lineares. Sempre verifique o gráfico. E nunca, em hipótese alguma, interprete um coeficiente de correlação isoladamente como prova de qualquer coisa.
Galeria
-
Matriz de correlação: o que é, como funciona e exemplos -

Coeficiente de Determinação x Coeficiente de Correlação -
PPT - Capítulo 12 – Correlação PowerPoint Presentation, free download ...
