Pensar Na Diferença Entre Os Dados E As Informações
Por que você continua confundindo dados com informações no dia a dia
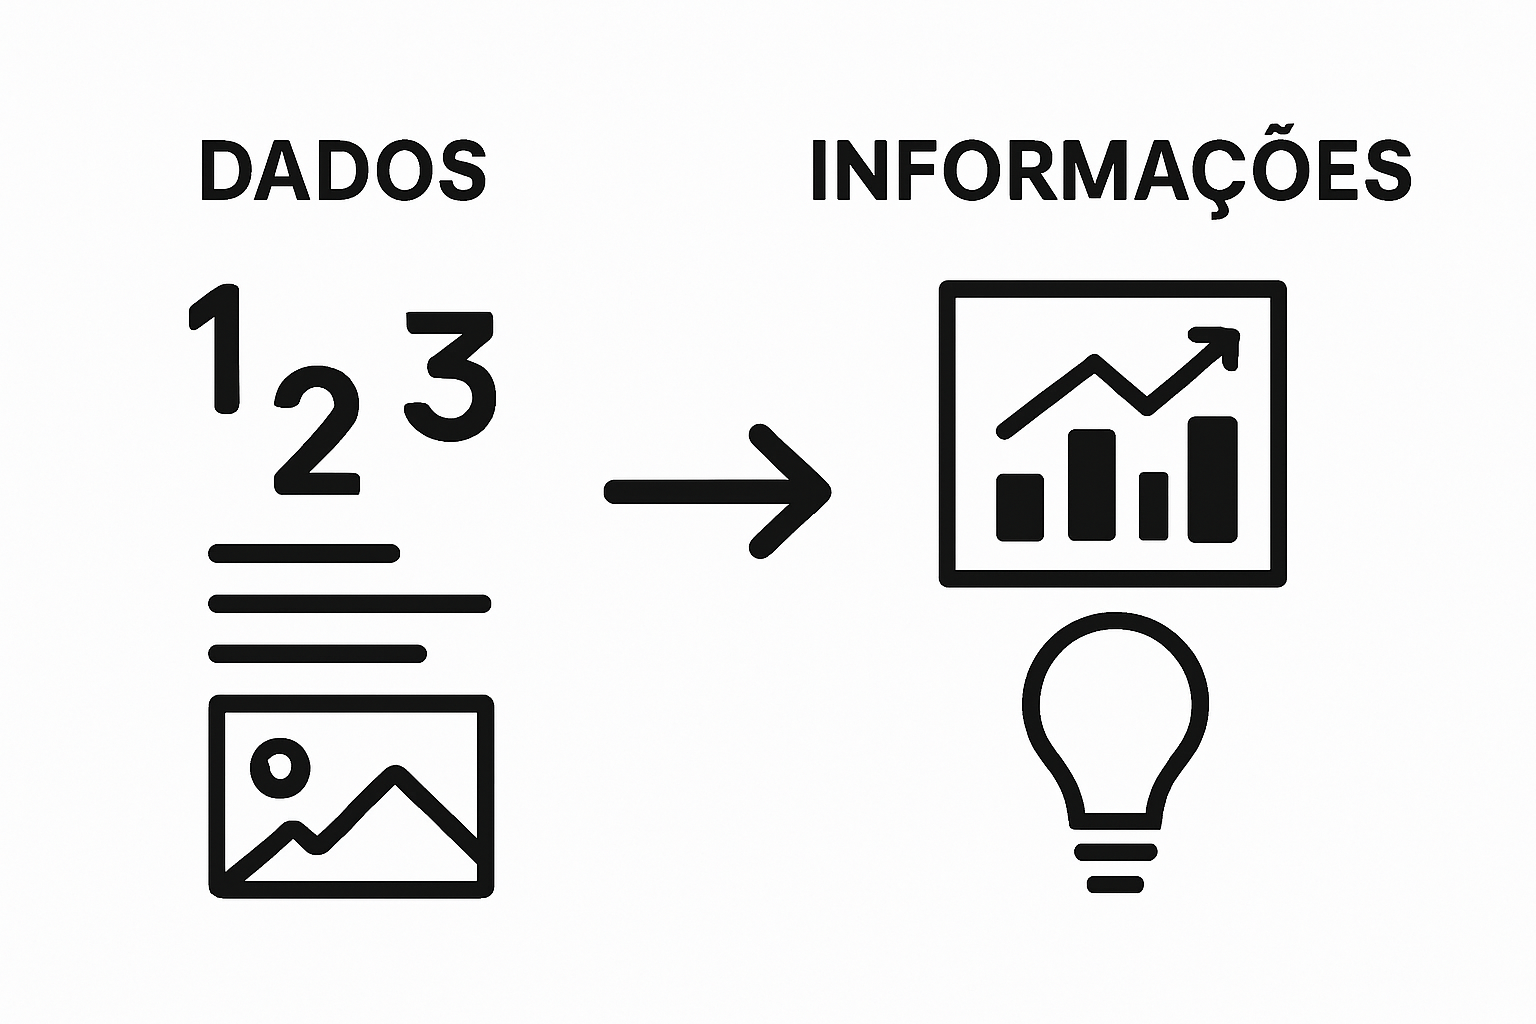
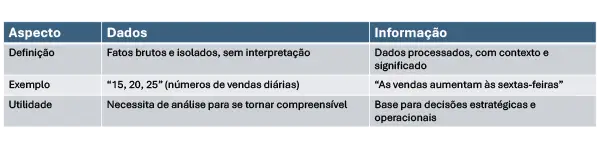
Eu vi um relatório de vendas chegar na minha mesa com mais de 40 mil linhas de CSV. O chefe achava que aquilo era informação. Era um arquivo cru, sem filtro, sem agregação, sem contexto. Levei duas horas pra transformar aquilo em algo que alguém conseguisse ler. Esse é o problema real que a maioria das pessoas não percebe: dados e informações não são a mesma coisa, e tratar como se fossem gera trabalho desperdiçado. Dado é um símbolo isolado. Um número, uma string, um timestamp. "2024-03-15" sozinho não comunica nada. "47" sozinho também não. Informações são dados que já passaram por um processo de estruturação, interpretação e contexto. Quando eu leio que "a equipe X vendeu 47 unidades no terceiro trimestre de 2024, representando aumento de 12% sobre o trimestre anterior", isso já é informação. O dado foi coletado, relacionado, calculado e posto em perspectiva.
A diferença real quando você pensa na diferença entre os dados e as informações
O erro mais comum que eu vejo na prática é gente acumulando dados achando que estão construindo inteligência. Eles fazem dashboard depois de dashboard, mas todos os gráficos mostram números brutos sem transformação. Um relatório que mostra "total de visitas ao site por dia" durante doze meses é um conjunto massivo de dados. Um relatório que mostra "visitas orgânicas vs. pagas, com taxa de conversão e custo por aquisição comparados ao trimestre anterior" é informação. A diferença não é estética. É estrutural. Existe um conceito que poucos mencionam e que muda completamente como você trata pipelines de dados: granularidade vs. agregação. Dados tendem a existir na granularidade máxima da fonte. Informações existem em níveis de agregação que fazem sentido para a decisão. Se você tem dados de transações em nível de item (cada linha de um pedido), isso é utilíssimo para um analista de engenharia. Para um diretor comercial, esses dados são ruído. A informação para o diretor seria o valor médio por sessão de compra, segmented por canal, com benchmark histórico. Outra armadilha que eu vejo constantemente: dados bem formatados não são informações automaticamente. Já trabalhei num projeto onde migramos todos os registros de clientes de um sistema legado para um data warehouse, com validação de integridade referencial, schema normalizado em terceira forma normal, tudo certinho. Sete meses depois, o time de produto ainda não conseguia responder perguntas simples tipo "quantos clientes inativos voltaram a comprar nos últimos 90 dias". O problema não era a qualidade dos dados. Era a ausência de transformações que gerassem significado. tínhamos dados impecáveis e informações zero.
Eu tenho uma forma prática de verificar se algo é dado ou informação, e é simples demais pra maioria das pessoas seguirem. Eu pergunto: essa thing responde a uma pergunta que alguém precisava responder para tomar uma decisão? Se sim, é informação. Se não, é dado, não importa o quão bonito seja o formato. Um log de acesso com ip, timestamp, user-agent e url acessada é dado. Um log que mostra "78% dos acessos vêm de mobile, sendo 43% de páginas que levam mais de 4 segundos para carregar, com taxa de rejeição de 67%" é informação. A diferença é que a primeira linha exige que alguém leia e interprete. A segunda já tomou esse caminho. Temos ferramentas como Python com pandas, SQL com CTEs e window functions, Spark para escalona maior. A escolha da ferramenta é secundária. O que importa é o estágio de transformação. Dados entram, passam por limpeza, enriquecimento, agregação, relacionamentos e contextualização, e saem como informações. Pular etapas gera o que eu chamo de "informação illusion" — parece útil porque tem formatação, mas não carrega significado operacional. Um exemplo prático do dia a dia. Eu estava analisando churn de assinatura e o time de marketing tinha um relatório que mostrava "cancelamentos por mês". Parecia informação. Era apenas dado com cor no gráfico. Eu peguei os dados e cross-referenciei com: tempo de análise, plano contratado, tickets de suporte abertos nos 30 dias anteriores, e frequência de uso nas duas semanas antes do cancelamento. A informação real que saiu disso foi: "clientes do plano anual que abriram ticket técnico e não tiveram resolução em 48 horas têm probabilidade 3,2x maior de cancelar no mês seguinte". Isso mudou a prioridade de SLA do suporte. O relatório original não.
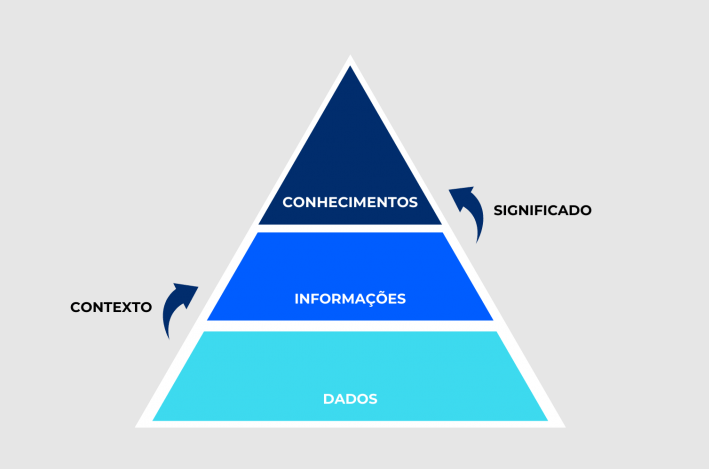
A parte que ninguém conta: o custo de transformar dados em informação não é só técnico. É humano. Você precisa saber qual pergunta está sendo respondida antes de construir a transformação. Eu já perdi dois dias montando dashboards complexos porque alguém pediu "análise de desempenho" sem especificar se era desempenho de vendedores, de produtos, de campanhas ou de canais. Quando eu perguntei, a resposta foi "tudo". Aí começa o trabalho de verdade. Definir nível de detalhe, granularidade temporal, métricas derivadas e, principalmente, o que não incluir. Há cenários onde dados brutos realmente são o produto final. Logs forenses, auditorias, compliance. Nesse caso, a gravação intacta é o requisito. Mas mesmo nesses casos, há uma camada de metadados que transforma o arquivo em informação: hash de integridade, timestamp de coleta, fonte, responsável pela captura. Sem isso, você tem um arquivo. Com isso, tem um registro que pode ser usado como evidência. O problema com ferramentas de BI modernas é que elas tornam a transformação tão fácil que as pessoas param de pensar no que está acontecendo. Arrasta e solta campos, gera visualização, publique. O resultado é um painel com dezenas de gráficos que ninguém sabe como interpretar em conjunto. Eu recomendo que antes de abrir qualquer ferramenta, você escreva em uma frase a pergunta que aquela informação precisa responder. Se não conseguir escrever a pergunta, você não está trabalhando com informação, está organizando dados bonitos.
Outro ponto cego: o ciclo de vida da informação. Dados podem ser armazenados para sempre. Informações têm validade. Uma métrica de engagement calculada com base em eventos de clique perdeu valor significativo após uma atualização da plataforma que mudou o comportamento de navegação. Dados permanecem. Informação precisa ser recalculada. Eu vi equipes manterem relatórios mensais com indicadores obsoletos por oito meses porque "o relatório já estava pronto e aprovado". Os dados continuavam válidos. A informação havia virado ruído. Para quem quer aplicar isso na prática, o fluxo mínimo que funciona é: coleta de dados brutos, validação básica de integridade, aplicação de contexto (quem, quando, por quê), agregação conforme a pergunta, e validação com quem vai usar. Se você pular o passo de validação com o usuário final, esteja certo de que vai precisar refazer. Meu tempo economizado passando a fase de definição com stakeholders antes de qualquer transformação costuma ser de 40% a 60% do esforço total do projeto. Se você trabalha com Python, a biblioteca pandas resolve a maior parte das transformações de dados para informação. Estruturas como DataFrames permitem operações de groupby, merge, pivot e agregação que são exatamente o que separa dado de informação. SQL com agregações e subconsultas faz o mesmo nível de trabalho em ambiente enterprise. Não existe ferramenta mágica que faça isso automaticamente porque a definição do que é informação depende sempre de uma pergunta humana, não de um algoritmo.
A conclusão que eu deixo é simples e não tem graça: pare de acumular dados esperando que informação apareça sozinha. Comece pela pergunta. A informação é apenas dado que alguém já fez o trabalho sujo de dar sentido. E esse trabalho sujo é o que separa um relatório que enche a sala de reunião de um que toma uma decisão.

Galeria
-
Diferença entre Dados e Informação | PDF -

Qual a diferença entre dados e informação? Entenda -
Diferença entre Dados e Informação: Conceito e Exemplos

