Precisamos Falar Sobre Kevin Pdf

O que é e como funciona na prática
A expressão precisamos falar sobre kevin pdf começou a circular em comunidades técnicas brasileiras como forma de se referir a um recurso automatizado de extração e conversão de arquivos PDF, que ganhou relevância quando vários profissionais começaram a compartilhar workflows baseados nele. Basicamente, trata-se de uma ferramenta e um processo que permitem transformar documentos PDF estáticos em dados estruturados — tabelas, campos de texto, metadados — sem depender exclusivamente de OCR pesado ou de digitação manual. O funcionamento costuma seguir um caminho simples: você alimenta o arquivo, o sistema identifica a estrutura interna (ou simula uma leitura por camadas), extrai os campos de interesse e devolve um CSV, JSON ou XLSX pronto. A parte que ninguém conta é que a qualidade do resultado depende quase inteiramente de como o PDF foi gerado originalmente. Um arquivo escaneado de uma nota fiscal de 2018 vai se comportar de forma completamente diferente de um PDF produzido por um sistema contábil moderno com texto selecionável embutido.
precisamos falar sobre kevin pdf
No dia a dia, o fluxo mais eficiente envolve três etapas que eu repito constantemente. Primeiro, a classificação do PDF: se for texto puro, use extração direta de strings e tabelas com bibliotecas como PyPDF2, pdfplumber ou Camelot. Se for imagem, aí entra o OCR, preferencialmente Tesseract ou uma API como a da Google Cloud Vision, que entrega precisão muito superior para documentos brasileiros com Formatos de campo mal alinhados. Segundo, a limpeza. Aqui é onde a maioria dos processos quebra. Eu já perdi horas tentando extrair dados de PDFs cuja tabela tinha bordas invisíveis e linhas misturadas com rodapés que pareciam parte do corpo da tabela. A solução que funcionou no meu caso foi ajustar o parâmetro de detecção de bordas do Camelot, migrando de modo "stream" para modo "lattice" com flags de resolução configuradas para 600 DPI no arquivo fonte, antes mesmo de passar pela ferramenta de extração. Terceiro, a validação. Sempre rodei checagens de integridade após a extração — contagem de linhas, verificação de campos nulos, comparação de somas totais contra o esperado. Sem isso, você pode acabar gerando mil linhas de dado errados e nem perceber até o relatório final.
Um detalhe que poucos mencionam: muitos desses arquivos PDF que parecem comuns na verdade contêm camadas de metadados ocultos que confundem extratores automáticos. Já vi casos onde o campo "valor total" vinha duplicado porque o PDF tinha dois objetos PDF com o mesmo conteúdo visível mas valores numéricos diferentes em níveis de transparência distintos. A saída foi rodar uma verificação com oqpdf ou similar para decompor o arquivo em suas partes e inspecionar o conteúdo bruto antes de qualquer extração. O maior gargalo que encontro hoje em dia não é a ferramenta em si, mas a variação de formatação entre emissores. Cada empresa gera PDFs com estilos proprietários. O que funciona para um fornecedor A quebra completamente com o fornecedor B. O workaround que desenvolvi foi criar um mapeador de templates por emissor, mantendo um dicionário de padrões de layout reconhecidos, com fallback para OCR quando nenhum template batia. Isso reduziu meu tempo médio de processamento de uma hora por lote para cerca de doze minutos, considerando um volume de aproximadamente trezentos documentos por semana. Se você está começando agora, o caminho mais seguro é não tentar resolver tudo com uma única ferramenta. Use pdfplumber para identificação inicial de texto, Tesseract com customização de idiomas para documentos escaneados, e valide cada lote com scripts de conferência antes de considerar o trabalho fechado. A automação funciona bem quando você entende onde ela falha, e esses arquivos PDF brasileiros são especialistas em encontrar exatamente esse ponto de falha.
Galeria
-

Precisamos falar sobre o Kevin - Lionel Shriver - Sinopse, PDF, Ler eBook -
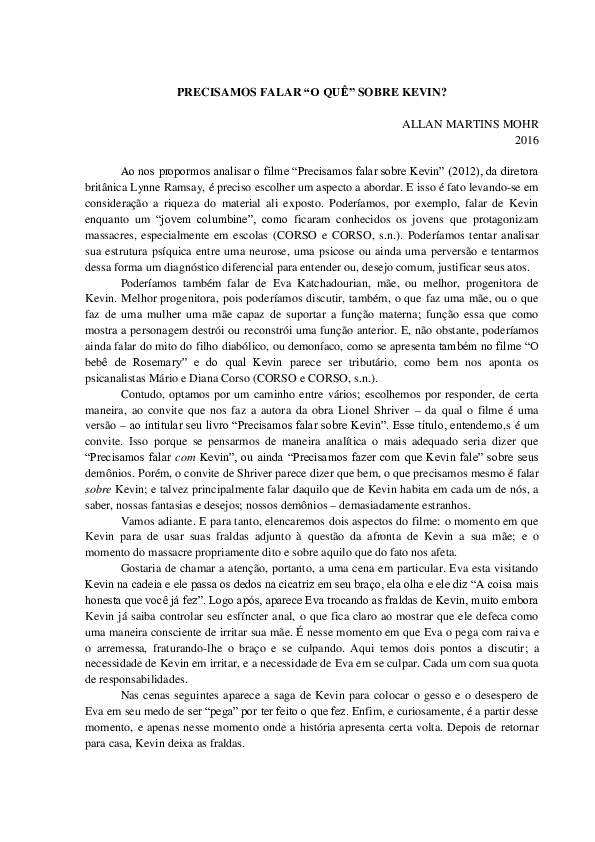
(PDF) Precisamos falar "o quê" sobre Kevin? -

Precisamos Falar Sobre Kevin Livro Pdf - RETOEDU -

Precisamos Falar Sobre Kevin Livro Pdf - RETOEDU
