Principais Cruzadas
Entendendo o cruzamento de dados na prática
O termo principais cruzadas se refere à operação básica de correlacionar duas ou mais variáveis em uma tabela para identificar padrões que não são visíveis olhando para cada coluna isoladamente. Parece simples porque é simples, mas a forma como você implementa isso faz toda a diferença quando lida com arquivos grandes ou variáveis com muitos níveis.Vou falar de como isso funciona no dia a dia, sem teoria desnecessária.
O que são principais cruzadas e como aplicar
Na prática, um cruzamento cria uma tabela de contingência onde cada linha representa os valores de uma variável e cada coluna os valores de outra. A interseção mostra a contagem ou porcentagem dos casos que combinam aqueles valores específicos. Eu comecei a trabalhar com isso em 2014, em uma empresa de pesquisa eleitoral. A primeira vez que fiz um cruzamento manualmente no Excel, cruzei faixa etária com intenção de voto em uma planilha com 45 mil linhas. O Excel travou. Demorou nove minutos para abrir de novo, se é que abriu. Desde então, aprendi a tratar isso de forma diferente. Hoje, a abordagem que uso envolve três passos. Primeiro, organizo os dados de forma que cada variável de cruzamento seja uma coluna categórica limpa, sem espaços extras ou valores inconsistentes. Segundo, uso ferramentas que suportam agregação nativa, seja SQL com GROUP BY, Python com pandas, ou R com dplyr. Terceiro, valido os totais antes de interpretar qualquer padrão.Um detalhe que as pessoas ignoram: sempre verifique a soma marginal. Se os totais não batem, algo está duplicado ou faltando nos dados antes mesmo de você cruzar.
Implementando cruzamentos eficientemente
A forma mais direta hoje em dia é usando Python com a biblioteca pandas. Ela permite criar tabelas de contingência com uma única linha de código usando crosstab ou pivot_table. Aqui vai um exemplo real do que eu uso: import pandas as pd df = pd.read_csv('dados_pesquisa.csv') tabela = pd.crosstab(df['idade_faixa'], df['regione'], margins=True) print(tabela) Isso gera uma tabela com contagens absolutas e marginais automaticamente. Se quiser porcentagens dentro de cada linha, adiciona normalize='index'. Para porcentagens dentro de cada coluna, usa normalize='columns'. Normalizar por tudo dá normalize='all'.A diferença entre usar crosstab e pivot_table é que pivot_table permite múltiplas funções de agregação ao mesmo tempo, enquanto crosstab é mais limitado mas mais rápido para tabelas simples.
Pegadinhas que ninguém conta
A primeira pegadinha é o tratamento de valores ausentes. pandas e R contam NaN como uma categoria separada em alguns contextos, mas não em outros. Eu já perdi duas horas num projeto porque os totais não fechavam e descobriu que 12% dos responses tinham região como string vazia em vez de NULL. O cruzamento simplesmente não mostrava essas linhas em nenhuma categoria. A solução foi rodar df['regiao'].value_counts(dropna=False) antes de qualquer cruzamento para mapear exatamente o que existia nos dados. Outra pegadinha comum é o que chamamos de sparse crossover, onde algumas combinações de variáveis têm zero ou quase zero observações. Isso distorce porcentagens. Se você tem 3 pessoas na categoria "18-24 anos" na região "Centro-Oeste" e todas votaram em tal candidato, a porcentagem vai mostrar 100%, mas é estatisticamente insignificante. Minha regra prática: nunca interpretar porcentagens baseadas em menos de 30 observações. Abaixo disso, o ruído domina o sinal.Existe também o problema da multiplicidade de comparações. Quanto mais cruzamentos você faz, maior a chance de encontrar padrões que são puro acaso. Se você cruza 50 variáveis entre si, vai encontrar pelo menos uma correlação aparentemente significativa só por sorte. Use correção de Bonferroni ou ajuste de Holm quando fizer múltiplos testes simultâneos.
Limitações reais do método
Cruzamento de dados mostra associações, não causalidade. Isso é óbvio para quem conhece estatística, mas muitas vezes quem pede a análise não sabe. Já vi relatórios serem usados por gestores para tomar decisões baseados em cruzamentos que mostravam apenas correlações espúrias. Outra limitação importante: cruzamentos tradicionais funcionam bem com variáveis categóricas, mas ficam problemáticos com variáveis contínuas. Dividir uma variável contínua em faixas é arbitratío e perde informação. Nesse caso, melhor usar regressão ou análise de correlação contínua. Um terceiro problema é a dimensionalidade. Cruzar três variáveis já dobra o tamanho da tabela. Cruzar quatro ou cinco pode gerar centenas de células, muitas vazias. A interpretação manual vira tarefa inviável. Quando você passa de três variáveis, o ideal é usar visualizações interativas ou reduzir a dimensionalidade com técnicas como MCA (Análise Correspondências Múltiplas).Alternativas quando o cruzamento não basta
Se seus dados têm muitas categorias ou você precisa controlar variáveis de confusão, considere modelagem estatística em vez de apenas cruzamentos. Uma regressão logística multinomial ou um modelo lineal generalizado vão te dar resultados mais robustos do que tabelas de contingência para inferência causal. Para datasets enormes com centenas de milhares de linhas e dezenas de variáveis, ferramentas como Apache Spark com DataFrames ou até mesmo Power BI com Power Query podem ser mais eficientes do que pandas, dependendo do seu setup.Existe ainda a possibilidade de usar bibliotecas especializadas como cmat (Cross-Tabulation Matrix Analysis) em R, que oferece estatísticas adicionais automaticamente, como teste qui-quadrado, índice de Yule, e odds ratios para cada célula da tabela.
Principais cruzadas: resumo prático
O que funciona na maioria dos casos: limpar os dados antes, validar totais marginais, ignorar células com menos de 30 observações, e não confundir correlação com causalidade. Ferramentas como pandas, SQL e R cobrem 95% das necessidades. O resto depende do tamanho do dataset e da complexidade das variáveis envolvidas. Se você está começando agora, a dica mais útil é: não confie no que vê na primeira tabela. Sempre cheque os totais, sempre note quantas observações sustentam cada porcentagem, e quando estiver em dúvida, repita o cruzamento com dados limpos e vej se o padrão se mantém. Padrões que somem com uma pequena alteração nos dados não são padrões, são ruído.Galeria
-

As Cruzadas, Motivo, O Que Foram, Principais As Cruzadas – ICWT -

História das Cruzadas Sem Ideologias - Entenda em Detalhes -
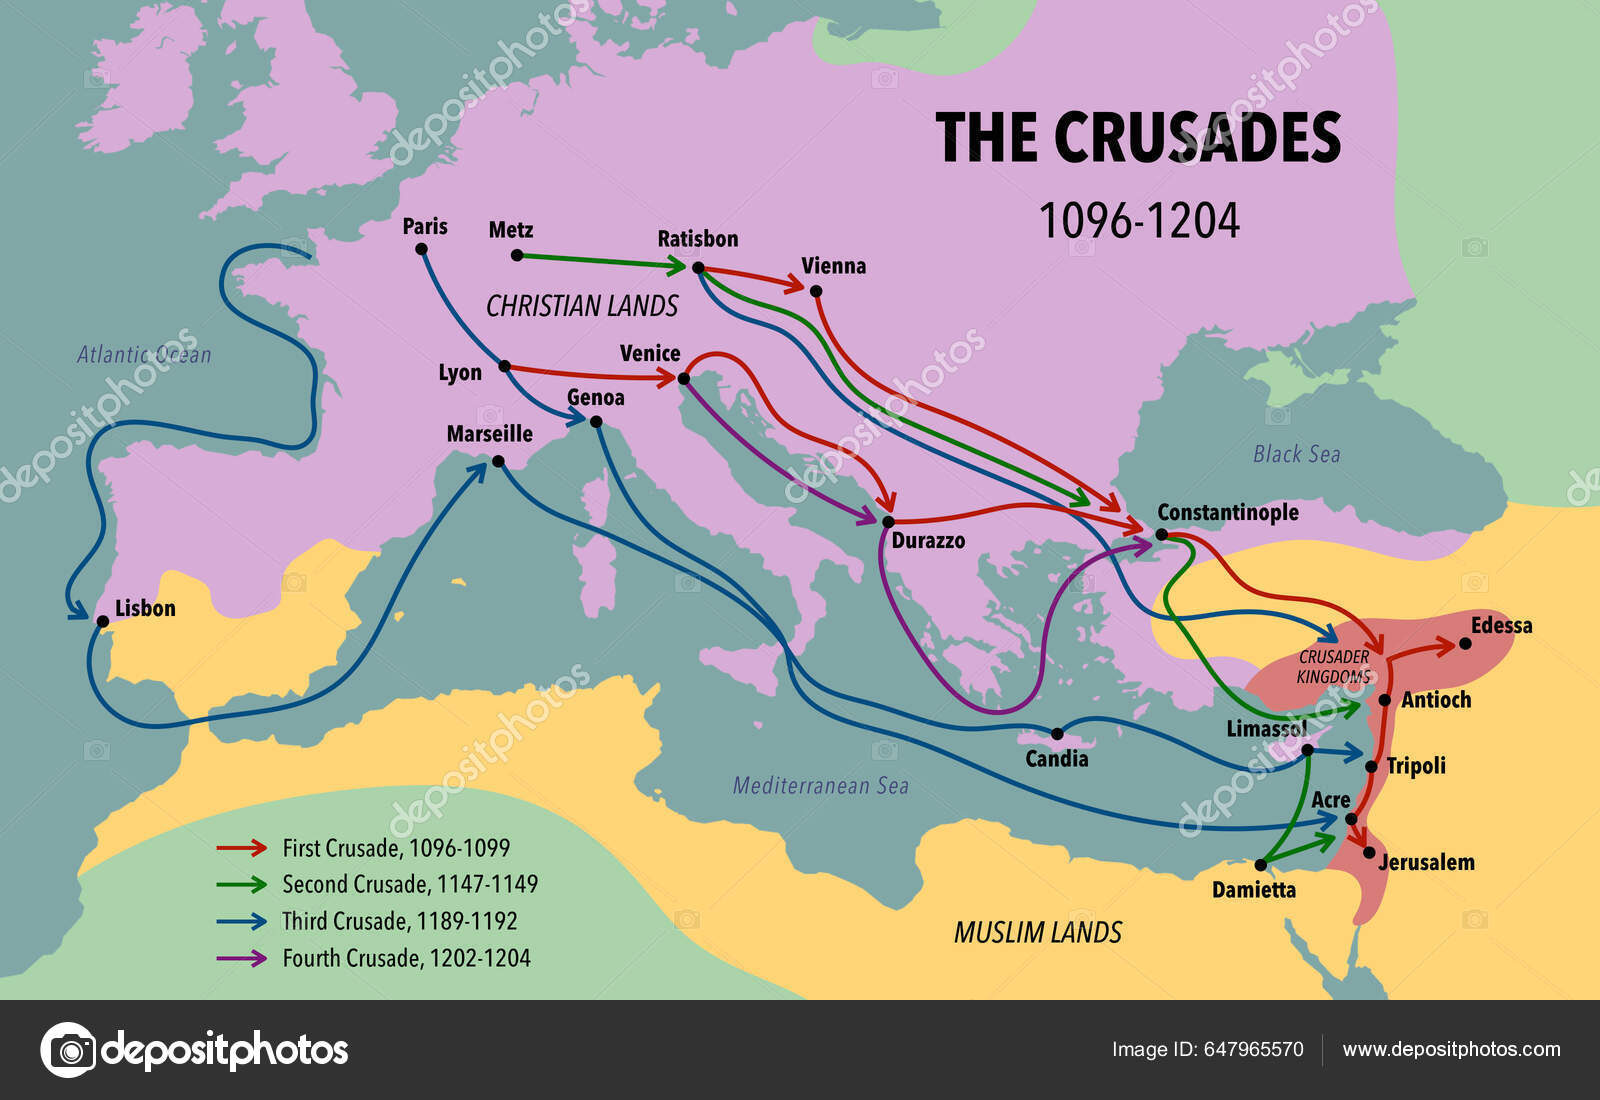
Mapa Das Primeiras Cruzadas -
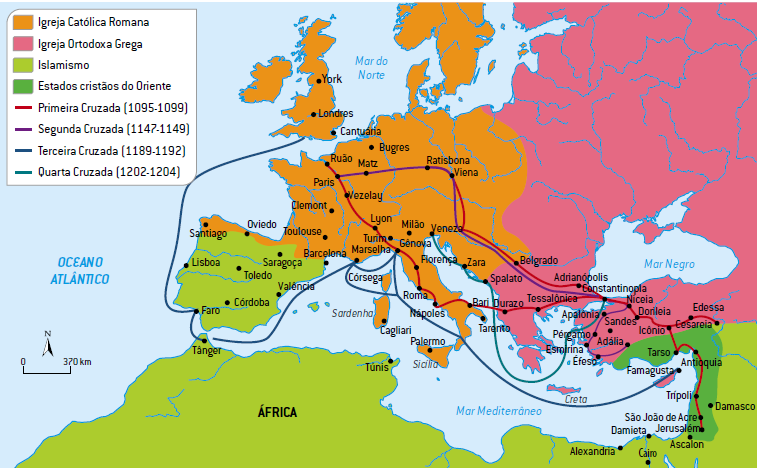
As Cruzadas - Objetivos, Causas e Consequências - Cola da Web
