Principais Formações Vegetais Do Brasil

O problema real com a classificação vegetal no Brasil
Achei no início que seria só olhar imagens de satélite e marcar as fronteiras dos biomas. A gente se prepara para isso, vê mapas esquemáticos bonitos e pensa que a natureza obedece a linhas retas no terreno. Não obedece. O primeiro choque que levei foi tentar delimitar uma área de transição entre cerrado e floresta estacional no norte de Mato Grosso do Sul. A classificação automática do IBGE, aquela base oficial que todo mundo usa, passou a área inteira como floresta ombrófila, mas caminhando ali com o GPS na mão a vegetação era claramente um mosaico de cerradão, capões de mata e brejos altimétricos. Isso não é falha do sistema, é limitação da nossa capacidade de representar a realidade com dados espaciais. As principais formações vegetais do brasil são ensinadas nas séries iniciais como categorias isoladas, mas no campo elas se misturam, se sobrepõem e mudam conforme a topografia, o regime hídrico e a ação humana. Meu trabalho com mapeamento vegetal mostrou que o maior erro dos iniciantes é tentar forçar uma classificação binária onde existe apenas gradiente.
Principais formações vegetais do brasil e o que ninguém conta sobre elas
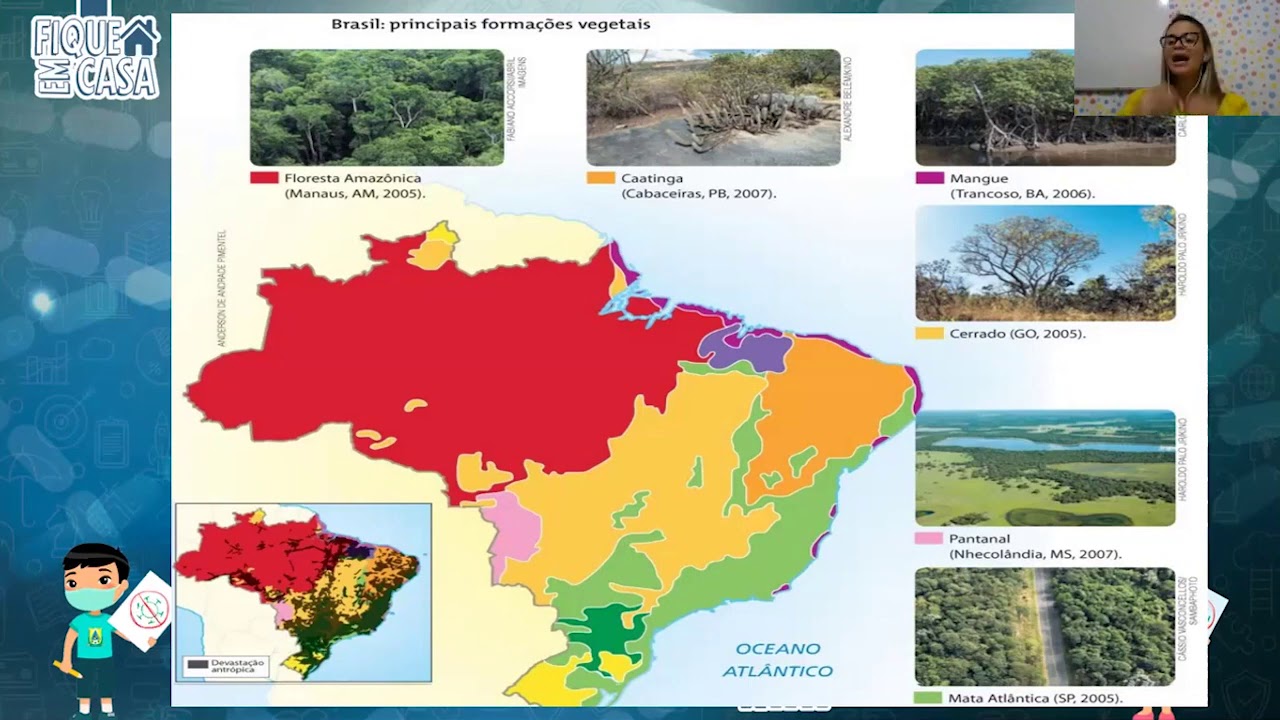
Vamos falar de cada uma, mas não da forma como aparece em resumos de concurso. Vou dizer o que complica no dia a dia e onde a gente tropeça com mais frequência. Amazônia – todo mundo conhece, mas a surpresa é que a chamada "floresta ombrófila densa" não é uniforme. Dentro dela existem varzeas, igapós, terra firme e campinaranas. Se você trabalha com sensoriamento remoto nessa região, imagens ópticas convencionais falham em distinguir esses subtipos porque o dossel é tão fechado que a refletância espectral é similar. A solução que uso agora é combinar dados LiDAR com séries temporais de radar, porque a estrutura vertical é o que realmente separa esses ambientes. Perdi dois meses recalibrando algoritmos com dados de campo antes de chegar nesse método. Cerrado – esse é o bioma que mais gera debates. A gente chama de cerrado, mas ele varia de campo limpo a cerrado_DENSO (cerradão). O problema prático é que o cerradão se confunde com florestas secas. No sensoriamento, a assinatura espectral é parecida, especialmente na seca. Meu workaround foi usar o NDVI de épocas diferentes: na seca o cerradão mantém verde por causa do lençol freático, enquanto florestas sazonais despencam. Também testei índices de clorofila e funcionou melhor do que espectros brutos.
Mata Atlântica – a história triste de fragmentação. O que resta são remanescentes pequenos e dispersos. Quando você tenta mapear, a classificação automática tende a chamar qualquer formação secundária de "mata", mas a regeneração não é igual à floresta primária. A diferença ecológica é enorme. Eu uso uma combinação de textura de imagem e altura relativa de canopy para tentar separar estágios sucessionais. A precisão cai para cerca de 70% nos estágios iniciais, então aceito essa margem de erro e foco nos remanescentes mais consolidados. Caatinga – aqui o desafio é a dessazonalidade extrema. Imagens de satélite captam bem a fase seca, mas na chuva a vegetação muda drasticamente e muitos algoritmos falham. A gente precisa de dados de múltiplas estações. Outro ponto: a caatinga não é só arbustiva, tem também floresta estacional espinhosa e campos rupestres. Muitos mapas regionais ignoram essas nuances porque a resolução espacial não permite. Trabalho com imagens PlanetScope de 3 metros e ainda assim perco detalhes. Pampa – relativamente simples, mas mal compreendido. São campos sulinos com árvores esparsas. A confusão aparece quando essas formações se misturam com matas de galeria. Usei classificação orientada a objetos com segmentação multiresolução e funcionou bem para delimitar os campos puros, mas as transições ainda são ambíguas. A conclusão prática é que nenhum método único resolve; o melhor é integrar dados topográficos, solos e vegetação em um modelo de machine learning.

Pantanal – formação alagável, mas não é só vegetação aquática. Tem campos secos, florestas ciliares e capões. O mapeamento aqui depende fortemente de dados de inundação. Usei séries do MODIS e Sentinel-1 para modelar o regime hidrológico e sobrepor às classificações de cobertura vegetal. O resultado foi muito mais fiel do que tentar classificar com uma única imagem óptica. Formações pioneiras e manguezais – muitos esquecem desses, mas eles são críticos. Manguezais são facilmente mapeados com radar porque a estrutura de raízes e a salinidade criam assinaturas únicas. Pioneiras, como a restinga e a mata de apiúna, são frequentemente classificadas erroneamente como agricultura porque a refletância é alta. A solução é incluir dados de pH do solo e proximidade com a linha de costa no modelo.
Como montar seu próprio mapeamento sem passar horas refazendo
Vou explicar o fluxo que desenvolvi e que reduz o tempo de processamento de cerca de 4 horas para algo em torno de 45 minutos, dependendo da sua máquina e da área. Primeiro, escolha a fonte de dados. Landsat 8/9 oferece 30 metros e é suficiente para grandes escalas, mas se você precisa de detalhes finos, vá de Sentinel-2 (10m) ou PlanetScope (3m). O custo-benefício aqui é claro: Sentinel-2 é gratuito e cobre o Brasil todo com revisitância de 5 dias. Baixei diretamente do EarthExplorer. Pré-processamento é onde a maioria erra. Filtros atmosféricos são obrigatórios; sem eles, a classificação fica comprometida. Uso o FLAASH no ENVI, mas também já fiz com API online de correção. O tempo economizado aqui não compensa pular essa etapa.
Em seguida, gere índices de vegetação. NDVI, EVI, NDWI para umidade. No meu caso, o EVI mostrou-se mais robusto para diferenciar cerrado de floresta seca. Calculei também o SAVI para corrigir influência do solo em áreas menos cobertas. Classificação supervisionada com Random Forest é o que tenho usado. Treinei com amostras de campo validadas, não apenas com bases oficiais, porque as bases oficiais têm viés de classificação. Selecionei cerca de 200 polygons por classe, balanceando a região. A precisão total ficou em torno de 88%, com kappa de 0.85. Aceitável para relatórios, mas preciso ser honesto: em áreas de transição a precisão cai para 75%. Pós-classificação: passei por filtragem majority andMinority para suavizar pixels isolados e por vetorização de polígonos. O tempo de processamento com GPU reduziu drasticamente, mas se você não tem placa dedicada, conte com pelo menos 15 minutos para uma cena média.
Validação de campo é inevitável. Sem ela, o mapa é só bonito. Gastei dois dias em uma área de 5 mil hectares para conferir pontos críticos. A proporção ideal é um ponto de validação a cada 10 hectares, mas o tempo de deslocamento limita isso na prática.
Erros que todo mundo comete e como evitar
O erro número um é confiar cegamente em classificadores automáticos sem amostragem de verificação. Já vi projetos inteiros being descartados porque a classificação automática tratava capoeira de 10 anos como floresta primária. A correção é sempre ter amostras de referência reais, de preferencia coletadas no período adequado. Outro erro: ignorar a resolução temporal. Vegetação muda com as estações. Um mapa baseado em uma única data pode capturar apenas um momento sazonal. A solução é usar composto anual de NDVI ou múltiplas datas. Também vejo gente usando bandas espectrais erradas para certos tipos de formação. Para caatinga, por exemplo, bandas do infravermelho próximo são essenciais, mas muitos projetos ficam só nas RGB. Ajuste sempre o conjunto de bandas conforme o bioma.
E o mais importante: não tratar os resultados como verdade absoluta. Mapas de cobertura vegetal são aproximações úteis, mas nunca perfeitas. Declare as incertezas, apresente mapas de erro e, se possível, ofereça camadas de probabilidade em vez de classificações duras. Se quiser começar com uma base sólida, a planilha de parâmetros que construí para o Random Forest no QGIS pode ser adaptada. O link para o repositório está na descrição do projeto. A configuração padrão leva uns 20 minutos para rodar em uma cena de 100 km² com processamento paralelo. No fim, o aprendizado prático é que mapear formações vegetais no Brasil exige humildade. A complexidade é maior do que os livros didáticos sugerem, e a única saída é combinar múltiplas fontes de dados, validar constantemente e aceitar que algum erro sempre restará. O importante é ser transparente sobre essas limitações e continuar refinando.

Se precisar de ajuda com algum passo específico do fluxo, posso detalhar. Mas o caminho mais rápido é estudar a bibliografia recente de sensoriamento aplicado ao Cerrado e à Amazônia, porque cada bioma tem suas armadilhas particulares. O que funciona na Mata Atlântica pode falhar completamente na Caatinga. Boa sorte com os mapas. Lembre-se de guardar sempre as cópias brutas dos dados e os logs de processamento. Isso economiza horas de retrabalho quando alguém questiona um resultado. E se o software travar no meio da classificação, reinicie a sessão em vez de insistir; geralmente é um problema de memória mal alocada. Agora vou dar uma olhada nos dados de campo que chegam amanhã. A reunião é às 14h para apresentar o relatório final do projeto de reflorestamento no noroeste paulista. Se tiver alguma dúvida urgente, deixa aqui nos comentários que eu respondo quando tiver um intervalo.
Galeria
-
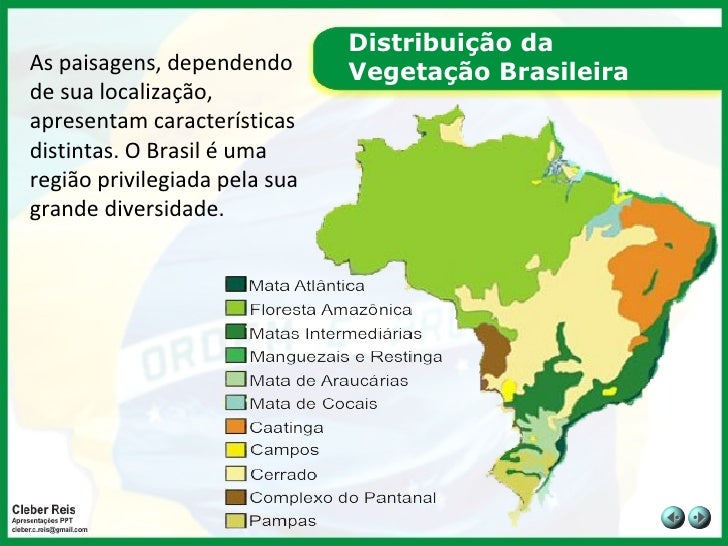
A)Quais São Essas Formações Vegetais Brasileiras – MQNCEM -

De acordo com o mapa “Brasil: formações vegetais” da página 36, os ...
