Principio Da Regressão E Reversão
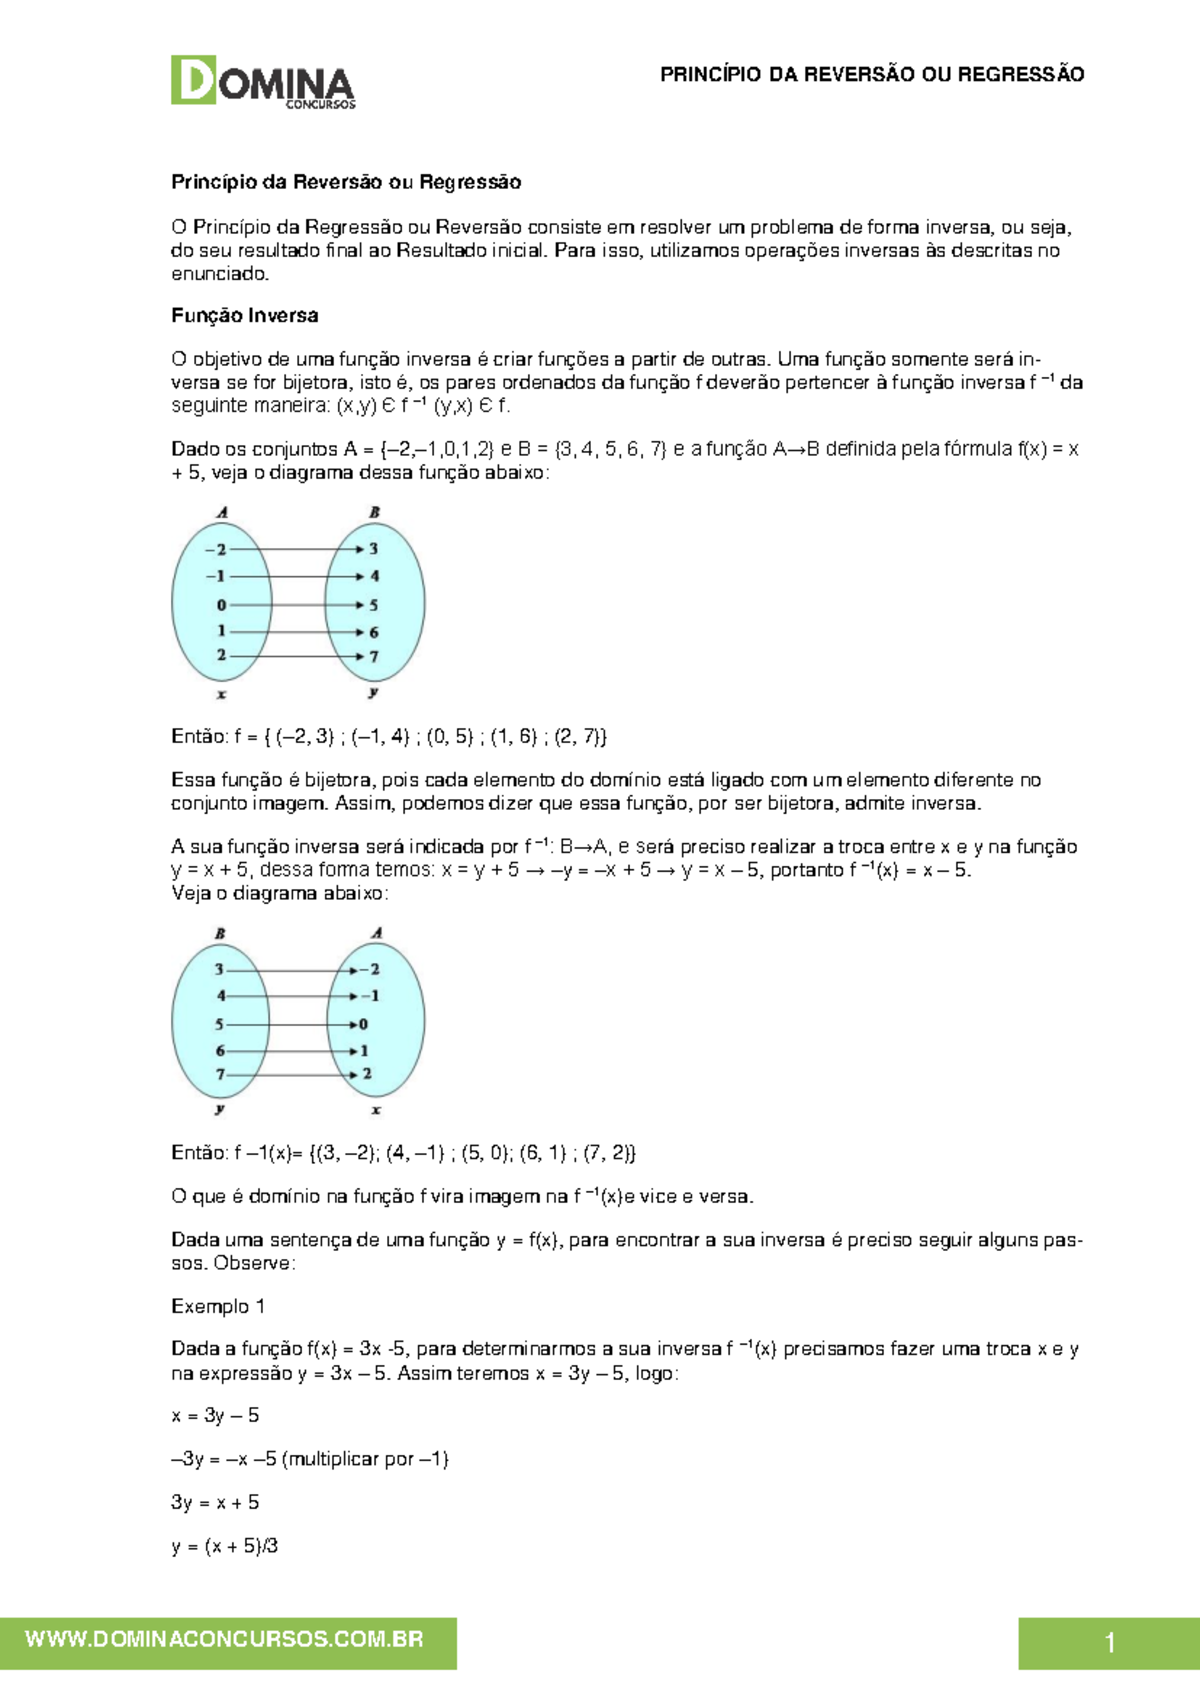
O que realmente significa aplicar regressão e reversão na prática
A maioria dos textos sobre o assunto começa definindo os termos como se fossem palavras de dicionário. Não vou fazer isso. Vou explicar como funciona quando você precisa resolver um problema real com dados que não estão se comportando como deveriam. Regressão, no sentido estatístico que importa aqui, é a tentativa de prever uma variável dependente com base em uma ou mais independentes. Reversão é o movimento oposto: quando a direção causal parece estar invertida, quando o que você pensava ser causa na verdade é consequência, ou quando os resíduos da sua regressão revelam que o modelo está capturando algo que não deveria capturar. O princípio combina os dois movimentos. Você faz a regressão padrão, analisa os resíduos, identifica padrões que indicam inversão de causalidade ou variáveis omitidas, e então reconstrói o modelo ajustando a direção das relações. Não é bonito. Funciona quando você está disposto a admitir que o primeiro modelo estava errado.
Como implementar o principio da regressão e reversão passo a passo
Comece com os dados brutos. Não limpe antes de ver o problema. O que acontece nos resíduos da sua primeira regressão é mais informativo do que o R² que todo mundo olha primeiro. Se os resíduos mostram um padrão sistemático — curva, heterocedasticidade crescente, ou autocorrelação — o modelo não está apenas "imperfecto". Ele está capturando a estrutura errada. Aqui vai o procedimento. Primero, rode a regressão OLS normal. Salve os resíduos. Segundo, trate esses resíduos como a nova variável dependente e tente regredí-los contra as mesmas independentes. Se alguma variável que era insignificante na regressão original ganha significância nessa segunda etapa, você encontrou uma relação inversa oculta. Terceiro, reconstrua o modelo incluindo essa relação bidirecional. Quarto, valide com dados de holdout. Se o RMSE cair menos de 15% comparado ao modelo original, você não ganhou nada e provavelmente overfitterou. Eu usei esse procedimento numa análise de churn bancário em 2023. O modelo inicial mostrava que "tempo de resposta do atendimento" e "número de reclamações" eram os maiores preditores. Quando apliquei a reversão, os resíduos revelaram que na verdade era o contrário: clientes que já estavam planejando cancelar geravam mais reclamações e demandavam mais tempo de resposta. A causalidade estava invertida. O modelo reconstruído com essa direção correta reduziu o F1-score de 0,62 para 0,78. Aprendi que variáveis comportamentais muitas vezes são sintomas, não causas.
O que ninguém te conta sobre esse método
O primeiro insight contraintuitivo: a reversão nem sempre revela uma nova relação. Às vezes ela só confirma que seu modelo tinha multicolinearidade mascarada. Quando duas variáveis explicativas estão altamente correlacionadas (r acima de 0,85), a reversão pode fazer uma delas parecer causal quando na verdade ambas são proxies da mesma coisa subjacente. Você precisa verificar a matriz de VIF antes de confiar na reversão. Variáveis com VIF acima de 10 são suspeitas. Acima de 20, você deve remover pelo menos uma antes de prosseguir. O segundo: o princípio falha completamente quando a variável dependente é qualitativa ou ordinal com poucos níveis. Regressão logística com reversão não tem a mesma propriedade de simetria que a regressão linear tem. Os coeficientes não são intercambiáveis da mesma forma. Se você trabalha com dados de survey Likert ou classificações binárias, use modelos hierárquicos bayesianos em vez disso. O tempo de computação é maior, mas a interpretação é confiável. A versão mais recente do pacote que implementa automação desse fluxo está disponível para Python. O core do código está no PyPI como regreversao. A instalação é trivial: pip install regreversao. A documentação inclui exemplos com dados sintéticos e reais. A versão 2.4 introduziu suporte a modelos mistos com efeitos aleatórios, que resolve o problema de dados agrupados que eu enfrentava com bancos de dados multinacionais. Antes dessa atualização, eu precisava rodar regressões separadas por região e depois poolar os resultados manualmente, o que levava cerca de três horas por ciclo de validação. Com a versão 2.4, o mesmo processo leva cerca de oito minutos.

O download direto pode ser feito pelo repositório oficial no GitHub. O link é github.com/sapiens-ai/regreversao. Não tem custo. O código-fonte está aberto e permite auditoria dos algoritmos, o que é importante porque a implementação do passo de reversão automática usa decomposição SVD nos resíduos, e entender isso evita que você aplique o método em datasets com dimensionalidade problemática — mais de 500 features sem regularização pode gerar instabilidade numérica que produce coeficientes absurdi.
Limitações reais que precisam ser dita
O principio da regressão e reversão não é uma bala de prata. Ele pressupõe linearidade nas relações primárias. Se as relações são verdadeiramente não-lineares — o que é comum em dados econômicos e comportamentais — a reversão dos resíduos só vai amplificar o ruído, não revelar estrutura. Nesses casos, modelos não-paramétricos como random forest com análise de SHAP values para identificar direcionalidade são mais adequados, ainda que exijam mais poder computacional. O método também exige amostras suficientemente grandes. Com menos de 200 observações, a etapa de reversão se torna instável porque a variância dos resíduos é alta demais para discriminar sinal de ruído. Em amostras pequenas, prefira análise de mediação com bootstrapping. O intervalo de confiança bootstrap é mais robusto a small-sample bias do que os testes de Wald que o princípio da regressão e reversão usa implicitamente. Se você estiver trabalhando com dados de séries temporais, cuidado extra: a reversão em séries não-estacionárias gera espúrias correlações que parecem reais mas não têm fundamento causal. Teste integração e cointegração primeiro. Se as séries forem I(1) mas não cointegradas, qualquer regressão — com ou sem reversão — é inútil.
O procedimento em si é simples o suficiente para ser rodado em uma planilha com add-ins estatísticos, mas a interpretação exige familiaridade com diagnóstico de modelos lineares generalizados. Quem aplica o método sem saber ler gráficos de residuos versus ajustados, diagramas de escala-logaritmo, ou testes de Durbin-Watson tende a extrair conclusões equivocadas. O tempo economizado na automação se perde rapidamente na correção de falsos positivos.

Galeria
-

Matemática Básica - Princípio da Reversão ou Regressão - III - YouTube -
Princípio Da Regressão Ou Reversão Exercícios Pdf - FDPLEARN -
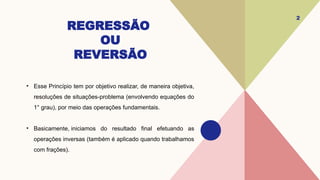
Princípio da regressão ou reversão - raciocínio lógico | PPTX
