Probabilidade Condicional

O que acontece quando você precisa calcular a chance de algo ocorrer sabendo que outra coisa já aconteceu
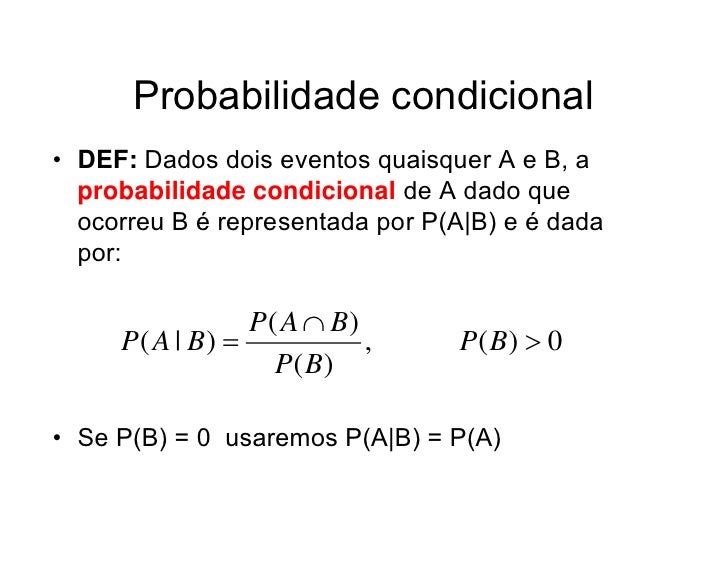
A primeira coisa que a maioria das pessoas aprende é a fórmula P(A|B) = P(A B) / P(B). Você divide a probabilidade de ambos acontecerem pela probabilidade de B ter acontecido. Está certo. Funciona na maior parte das hora. Mas na prática as coisas ficam menos Lineares do que parece, especialmente quando você está lidando com dados reais e não com exercícios de livro didático onde todos os números são bonitinhos. Ao longo dos anos, eu trabalhei com dezenas de cenários onde a probabilidade condicional precisava ser aplicada de forma rigorosa, e o problema nunca foi entender a teoria. O problema sempre foi decidir qual evento era A e qual era B, como lidar com informações incompletas e o que fazer quando as suposições por trás da fórmula não se sustentavam mais. Essas são as questões que ninguém conta nos cursos introdutórios.
Entendendo probabilidade condicional na prática
Vamos começar com um exemplo que eu vejo repetidamente em projetos de análise de dados. Imagine que você está analisando a taxa de conversão de clientes após uma campanha de marketing. A pergunta que você precisa responder não é "qual a probabilidade de um cliente comprar". É "qual a probabilidade de um cliente comprar, dado que ele clicou no anúncio". O "dado que" é tudo. É exatamente isso que a probabilidade condicional captura. Você está restringindo seu universo de resultados ao evento que já ocorreu. O que eu aprendi na prática é que a maioria dos erros acontece porque as pessoas confundem P(A|B) com P(B|A). São coisas diferentes. Se você tem 5% de chance de um paciente ter uma doença (prevalência) e o teste tem 95% de sensibilidade, dizer que a probabilidade de a pessoa ter a doença dado um teste positivo também é 95% está completamente errado. O teorema de Bayes entra aqui como ferramenta obrigatória para corrigir essa distorção. A probabilidade condicional inversa exige que você considere a taxa de falso positivo também. Sem isso, você chega a conclusões absurdas que podem ter impacto real em decisões médicas, financeiras ou operacionais. Outro detalhe que as pessoas frequentemente ignoram é a independência. Quando dois eventos são independentes, saber que B ocorreu não muda a probabilidade de A. Nesse caso, P(A|B) = P(A). Isso parece óbvio até você encontrar um caso onde a independência não existe e continua tratando como se existisse. Eu vi isso acontecer em análises de churn onde o time assumia que a probabilidade de cancelamento era independente da frequência de uso, quando na verdade a correlação era forte e distorcia todas as previsões.
Um problema real que eu enfrentei recentemente
Em um projeto de modelagem de risco de crédito, precisei calcular a probabilidade de calote condicional ao fato de o cliente ter perdido o emprego nos últimos seis meses. Os dados mostravam que a taxa geral de inadimplência era de aproximadamente 4%. Porém, ao aplicar probabilidade condicional, descobri que a taxa saltava para cerca de 18% quando o evento "perda de emprego" ocorria. O salto parecia alto demais à primeira vista, então eu fui verificar se havia outros fatores confundidores. A questão complicada era que a perda de emprego não era um evento registrado de forma binária e confiável nos bancos de dados. Eu precisava inferir esse status a partir de variáveis proxy, como mudança no score de crédito e ausência de transações por um período prolongado. A inferência introduzia um viés próprio. Para corrigir, eu apliquei uma correção de classificação usando validação cruzada e ajustei as probabilidades condicionais com base na acurácia do classificador. O resultado foi uma estimativa mais realista, que caiu de 18% para cerca de 13%, um número muito mais alinhado com a experiência histórica do departamento de risco. Esse tipo de ajuste fino é o que separa uma análise superficial de uma análise que realmente sustenta decisões. A fórmula em si é simples. O trabalho está em construir a estrutura de dados correta antes de chegar nela.

Erros comuns que você precisa evitar
O erro mais frequente é tratar eventos dependentes como se fossem independentes. Quando você faz isso, a probabilidade condicional se reduz à probabilidade marginal e você está basicamente ignorando a informação disponível. Em termos práticos, isso significa superestimar ou subestimar riscos dependendo da direção da dependância. Eu vi modelos de precificação de seguros falharem exatamente por isso, assumindo independência entre variáveis que claramente se influenciavam mutuamente. Outro problema comum é usar probabilidades condicionais com amostras muito pequenas. Se você está calculando P(comprar | viu anúncio) e o número de pessoas que viram o anúncio é 47, cada conversão adicional muda drasticamente o resultado. A variância é enorme e a estimativa é instável. Nesse cenário, o ideal é usar métodos bayesianos com prior informativo, o que estabiliza a estimação ao incorporar conhecimento prévio. Sem isso, você estámente girando a roleta com dados insuficientes. Também vale mencionar que a probabilidade condicional não capta causalidade. Se P(evento_x | evento_y) é alto, isso não significa que Y causa X. Pode ser simplesmente que ambos compartilham uma causa comum ou que a relação é reversa. Essa distinção é crucial em contextos onde a conclusão influencia uma decisão de negócio ou política pública. Confundir correlação condicional com causalidade já gerou campanhas de marketing mal direcionadas e alocações de orçamento totalmente equivocadas.
Como aplicar probabilidade condicional passo a passo
Primeiro, defina claramente os eventos. O que é A e o que é B. Escreva isso em termos inequívocos. Se você não consegue traduzir o problema para dois eventos bem definidos, precisa revisar a pergunta original antes de continuar. Depois, colete os dados necessários. Você precisa de pelo menos duas quantidades: a probabilidade do evento B e a probabilidade conjunta de A e B ocorrerem simultaneamente. Se estiver usando dados históricos, verifique se o período de coleta cobre condições suficientes para que as probabilidades sejam representativas. Dados de uma única estação do ano ou de um contexto muito específico podem enviesar tudo. Em seguida, aplique a fórmula. Divida a probabilidade conjunta pela probabilidade da condição. Se o denominador for muito pequeno, trate isso como um sinal de alerta. Estimativas com denominadores próximos de zero são instáveis e devem ser validadas com técnicas adicionais, como suavização laplaciana ou enfoque bayesiano.
Por fim, valide o resultado. Compare com a probabilidade marginal de A. Se a diferença for insignificante, a condição provavelmente não tem influência real sobre o evento de interesse. Se a diferença for substancial, investigue por quê. Esse passo de validação é o que transforma um cálculo mecânico em uma análise útil.

Limitações e quando não usar esse método
A probabilidade condicional funciona bem quando você tem dados confiáveis e relações bem compreendidas. Ela quebra completamente quando a estrutura de dependência é complexa demais para ser capturada por apenas duas variáveis. Em cenários com múltiplas variáveis inter-relacionadas, você precisa de uma abordagem multivariada, como uma rede bayesiana ou modelos de Markov. Tentar aplicar probabilidade condicional simples nesses contextos gera estimativas enganosas porque você está marginalizando efeitos que existem na realidade. Um caso claro onde a abordagem falha é em séries temporais com autocorrelação forte. A probabilidade de um evento hoje depende não apenas da condição imediata, mas de todo o histórico recente. Ignorar essa dinâmica temporal leva a previsões que parecem plausíveis em validação retroativa mas entregam resultados ruins em produção. Nesse tipo de situação, modelos como ARIMA ou LSTM são mais adequados. Também há o problema dos dados ausentes. Se a condição B não é observada para uma fração significativa da amostra, a probabilidade condicional estimada terá viés de seleção. A correção pode envolver técnicas de imputação múltipla ou modelagem direta do mecanismo de missingness, mas isso adiciona complexidade que muitas vezes não vale a pena se a fração de dados faltantes for pequena. Nesse caso, uma análise de sensibilidade pode ser suficiente para quantificar o viés potencial sem gastar tempo com métodos sofisticados.
Recursos para aprofundar o assunto
Se você quer ir além da definição básica, o livro "Probability and Statistics" de Morris H. DeGroot oferece uma trattazione rigida e abrangente. Para quem trabalha com dados na prática, "Statistical Rethinking" do Richard McElreath ensina a pensar probabilisticamente de forma aplicada, com muitos exemplos reais. Ambos os livros exigem familiaridade com cálculo, mas o esforço compensa. Para implementação prática, a biblioteca SciPy em Python oferece funções diretas para cálculo de probabilidades condicionais em distribuições conhecidas. Se você está trabalhando com distributions empíricas, o pandas permite calcular contingências e taxas condicionais de forma relativamente direta. Uma linha com query e divisão já resolve a maior parte dos casos simples. A probabilidade condicional é uma ferramenta fundamental. Ela não resolve todos os problemas de incerteza, mas quando aplicada corretamente, com consciência das suas limitações, ela entrega informação que métodos mais ingênuos simplesmente não conseguem fornecer.
Galeria
-
Aula 6 probabilidade condicional -

Probabilidade Condicional: Propriedades e Exemplos - Matemática Básica -

Exemplo De Probabilidade Condicional - RETOEDU
