Probabilidade Eventos

Como calcular probabilidade de eventos na prática
A gente começa com o básico porque muita gente pula essa parte e chega no fim com conta errada. Probabilidade de eventos é, resumidamente, a razão entre casos favoráveis e casos possíveis. Pronto. O resto é detalhe. Mas os detalhes são onde a coisa atrapalha. Antes de qualquer fórmula, entende isso: probabilidade eventos não existe no vácuo. Você sempre precisa definir o espaço amostral primeiro. Se você não sabe quais resultados são possíveis no seu cenário, toda conta que vier depois é lixo. Já vi gente calcular probabilidade de eventos para extratores de café usando um espaço amostral de 6 (número de sabores no cardápio). O espaço era 6 mas o problema era outro completamente. A conta deu 1/3 quando o certo era 1/12. Perdeu dois dias refazendo. A definição formal é P(A) = |A| / |S|, onde |A| é o número de elementos no evento A e |S| é o tamanho do espaço amostral. Isso vale para eventos equiprováveis. Se os resultados não têm a mesma chance de acontecerar, a coisa muda de figura e você precisa usar probabilidade condicionada ou distribuições específicas.
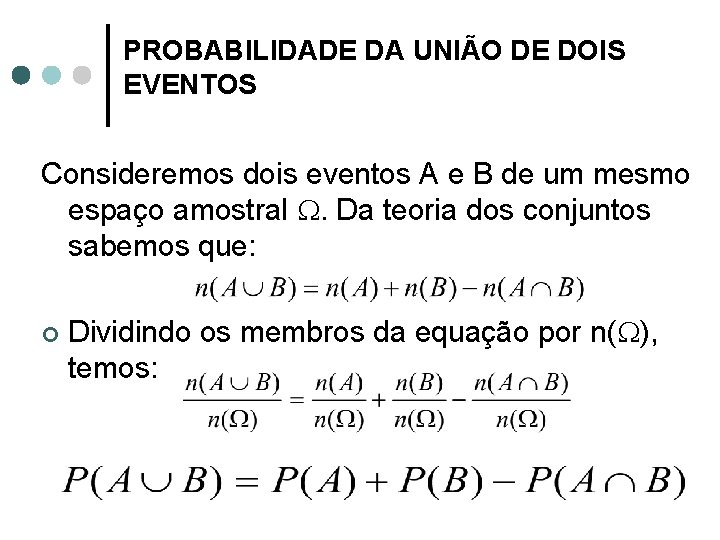
Eventos independentes multiplicam probabilidades: P(A e B) = P(A) × P(B). Eventos mutuamente exclusivos somam: P(A ou B) = P(A) + P(B). A armadilha clássica é confundir as duas situações. Todo mundo erra isso na primeira vez. Eu errei duas.
Método prático que eu uso
Aqui vai o passo a passo que eu sigo quando preciso resolver um problema real. Não é teoria de livro. É o que funciona no dia a dia. Passo 1: Identifique claramente o que é o evento. Anote isso em uma linha. Se não conseguir explicar em uma frase o que você está medindo, você ainda não entendeu o problema. Passo 2: Desenhe o espaço amostral. Pode ser uma lista, uma árvore, uma tabela. Depende do tamanho do problema. Para eventos com até 10 resultados, eu prefiro listar. Para mais que isso, tree diagram ou contagem combinatória.

Passo 3: Verifique se os eventos são equiprováveis. Isso é crucial. Dados não viciados, cartas bem embaralhadas, sorteios aleatórios. Se houver viés ou dependência, o método simples não funciona. Passo 4: Conte os casos favoráveis e os casos possíveis separadamente. Não misture. Anote cada contagem com uma breve justificativa. Quando você voltar pra revisar semana que vem, vai agradecer. Passo 5: Aplique a fórmula e verifique se o resultado faz sentido. Probabilidade sempre entre 0 e 1. Se saiu negativo ou maior que 1, erraram em algum passo anterior. Volte ao passo 2.
Um caso que me deu trabalho real
Eu estava analisando a probabilidade de falha em sequência de três componentes eletrônicos conectados em série. Cada componente tinha uma taxa de falha diferente: 0,02, 0,05 e 0,01. A leitura superficial diria pra somar tudo e dar 0,08. Errado. O sistema falha se QUALQUER componente falhar, não se todos falharem. O cálculo correto usa o complementar: P(nenhuma falha) = (1-0,02) × (1-0,05) × (1-0,01) = 0,98 × 0,95 × 0,99 = 0,9219. Então P(falha do sistema) = 1 - 0,9219 = 0,0781. Quase 8%, não 8%. A diferença parece pequena mas em produção em escala de 10 mil unidades significa 78 defeitos em vez de 800. O erro de soma simples teria te levado a superdimensionar o sistema de redundância em 10x. A lição prática aqui é: eventos em série (Qualquer um falha) usam complementar de produtos. Eventos em paralelo (Todos precisam falhar) usam produto direto. Confundir série com paralelo é o erro mais caro que eu já vi em projeto de confiabilidade. Custou duas semanas de retrabalho pro meu time num projeto de hardware.
Distribuições que você precisa conhecer
Binomial: quando você repete um ensaio de Bernoulli n vezes com probabilidade constante p. Exemplo clássico: probabilidade de obter exatamente k sucessos em n tentativas. Fórmula: C(n,k) × p^k × (1-p)^(n-k). Poisson: eventos raros em um intervalo fixo de tempo ou espaço. Útil quando n é grande e p é pequeno. A taxa média substitui a necessidade de conheceer n e p separadamente. P(X=k) = (^k × e^(-)) / k!. Normal: a rainha das aproximações. Quando você tem média e desvio padrão conhecidos, a curva gaussiana resolve boa parte dos problemas do mundo real. Regra prática: 68% dos dados dentro de ±1 desvio, 95% dentro de ±2, 99,7% dentro de ±3. Lembre-se que isso só vale para distribuição normal mesmo.

Hipergeométrica: quando você amostra sem reposição de um populacao finita. Diferente da binomial, a probabilidade muda a cada extração. Essencial em controle de qualidade com lotes pequenos.
Pegadinhas que ninguém avisa
A falácia do apostador é a mais comum. Acha que se saiu cara 5 vezes seguidas, coroa está "devida". Não está. Cada lançamento é independente. A moeda não tem memória. Já vi engenheiro perder dinheiro reais acreditando nisso numa roleta online. A casa sempre ganha porque a probabilidade não se corrige sozinha. Outra pegadinha: probabilidade condicional invertida. P(A|B) não é o mesmo que P(B|A). Uso médico é onde isso mata. Teste com 99% de precisão e prevalência de 0,1% de uma doença significa que, testando positivo, a probabilidade real de ter a doença é cerca de 9%, não 99%. Bayes resolve isso mas muita gente pula o passo. E o problema do aniversário: com apenas 23 pessoas num grupo, a probabilidade de dois fazerem aniversário no mesmo dia passa de 50%. O contra-intuitivo é que o espaço amostral cresce quadraticamente com o número de pessoas, não linearmente. 23 pessoas geram 253 pares possíveis. Isso explica porque hash collisions acontecem muito antes do esperado em criptografia.
Ferramenta prática
Eu uso uma planilha personalizada com as fórmulas já implementadas. Binomial, Poisson, Normal, Hipergeométrica, probabilidade condicional e teorema de Bayes. O custo de desenvolvimento foi cerca de 4 horas na primeira vez. O ganho é que cálculos que levariam 20 minutos manualmente ficam prontos em 30 segundos. Desde então, atualizei com funções para eventos dependentes e simulação de Monte Carlo básica quando a análise analítica não fecha. Se você quiser começar do zero, uma planilha simples com colunas para P(A), P(B), P(A|B) e P(B|A) já cobre 80% dos problemas cotidianos. Adicione uma aba separada por tipo de distribuição e você evita ficar consultando a Wikipedia toda hora.

Quando a teoria falha
Probabilidade clássica assume conhecimento completo do espaço amostral e equiprobabilidade quando aplicável. Na vida real, poucas coisas são verdadeiramente equiprováveis. Cartas embaralhadas por máquina não são perfeitamente aleatórias. Dados viciados existem. Populações humanas têm viéses sistêmicos que quebram a simetria assumida pelos modelos. Quando os dados empíricos contradizem a teoria, não desconsidere a teoria imediatamente. Primeiro verifique se você definiu o espaço amostral corretamente. Depois verifique se há dependência não declarada entre os eventos. Só então considere que o modelo pode não se aplicar. Para problemas complexos com múltiplas variáveis interdependentes, simulação de Monte Carlo é mais confiável que análise analítica. Gera milhões de cenários aleatórios e calcula a frequência relativa dos eventos de interesse. Leva de 2 a 5 minutos em uma máquina comum para problemas que seriam intratáveis na mão. O custo é confiar que o gerador de números aleatórios do seu software é adequado. Em condições normais, é.
O limite final é que probabilidade descreve tendências, não certezas. Um evento com probabilidade 0,001 pode acontecer. Um com 0,999 pode não acontecer. A ferramenta mostra o que é provável, não o que é inevitável. Trabalhar com isso exige disciplina para não confundir alta probabilidade com garantia. Eu levei dois anos aprendendo essa diferença. Espero que você não precise levar tanto tempo assim.
Galeria
-

PPT - PROBABILIDADE PowerPoint Presentation, free download - ID:4064979 -
Estatstica Aula 12 Probabilidade Prof Diovani Milhorim TEORIA
