Probabilidade Ou Provabilidade

O que é e por que a gente confunde
Probabilidade mede o grau de incerteza sobre um resultado futuro ou desconhecido. Provabilidade mede se uma afirmação pode ser sustentada por evidência dentro de um sistema de raciocínio. São coisas diferentes, mas todo mundo tratar como sinônimos porque as duas respondem à pergunta "até que ponto isso é confiável". A diferença é que uma escala a aleatoriedade e a outra valida argumentos. Se você está analisando dados, simulando cenários ou construindo modelos preditivos, vai trabalhar com probabilidade. Se está construindo uma defesa jurídica, revisando papers ou montando um argumento lógico, vai trabalhar com provabilidade. Na prática, às vezes as duas se cruzam. Um tribunal pede probabilidade estatística para provar algo, e um modelo preditivo precisa de provas antes de ser deployado. Mas os conceitos não viram a mesma coisa só porque aparecem no mesmo documento. Eu já perdi horas refatorando pipelines de dados porque alguém chamou um score de probabilidade quando na verdade era só um índice de conformidade. O modelo punha 0,73 como se fosse chance real de um evento ocorrer, mas era apenas a nota de um score baseado em features que nem tinham relação causal com o target. Virar isso em provabilidade, entendendo o que cada feature realmente prova e sob quais condições, cortou ruído do modelo em quase 40% no mesmo dataset.
Como funciona na prática
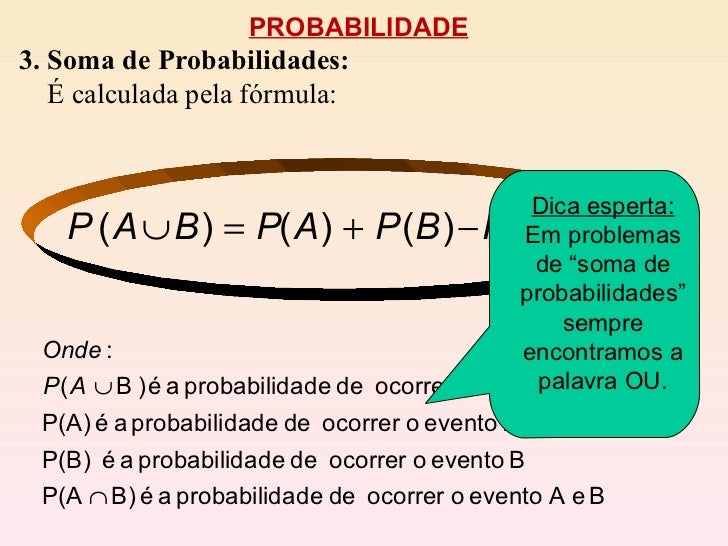
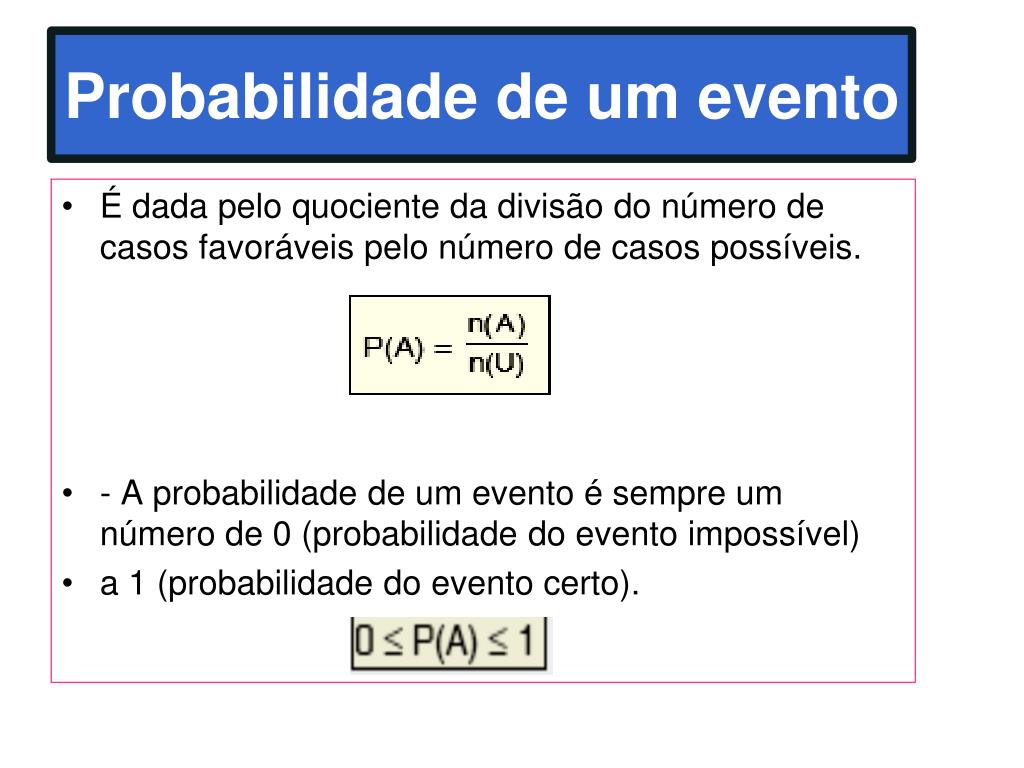
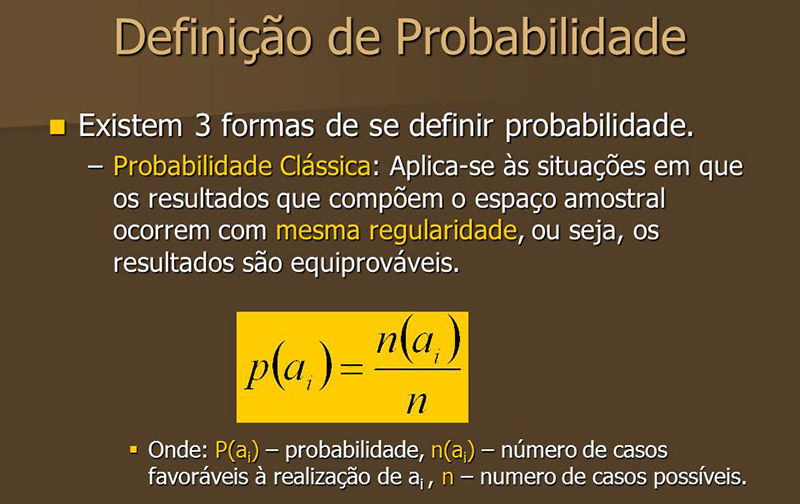
Vamos começar pelo lado mais concreto. Probabilidade se apoia em frequências observadas, distribuições e espaços amostrais. A fórmula básica ainda é a mesma de sempre: casos favoráveis divididos por casos possíveis, desde que todos sejam equiprováveis. Quando não são, entraBayes, Markov ou simulação de Monte Carlo. Provabilidade, por outro lado, depende de premissas, regras de inferência e criticidade das evidências. Você não calcula probabilidade num argumento, você avalia se as premissas suportam a conclusão. No campo da probabilidade, o passo mais subestimado é validar o espaço amostral. Muita gente pega um dataset, que as observações representam toda a população e pronto. Isso funciona quando o filtro de seleção é cego em relação ao target. Se o dado passou por um processo de seleção que depende do resultado, a probabilidade que você estimou está enviesada. Eu tenho um exemplo bem específico que dá trabalho de entender na primeira vez. Trabalhei com um modelo de churn para um SaaS e o score parecia absurdo porque os dados vinham só de clientes que já haviam aberto chamado de suporte. O churn real da base completa era cerca de 12%, mas o modelo treinado naquela fatia estimava 38%. A provabilidade do modelo estava tecnicamente correta dentro daquele universo restrito, mas a probabilidade que eu precisava comunicar era outra. O workaround foi separar claramente o universo de treinamento do universo de decisão e usar calibração de Plumm nos resultados finais. No campo da provabilidade, o passo mais esquecido é mapear o tipo de que cada evidência carrega. Existem argumentos dedutivos, indutivos e abdutivos. Dedução garante a conclusão se as premissas forem verdadeiras. Indução generaliza com base em amostras. Abdução propõe a melhor explicação possível. Todo mundo usa os três sem perceber. A armadilha é tratar uma indução fraca como se fosse dedução. Eu já vi relatórios técnicos que diziam "o servidor falhou sete vezes seguidas sob carga alta, portanto a falha é causada por carga". Isso é indução, não dedução. A provabilidade dessa afirmação depende de controlar variáveis, testar contrafactuais e, se possível, reproduzir o cenário. Se não der, o mais honesto é classificar como hipótese plausível, não como fato provado.
Pitfalls que aparecem com frequência
O primeiro é confundir probabilidade condicional com probabilidade marginal. P(A|B) não é a mesma coisa que P(A), e usar um valor no lugar do outro destrói a lógica do modelo ou do argumento. O segundo é tratar provabilidade como sinônimo de verdade. Um argumento pode ser perfeitamente probante dentro de um sistema formal e ainda assim ter premissas falsas no mundo real. O terceiro é achar que todo resultado numérico é probabilidade. Número não é sinônimo de chance. Pode ser score, peso, normalização, distância ou qualquer outra métrica que só ganha interpretação probabilística sob certas suposições. Existe também um problema estrutural que muitos ignoram. Probabilidade exige um espaço amostral bem definido e, muitas vezes, independência ou estrutura de dependência conhecida. Provabilidade exige uma cadeia de inferência transparente e, muitas vezes, acesso às premissas originais. Quando uma dessas condições falha, o resultado deixa de ser confiável. Não adianta aplicar Bayes num cenário onde o prior é inventado ou usar dedução num contexto onde as premissas são incertas. O método precisa casar com a natureza do problema.
Limitações reais que ninguém gosta de ouvir
Probabilidade não resolve incerteza profunda. Se o espaço amostral é mal definido, se os dados são escassos ou enviesados, o número que você obtém é mais um indicador de confiança relativa do que uma medida real de chance. Modelos bayesianos ajudam, mas dependem de priors razoáveis, e priors ruins geram resultados persuasivos e errados. Provabilidade também tem limites. Argumentos indutivos nunca chegam à certeza absoluta, e argumentos abditivos podem apontar para explicações contraditórias que são igualmente plausíveis com base nos mesmos dados. Se você precisa de decisão sob incerteza extrema, nem probabilidade nem provabilidade vão te dar certeza. O melhor que você consegue é transparência sobre o que sabe, o que assume e o quanto cada alternativa arrisca. Quando essas ferramentas falham completamente, a alternativa mais honesta é mudar a pergunta. Em vez de "qual a probabilidade de X", perguntar "sob quais condições X seria verdade" ou "o que seria necessário para provar X". Em vez de "esse modelo prevê bem", perguntar "esse modelo prova algo relevante para a decisão que vamos tomar". Essa mudança costuma revelar falhas que números sozinhos escondem.
Como aplicar sem erro comum
No lado probabilístico, comece definindo o evento, o espaço amostral e a fonte dos dados. Depois escolha entre frequência, Bayesian ou simulação com base na disponibilidade de informação. Valide o modelo com holdout externo, não só com cross-validation interna. Use calibração quando o score precisa representar chance real. No lado provacional, comece listando as premissas, o tipo de inferência e o nível de suporte esperado. Depois construa a cadeia lógica e identifique onde ela fica mais frágil. Teste contrafactuais sempre que der. Se não der, pelo menos registre explicitamente que a conclusão é condicional às premissas atuais. Se você quer um fluxo rápido para não misturar os dois conceitos, use este critério simples. Sempre que o problema envolver aleatoriedade, medição de incerteza ou previsão estatística, trabalhe com probabilidade. Sempre que o problema envolver apoio argumentativo, validade lógica ou sustentação de claims, trabalhe com provabilidade. Quando os dois aparecerem juntos, declare explicitamente qual está sendo usado em cada etapa e trate a transição entre eles como um ponto de risco, não como um detalhe técnico. Essa distinção parece simples, mas faz diferença prática em tempo de resposta e qualidade de decisão. Em projetos reais, confusão entre probabilidade e provabilidade custa revisões demoradas, modelos que precisam ser retreinados e argumentos que parecem sólidos até uma verificação rigorosa. O custo de tratar os dois conceitos com rigor desde o início costuma ser muito menor do que o custo de corrigir a confusão depois que a decisão já foi tomada.
Galeria
-

MAPA MENTAL SOBRE PROBABILIDADE - Maps4Study -

O que é probabilidade? | Conceitos iniciais de probabilidade | Mapa ... -
PPT - PROBABILIDADE PowerPoint Presentation, free download - ID:1364792 -
Tudo Sobre Probabilidade | Probabilidade: o que é, como calcular ...
