Produção De Texto A Partir De Imagem

O que é e como funciona na prática
Produção de texto a partir de imagem é o processo de extrair conteúdo textual de fotografias, digitalizações ou capturas de tela usando reconhecimento óptico de caracteres, conhecido pelo acrônimo OCR. A tecnologia existe há décadas, mas só nos últimos anos se tornou acessível o suficiente para uso cotidiano em fluxos de trabalho criativos e técnicos. Eu comecei a usar isso em 2019 quando precisei recuperar textos de manuais técnicos amarelados que haviam sido fotografados com um scanner caseiro. O problema não era a ferramenta em si, mas a qualidade irregular das fotos e a variação de iluminação entre as páginas. A maioria dos guias-online ignora esses detalhes práticos.
Configuração básica para produção de texto a partir de imagem
O fluxo mais simples envolve três etapas: capturar ou obter a imagem, processá-la com um software de OCR, e revisar o resultado. Ferramentas gratuitas como Tesseract, Google Drive (com o recurso "Traduzir documento"), ou Adobe Acrobat Reader oferecem essas funções sem custo inicial. Para resultados confiáveis, a imagem de entrada precisa ter resolução mínima de 300 DPI para textos impressos convencionais. Abaixo disso, a taxa de erro sobe para algo em torno de 15 a 20 por cento em caracteres pequenos. Fontes sem serifa como Arial ou Helvetica funcionam melhor do que fontes decorativas ou manuscritas. Uma limitação importante é que OCR tradicional falha completamente com imagens muito sujas, textos inclinados ou sobrepostos, e fundos com padrões complexos. Nesses casos, vale a pena considerar soluções alternativas como correção manual ou serviços especializados de transcrição.
Dificuldades reais que poucos mencionam
Aqui vai algo que ninguém conta nos tutoriais: a produção de texto a partir de imagem raramente produz resultado pronto para uso. A precisão cai drasticamente quando você lida com documentos antigos, papel amarelado, ou tipos de letra menos comuns. Meu caso específico foi com uma coleção de receitas da minha avó em cadernos dos anos 80. O OCR do Tesseract lia "açúcar" como "azúcar" e "sal" como "sl" por causa da tinta desgastada e do papel encolhido. A solução que funciou foi combinar processamento prévio com correção pós-OCR. Apliquei filtros de aumento de contraste usando ImageMagick antes do reconhecimento, ajustando níveis de preto e branco para melhorar a separação entre texto e fundo. Depois, usei um corretor ortográfico personalizado com palavras-chave do contexto para corrigir os erros mais frequentes. Outro problema comum é a perda de formatação. Tabelas, colunas múltiplas, e layouts complexos viram uma bagunça de linhas sequenciais. Para documentos com estrutura importante, considere ferramentas como Adobe Acrobat Pro ou ABBYY FineReader, que preservam melhor a disposição original dos elementos.

Otimização para cenários específicos
Se você trabalha com volumes grandes de imagens, automatizar o processo pode economizar horas. Um script Python usando pytesseract pode processar dezenas de imagens por minuto em hardware comum. Basta configurar o caminho da imagem, ajustar as opções de configuração para o idioma correto, e tratar erros de forma padronizada. A precisão final depende de vários fatores: qualidade da imagem, tipo de fonte, linguagem do texto, e configurações do OCR. Em condições ideais, com impressos limpos em português, a taxa de acerto pode chegar a 98 por cento. Com documentos escaneados de baixa qualidade, pode cair para 80 por cento ou menos. O tempo médio de processamento varia de 30 segundos a 2 minutos por página, dependendo da resolução e complexidade do conteúdo. Para uma pasta com 100 imagens, espere entre 50 minutos e 3 horas de trabalho automático, mais tempo adicional para revisão e correção manual.
Alternativas quando o OCR não basta
Existem situações em que a produção de texto a partir de imagem simplesmente não funciona bem o suficiente. Manuscritos antigos, caligrafias irregulares, ou textos em idiomas com poucos dados de treinamento para o modelo de OCR são exemplos clássicos. Nesses casos, considere serviços de transcrição humana ou plataformas como Rev.com e Scribie, que oferecem conversão por aproximadamente 1,00 a 2,00 dólares por minuto de áudio ou por página escaneada, dependendo da complexidade. O investimento vale a pena quando a precisão é crítica. Também existe a opção de usar modelos de IA mais recentes como Google Vision API, AWS Textract, ou Microsoft Azure Computer Vision. Essas soluções pagas oferecem melhor precisão para casos complexos, mas cobram por uso, geralmente entre 1,50 a 2,50 dólares por mil imagens processadas.
Manutenção de qualidade no fluxo de trabalho
Independentemente da ferramenta escolhida, sempre revise o resultado antes de usá-lo em contextos importantes. Erros sutis de OCR podem passar despercebidos e causar problemas sérios, especialmente em documentos técnicos, legais ou acadêmicos. Uma boa prática é manter o arquivo-fonte da imagem junto com o texto extraído, para permitir reprocessamento se necessário. Anotar problemas específicos encontrados durante a revisão também ajuda a refinar o processo para trabalhos futuros. A produção de texto a partir de imagem evoluiu significativamente nos últimos anos, mas ainda requer atenção aos detalhes e compreensão das limitações técnicas. Domínio prático vem com experiência direta, não apenas leitura de manuais.

Galeria
-
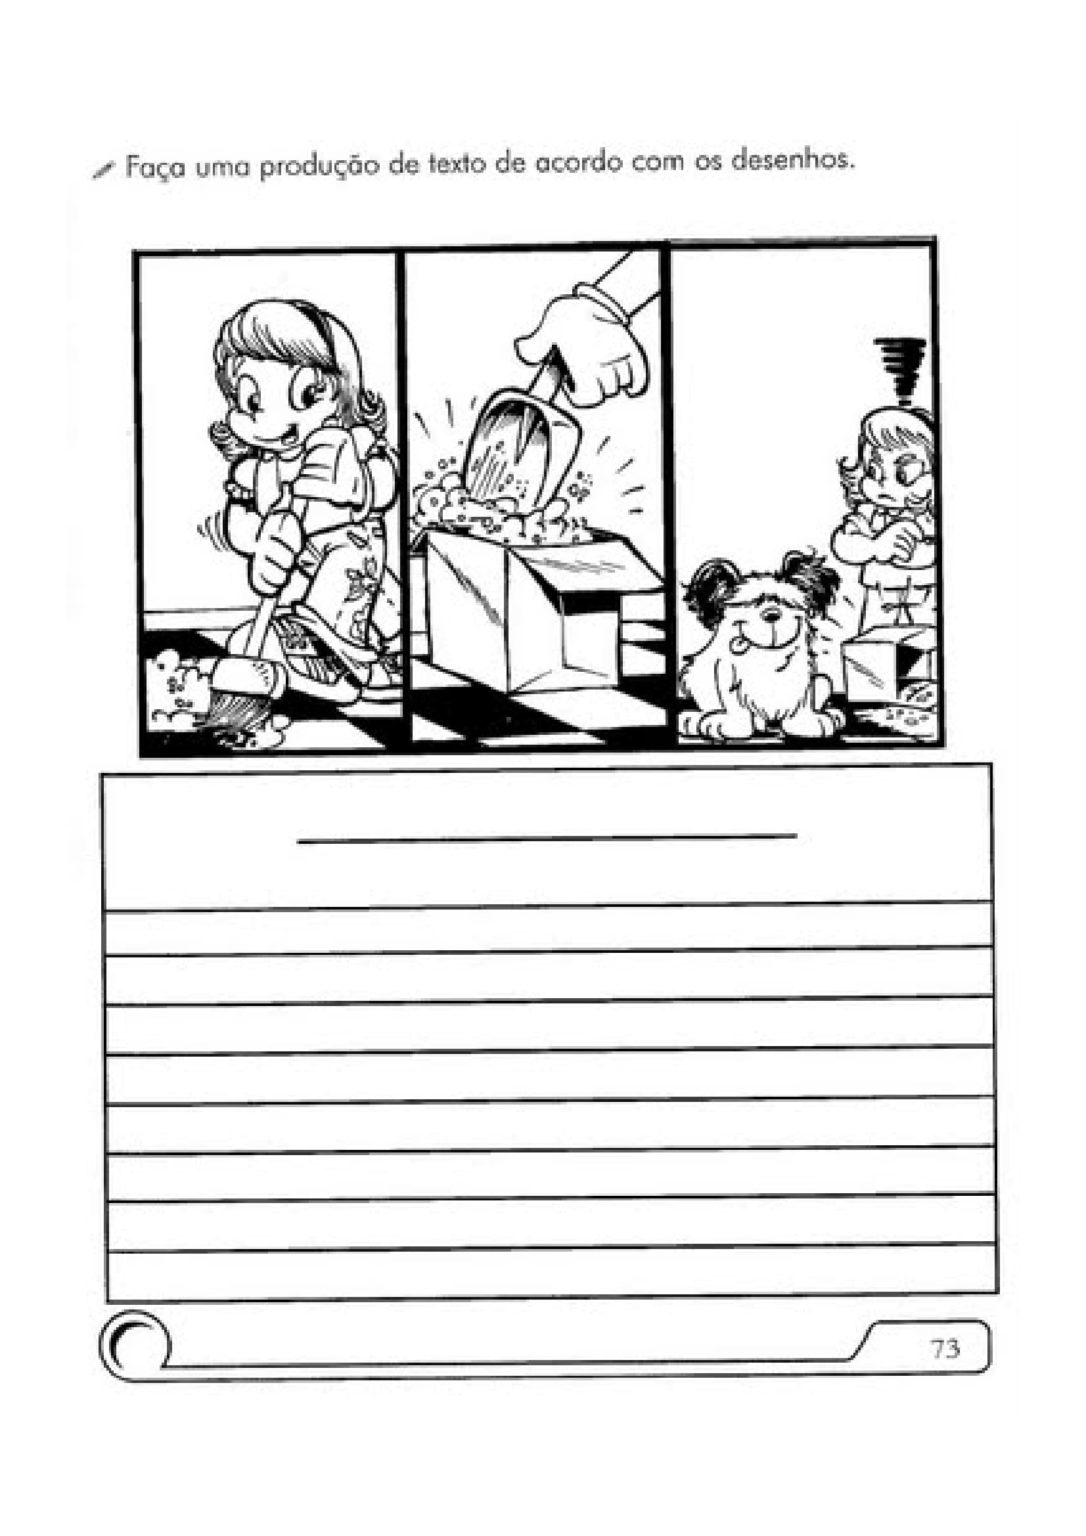
1º ao 5º - Atividades de produção de texto a partir de imagens e ... -

Historias Em Sequencia Para Produção De Texto - NAZAEDU -

Apostila de Produção de Texto – Sequência de Imagens – Rotina ABC ...
