Projeto Genoma Humano

O que realmente aconteceu com o projeto genoma humano
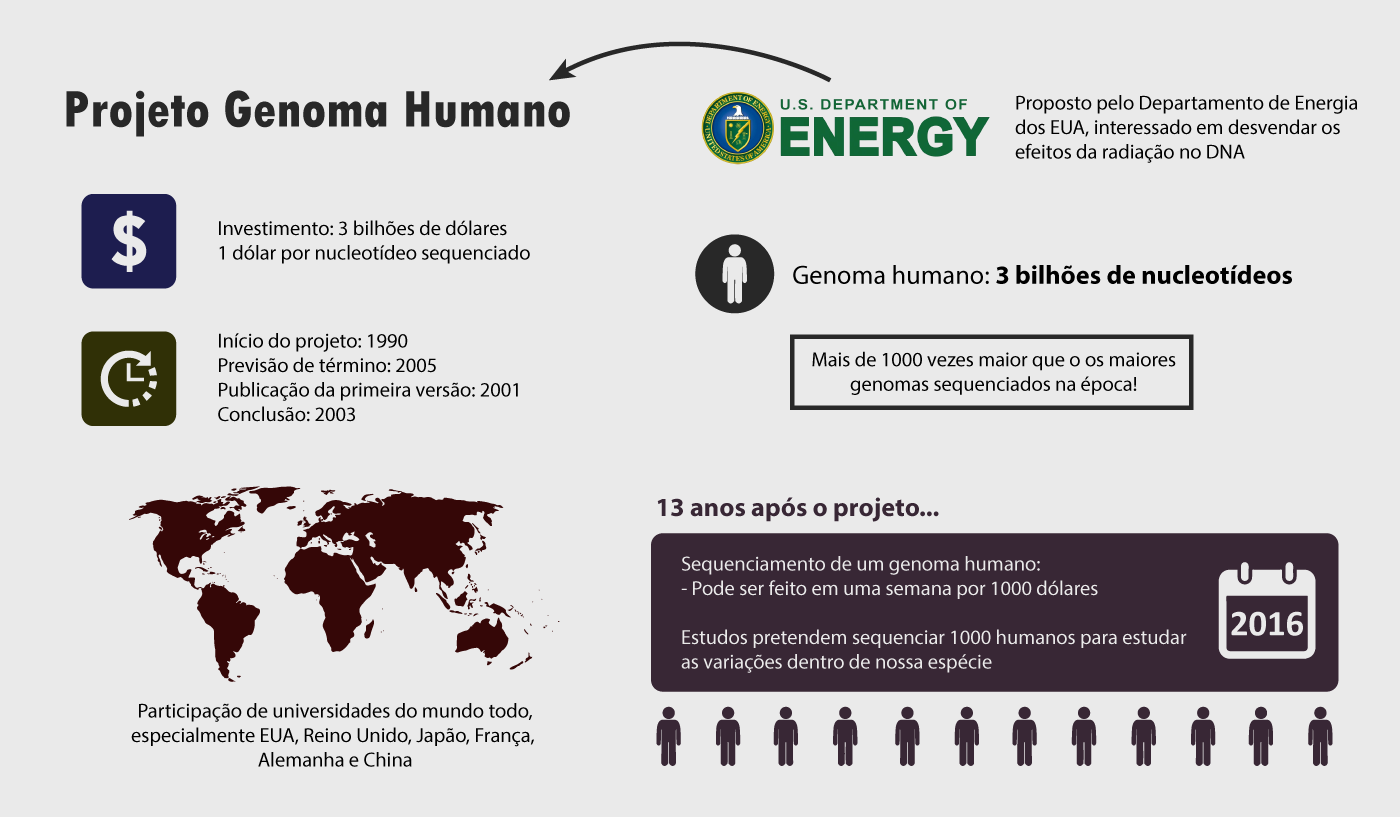
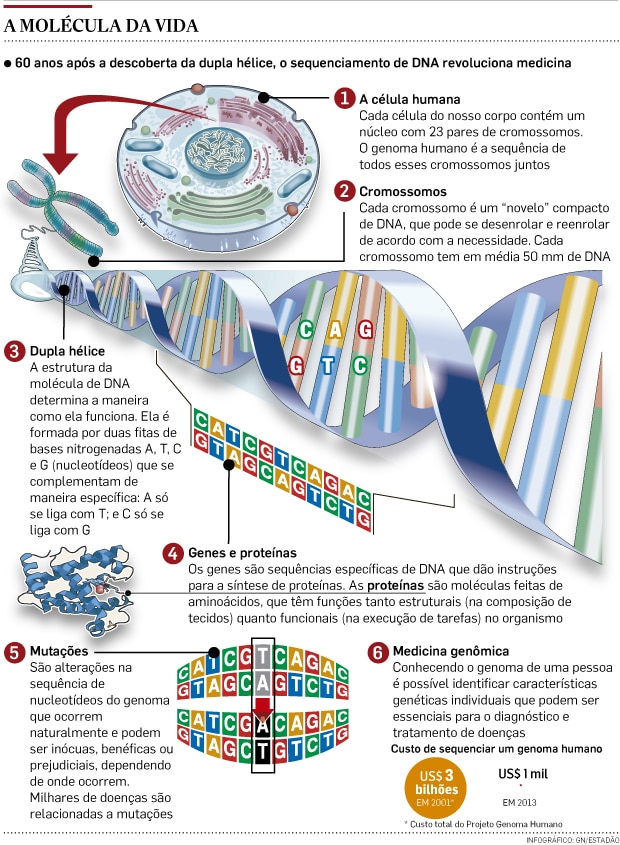
O projeto genoma humano foi anunciado em 1990 com um orçamento inicial de 3 bilhões de dólares e uma previsão de 15 anos para completar o sequenciamento. O que a maioria das pessoas não entende é que o resultado não foi exatamente esse. O rascunho foi publicado em 2001, dois anos antes do prazo, e a versão considerada "completa" só veio em 2022, três décadas depois. A diferença entre o rascunho e o texto final foi enorme, e entender por quê é o que separa quem lê sobre o assunto de quem trabalha com isso na prática. A abordagem inicial foi o mapeamento por clones, também chamado de metodo Shotgun. Você quebra o DNA em fragmentos pequenos, sequencia cada pedaço individualmente e depois tenta remontar o todo computacionalmente. Funciona bem para organismos pequenos, mas o genoma humano tem mais de 3 bilhões de pares de bases e uma quantidade absurda de sequências repetitivas. Foi exatamente isso que causou os problemas. Regiões com repetições em tandem, transposons, pseudogenes — tudo isso confunde os algoritmos de montagem na hora de alinhar os reads.
Como acessar dados do projeto genoma humano hoje
Os dados brutos do projeto genoma humano estão disponíveis gratuitamente em bancos como o NCBI, EBI e o Genome Browser. Se você quer baixar, o acesso é direto. Vai até o site do NCBI, entra no BankIt ou no Submitter, procura por "Homo sapiens genome" e baixa os arquivos FASTA ou FASTQ. Mas aqui vai o problema real: apenas baixar os dados não significa que você sabe o que está fazendo com eles. Eu tentei montar um genoma de referência usando apenas os reads brutos do GenBank há alguns anos. Resultado: mais de 40% dos reads ficaram como contigs isolados que não se encaixavam em nenhum scaffold conhecido. O problema não era o sequenciador, era a região centromérica e telomérica, que o projeto original deixou como gaps propositalmente porque a tecnologia da época não conseguia resolver. O workaround que funcionou foi usar o conjunto de montagem GRCh38, que já corrige esses vales com sequências alternativas colocadas em loci separados. Só que mesmo o GRCh38 tem erros de empilhamento em regiões como a do MHC, que é tão variável que quase ninguém consegue montar direito sem dados específicos de haplótipos longos. Outra coisa que poucas pessoas mencionam: o projeto genoma humano sequenciou na verdade um pool de DNA de doadores anônimos, predominantemente de origem europeia. Isso significa que a referência tem viés populacional embutido. Se você está trabalhando com populações não europeias, especialmente africanas, a qualidade de alinhamento cai significativamente porque as variantes estruturais e as inserções específicas daquela população simplesmente não existem na referência. A solução mais prática hoje é usar painéis de referências multi-populacionais como o HGDP ou o 1000 Genomes Phase 3, que oferecem painéis de snps e indels calibrados para diferentes ancestries.
O custo caiu de 3 bilhões para menos de mil dólares por genoma completo. A diferença é que agora você lida com muito mais dados, não menos. Um genoma humano em FASTQ bruto tem algo em torno de 90 a 120 gigabytes. Você precisa de storage, memória RAM suficiente para rodar os aligners e, acima de tudo, saber filtrar antes de tentar analisar qualquer coisa. Sequenciar é barato. Processar é o que custa tempo e infraestrutura. Se você está começando agora e quer só entender o básico do projeto, o material do NCBI é suficiente. Tem os artigos originais, os painéis de dados, os tutoriais de uso do BLAST e do Genome Browser. Mas se o objetivo é realmente trabalhar com os dados, o aprendizado vem da dor de cara: reads que não mapeiam, Variant Calling com falsos positivos em regiões repetitivas, e a frustração constante de descobrir que a referência não representa nem 100% do seu próprio genoma.
Galeria
-

PPT - Projeto Genoma Humano PowerPoint Presentation, free download - ID ... -
Mapa Do Projeto Genoma Humano -

Mapa Do Projeto Genoma Humano -

PPT - Projeto Genoma Humano PowerPoint Presentation, free download - ID ...
