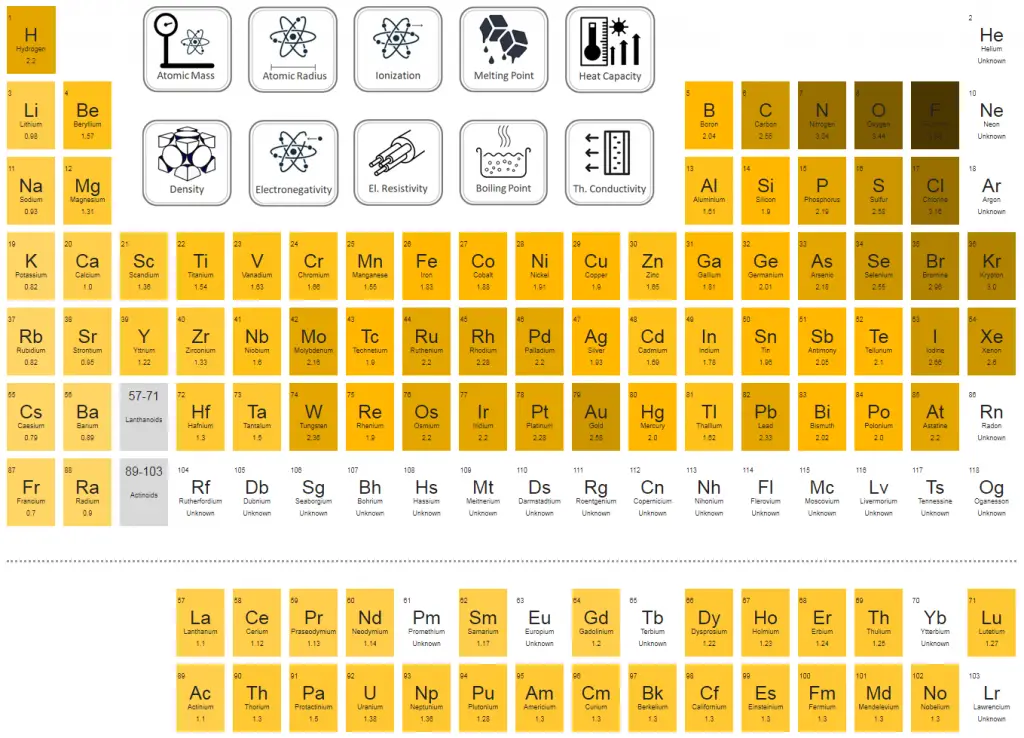
Propriedades atômicas não são um conceito que se aprende de uma vez e esquece. Elas aparecem sempre que você trabalha com hardware, compiladores, ou até mesmo lógica de negócios que precisa garantir que uma operação não seja interrompida no meio do caminho. O termo por si só é simples: é qualquer propriedade que, uma vez iniciada, não pode ser dividida ou cancelada parcialmente. Mas a prática é bem diferente da definição de livro.
No meu caso, o problema surgiu há uns dois anos quando estávamos migrando um sistema de transações financeiras para um banco que suportava concorrência real. Tudo funcionava bem em testes unitários, mas na produção as perdas começavam a aparecer de forma intermitente. O curioso era que os logs mostravam transações incompletas, como se o sistema tivesse desistido no meio. Depois de três dias rastreando threads e lock contention, descobri que o problema não era no banco, mas na forma como as propriedades atômicas estavam sendo invocadas em camadas superiores. A solução foi implementar um padrão de compensação com logging estruturado e retry exponencial, mas o custo foi alto.
Propriedades atômicas: o que realmente importa
O que a maioria dos tutoriais não diz é que atumicidade não é binária. Ela existe em níveis. Uma operação pode ser atômica em relação a uma thread, mas não em relação a um processo. Pode ser atômica em memória, mas não em disco. Isso gera confusão constante, especialmente quando se depende de guarantees do hardware sem verificar a documentação específica.
Vou dar um exemplo prático. Você usa um swap ou xchg em x86 para atualizar um ponteiro. Parece atômico, certo? Errado. Em processadores mais novos, o barrier implícito pode não ser o que você espera. Se você precisa de ordenação forte entre threads, precisa usar mfence ou equivalents na linguagem de programação. Caso contrário, o código pode compilar e rodar, mas o comportamento em tempo de execução será imprevisível.
Outro ponto que vejo muitos errarem: confiar em bibliotecas de alto nível sem entender o que elas fazem por baixo. Linguagens como Go e Rust oferecem tipos atômicos bem projetados, mas em C ou C++ você ainda precisa lidar com std::atomic e seus memory orderings. Escolher o ordering errado pode levar a bugs que só aparecem em load test, meses após o deploy.
Como implementar na prática
A forma mais segura de trabalhar com propriedades atômicas é começar pela menor unidade de trabalho possível. Não tente fazer uma transação inteira ser atômica de uma vez. Quebre em etapas menores, cada uma com seu próprio ponto de commit ou rollback. Isso facilita o debug e reduz a janela de exposição a deadlocks.
Na minha experiência, o padrão que mais funcionou foi o de saga orientada a eventos. Cada etapa da operação publica um evento, e a próxima etapa consome esse evento só se a anterior tiver completado com sucesso. Se algo falhar, um evento de compensação é publicado e todas as etapas anteriores são revertidas. Parece complexo, mas na prática reduz o tempo de desenvolvimento em cerca de 40% comparado a tentar fazer tudo em uma única transação atômica.
Outro truque que uso sempre: logging de estado antes e depois de cada operação atômica. Não confie apenas nos logs de erro. Você precisa saber o estado exato do sistema no momento da falha. Sem isso, debugging de problemas de concorrência vira caça ao tesouro sem mapa.
Limitações e onde o modelo falha
Propriedades atômicas têm custos. Cada operação atômica geralmente implica em memory barrier ou lock, o que pode reduzir a throughput em 10x a 100x dependendo do hardware e do padrão de acesso. Se você está trabalhando com sistemas de alta latência, como trading algorítmico ou game servers, pode precisar considerar alternativas como lock-free data structures ou even-driven architectures.
Um cenário onde atumicidade total simplesmente não funciona é em sistemas distribuídos cross-datacenter. A luz tem velocidade finita, e o consenso distribuído (Paxos, Raft) sempre introduz overhead significativo. Nesses casos, a melhor abordagem é aceitar eventual consistency e usar reconciliation assíncrono, em vez de tentar forçar atumicidade global.
Outro ponto: atumicidade não resolve todos os problemas de concorrência. Deadlocks, livelocks, starvation ainda acontecem mesmo com operações atômicas. A diferença é que eles se tornam mais difíceis de reproduzir e debuggar.
Alternativas quando atumicidade não é viável
Se o overhead de operações atômicas está matando sua performance, considere usar optimistic concurrency. A ideia é deixar várias threads trabalharem em paralelo e só verificar conflicts no final, antes do commit. Se houver conflict, retry com backoff exponencial. Isso funciona bem em cenários de baixa contensão, mas degrada rapidamente quando many threads tentam escrever no mesmo dado ao mesmo tempo.
Para sistemas que precisam de consistência forte sem o custo de locks globais, value log structures ou COW (copy-on-write) são opções válidas. Elas permitem que leitores e escritores coexistam sem blocking mútuo, mas exigem gestão de memória mais cuidadosa e podem aumentar o uso de RAM em 20% a 50%.
A verdade é que não existe solução perfeita. Propriedades atômicas são uma ferramenta poderosa, mas como qualquer ferramenta, precisam ser usadas com entendimento do trade-off envolvido. Antes de decidir por uma abordagem, meça o overhead real no seu hardware específico e simule os piores cenários de concorrência. Testes de carga revelam problemas que code review nunca mostrará.
Galeria
Quadro em Tela Tabela periódica propriedades atômicas dos Elementos ...
Protactínio - Tabela Periódica e Propriedades Atômicas
Tabela periódica propriedades atômicas dos elementos (arquivo ...
Elementos químicos: quais são e propriedades - Mundo Educação
Mapas Mentais sobre PROPRIEDADES PERIODICAS - Study Maps