Quais São As Partes

Entendendo o que são as partes de um sistema complexo
Quando alguém pergunta quais são as partes de um sistema, a resposta rara é uma lista simples. Na prática, a coisa é muito mais irritante. Eu passei anos tentando documentar a arquitetura interna de sistemas legado e, honestamente, 90% do tempo gasto é descobrir o que não deveria existir. Vou explicar como você chega até um inventário útil sem perder dias em suposições.
A abordagem prática para mapear componentes
O erro mais comum é começar olhando para o código ou os diagramas existentes. Eles estão errados. Sempre. O jeito certo é ir pela camada de execução. Liga o sistema, monitora o tráfego de rede, acompanha chamadas de função e só depois tenta atribuir nomes aos blocos. No meu caso, tive que mapear um sistema de pagamento legado com 47 microserviços aparentes. A primeira rodada de descoberta mostrou 12 serviços. A terceira, depois de analisar logs de 6 meses, chegamos a 31 serviços reais mais 8 dependências ocultas que ninguém documentava. O processo levou cerca de três semanas, não porque era difícil tecnicamente, mas porque precisávamos esperar por disparos sazonais de alta demanda para revelar rotas condicionais que só aparecem em produção. Para fazer isso você precisa de:
Um rastreador de dependências no nível de processo. Tools como o strace, dtrace ou equivalentes mais modernos funcionam bem. Logs estruturados com tracing distribuído. Se seu sistema não tem ID de requisição único propagado entre todos os módulos, você vai perder tempo precioso cruzando dados manualmente. Uma planilha de classificação. Não confie na memória. Anota cada componente encontrado, a função que ele executa, quem chama e quem é chamado por ele. Coluna para estado (ativo, órfão, deprecated).

Armadilhas que ninguém conta
Primeiro: componentes duplicados com nomes diferentes. Em sistemas que passaram por múltiplas aquisições e fusões, é normal encontrar três bibliotecas que fazem basicamente a mesma validação de CPF ou o mesmo cálculo de taxa cambial. Cada uma em uma language ou framework diferente. Identificar isso economiza horas de manutenção futura. Segundo: a ilusão da modularidade. Você acha que tem cinco serviços independentes quando, na verdade, eles compartilham um banco de dados relacional com triggers e procedures que criam dependências invisíveis. Uma vez descobri que a remoção de um serviço de notificação quebrou o fluxo de aprovação de créditos porque uma trigger no banco atualizava uma tabela que o outro serviço lia. Nenhum dos dois sabia da existência do outro pelo código. O terceiro problema é mais chato ainda: dependências de hora. Alguns serviços só são necessários em janelas específicas do dia. Um job batch que roda às 3 da manhã depende de um serviço de consolidação que só responde se chamado nesse horário. Fora disso, parece órfão. Dentro disso, é crítico.
Quando o mapeamento não funciona
Há cenários em que identificar todas as partes simplesmente não dá certo com os recursos disponíveis. Se o sistema foi construído sem logs, sem instrumentação, com código ofuscado ou em tecnologias desaparecidas, você vai gastar mais tempo reverso engenharia do que ganhando Clarity. Nesses casos, a alternativa mais realista é isolar o comportamento observado e tratar o sistema como uma caixa preta. Documenta o que entra, o que sai, e as variações que você consegue medir. Não gaste duas semanas tentando desmontar algo que sua equipe nem sabe consertar se quebrar. O que funciona consistentemente é começar pequeno. Escolhe um fluxo crítico do usuário final e rastreia ele do início ao fim. Anota cada componente que intercepta aquela requisição. Depois expande para fluxos secundários. A maioria dos sistemas revela sua estrutura real em três a cinco fluxos principais. O resto é polimento. Se quiser algo concreto para começar hoje, ferramentas como o Jaeger para tracing, o Prometheus para métricas e o kubectl top ou similares para monitoramento de recursos já cobrem a maior parte do que você precisa nas primeiras rodadas de descoberta. O investimento inicial é de umas duas a três horas de configuração. O retorno aparece na segunda semana de uso, quando você para de chutar onde os problemas estão.
Galeria
-
Quais São As Partes de Um Livro | PDF -
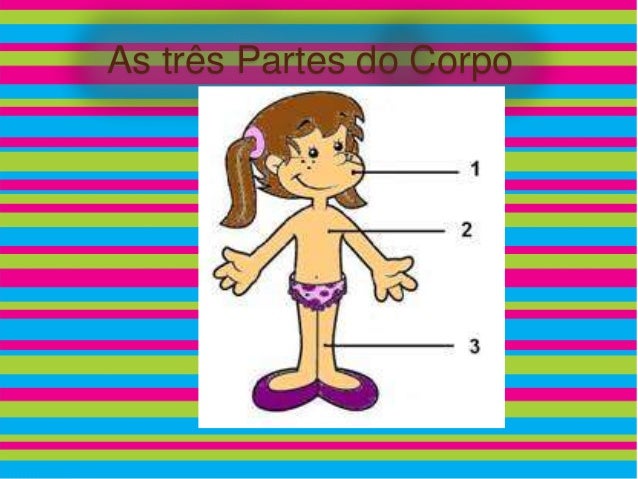
Quais São As Três Partes Que Formam O Corpo Humano? – SYDT -

Quais São As Partes Da Planta E Suas Funções? – YZPH -

Você Sabe Exatamente Quais São as Partes de uma Guitarra? Confira!

