Quais São Os Recursos

Como mapear e documentar quais são os recursos disponíveis no seu ambiente
A maioria dos projetos começa com uma planilha bagunçada e um monte de arquivos soltos. Ninguém documenta os recursos certos. O resultado é que, meses depois, você não faz ideia do que já existe, do que foi descontinuado e do que precisa ser criado. Resolver isso exige um método prático, não teoria. O primeiro passo é entender o que você está procurando. Recursos podem ser arquivos estáticos, endpoints de API, configurações de ambiente, permissões de usuário, templates, imagens, bibliotecas externas ou qualquer coisa que o sistema consome ou expõe. A definição varia conforme a stack, mas o processo de inventário é parecido em qualquer lugar. Eu trabalhei em um sistema onde a equipe achava que tinha cinco versões de um componente de UI, mas na verdade eram quatorze, cada uma em pastas diferentes, com nomes ligeiramente distintos. Perdiam dias inteiros caçando a versão certa. A solução foi criar um script simples de varredura que listava todos os arquivos do tipo, calculava hashes e agrupava por similaridade. Levou duas horas para rodar e eliminou a duplicação que ninguémVia.
Quais são os recursos que realmente importam
Não adianta inventariar tudo. Focar nos ativos que impactam a performance, a segurança ou a manutenabilidade evita trabalho desnecessário. Priorize recursos críticos como certificados SSL, chaves de API, configurações sensíveis, assets carregados no bundle principal e endpoints que recebem tráfego pesado. Coisas obsoletas ou raramente usadas podem ficar para uma segunda fase. Uma técnica útil é classificar os recursos por ciclo de vida. Um asset que muda toda semana merece revisão constante. Um template que foi definido em 2021 e nunca mais foi tocado provavelmente está correto e pode ser ignorado por enquanto. Isso economiza tempo e evita análise paralisante. Documentar quais são os recursos também envolve registrar onde cada um mora. Caminho absoluto, variável de ambiente, URL pública ou path relativo. A informação mais importante que falta na maioria dos inventários é o proprietário. Sem saber quem é responsável por um recurso, quando algo quebra ninguém liga para o direito.
No meu caso, encontrei um arquivo de configuração com credenciais hardcoded em um repositório público. O problema não era apenas o arquivo, mas a ausência de registro de quem tinha acesso e há quanto tempo aquela credencial estava ativa. A workaround foi migrar para um gerenciador de segredos e rotacionar a chave imediatamente. Gastou uma tarde, mas salvou horas de debugging futuro.
Método prático de inventário de recursos
Comece listando manualmente o que você conhece. Não confie em memória ou documentação antiga. Abra o código, cheque o deploy, veja o que está rodando em produção. Um bom começo é executar comandos de descoberta no próprio ambiente. Para infraestrutura Docker, um docker ps junto com inspect dos containers mostra volumes, redes e variáveis. Para servidores web, verificar o diretório de assets e o que o bundle carrega revela dependências ocultas. Em seguida, automatize. Scripts de varredura economizam horas. Em Python, usar os.walk combinado com bibliotecas como watchdog permite rastrear mudanças em tempo real. Em Node, módulos como glob ou fast-glob localizam arquivos rapidamente. O objetivo é gerar um relatório estruturado, não apenas uma lista de nomes. Uma limitação comum é que alguns recursos são dinâmicos. APIs que geram conteúdo sob demanda, CDNs que criam versões sob demanda ou arquivos que aparecem apenas após build não aparecem no disco. Para esses casos, use monitoring e logs. Acompanhar requisições em produção por algumas horas revela quais endpoints e assets são realmente usados.
Outro ponto cego são dependências transitivas. Uma biblioteca que você importa pode puxar outras que não estão no seu radar. Ferramentas como npm audit, pip freeze ou bundler audit ajudam, mas não substituem a verificação manual de packages sensíveis. Eu já vi projetos com dezenas de versões de uma mesma lib instaladas simultaneamente porque cada pacote trazia sua própria dependência. Resolveu-se com lockfiles rigorosos e auditoria quinzenal.
Como manter o inventário atualizado
Inventário vir documento morto se ninguém o mantiver. A solução é integrar a listagem ao fluxo de desenvolvimento. Adicionar uma etapa de review onde mudanças em recursos precisam ser registradas evita acúmulo. Se um desenvolvedor adiciona um novo endpoint ou asset, deve atualizar o arquivo de inventário como parte do PR. Automatizar a validação também ajuda. Um simple CI check que compara o estado atual com o último commit do inventário flagra divergências. Se o código pede um arquivo que não está listado, o pipeline falha. Pode parecer burocrático no início, mas reduz drasticamente os surtos de "não sei onde está isso". Revisar periodicamente é obrigatório. Mesmo com automação, coisas mudam. Um recurso marcado como deprecated pode continuar sendo usado. Um arquivo crítico pode ser movido sem aviso. Um ciclo de atualização mensal costuma ser suficiente para equipes pequenas. Para sistemas maiores, trimestral com verificações pontuais após mudanças significativas.

Cuidado com a tentação de exagerar na quantidade de dados registrados. Inventários muito detalhados viram manutenção infinita. Focar nos campos essenciais: nome, localização, dono, status, data da última atualização e notas breves. Mais que isso só atrapalha a usabilidade. Se o sistema tem muitos recursos efêmeros ou gerados dinamicamente, considere uma abordagem diferente. Em vez de listar cada item, documentar a regra de geração. Saber que um certo padrão de nome cria um arquivo temporário é mais valioso do que catalogar cada arquivo criado durante builds.
Ferramentas que facilitam o processo
Dependendo da stack, existem utilitários prontos. Para React e Next.js, o next info mostra assets compilados e dependências. Para Rails, comandos como bin/rails routes e listas de views ajudam a mapear recursos da aplicação. Em microsserviços, o uso de service mesh ou dashboards de observabilidade revela endpoints ativos sem precisar escanear código. Para infraestrutura cloud, ferramentas nativas como AWS Config, Azure Resource Graph ou Google Cloud Asset Inventory fazem o trabalho pesado. Elas indexam recursos automaticamente e permitem query por tags, region ou tipo. A desvantagem é que podem não cobrir recursos customizados ou legados fora do provedor. Alternativamente, soluções genéricas como dependency-cruiser, tree-sitter ou até scripts próprios com GraphQL para explorar o grafo de importações são eficazes. O importante é escolher algo que se encaixe no fluxo existente, não importar uma ferramenta nova só por vaidade.
Eu tive um projeto onde a melhor solução foi uma combinação de script caseiro com dados colhidos de logs de produção. A lógica era simples: coletar paths acessados durante picos de uso e cruzar com o versionamento do código. O resultado mostrou exatamente quais recursos estavam em produção e quais tinham sido removidos mas ainda apareciam em cache. Economizou semanas de busca manual.

O que não fazer
Não confie em documentos que ninguém atualiza. Se a wiki diz que um recurso existe e ele sumiu há meses, a informação é pior que nenhuma. Verificar no código e no ambiente atual é sempre mais confiável. Tampouco subestime o impacto de recursos órfãos. Arquivos não referenciados que permanecem no servidor ocupam espaço, podem causar conflitos de nome e confundem novos integrantes. Remover o que não é mais necessário deve fazer parte do processo de limpeza. Evite inventariar só para ter inventário. Se o relatório ninguém lê, não vale o esforço. O valor está em usar a informação para tomar decisões: otimizar carga, substituir dependências, corrigir segurança ou planejar migrações.
Por fim, não espere perfeição. Recursos em sistemas reais são caóticos. O objetivo é ter clareza suficiente para operar com confiança, não mapear cada byte existente. Atingir 80% de cobertura dos ativos críticos já é um resultado sólido. Se quiser um ponto de partida prático, comece com um arquivo CSV simples com colunas fixas e vá preenchendo conforme descobre. A evolução natural leva a automação, mas a base é a disciplina de registrar o que encontra. Quando alguém perguntar quais são os recursos do projeto, a resposta será fácil de montar.
Galeria
-

Recursos Naturais Imagens -
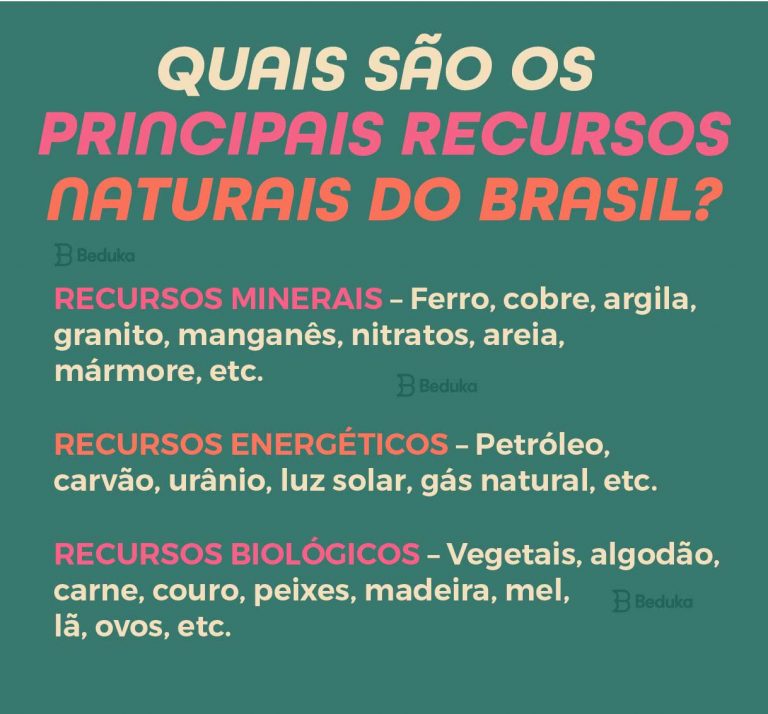
Principais recursos naturais do Brasil - Blog do Beduka | Matérias ...
