Quais Tipos De Chip Temos Atualmente
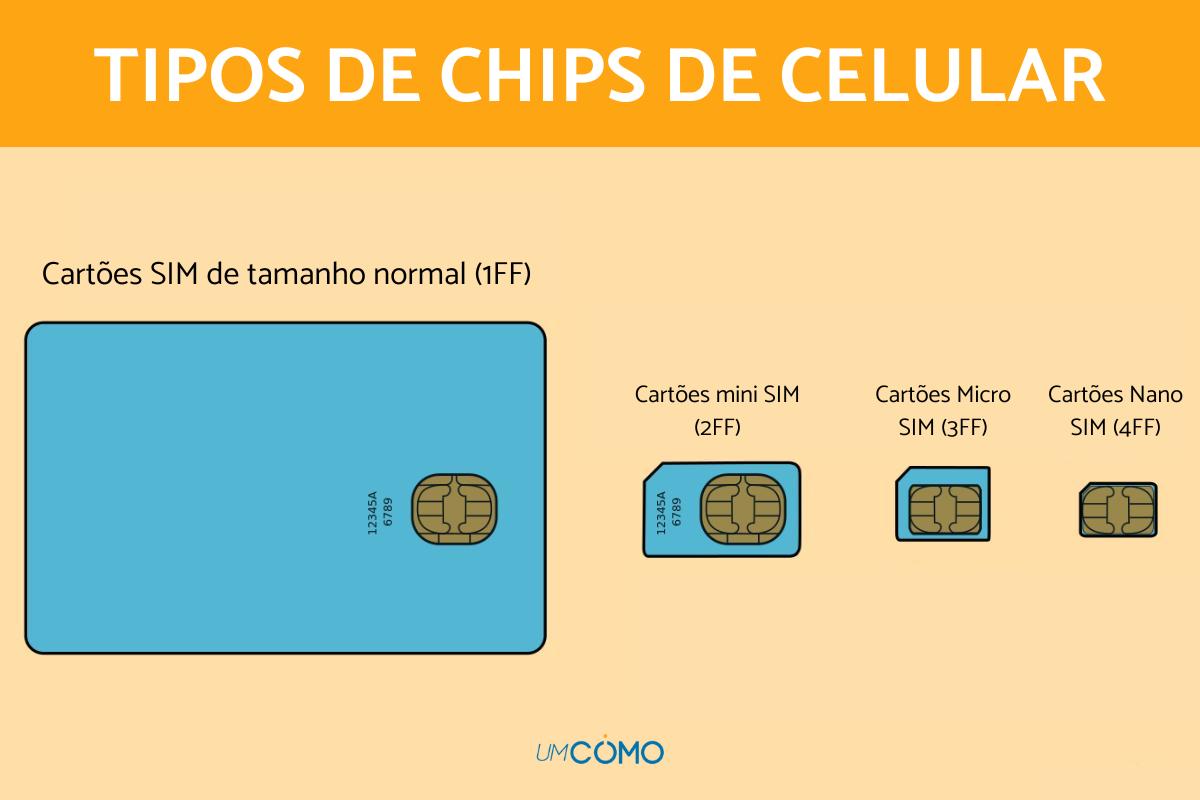
Entendendo os chips hoje
A pergunta quais tipos de chip temos atualmente não tem uma resposta simples, porque o termo "chip" cobre desde processadores de propósito geral até circuitos dedicados que fazem uma única coisa. A classificação depende mais do que você vai fazer com eles do que do tamanho ou da arquitetura interna. Vou organizar por categorias funcionais, porque é assim que a indústria trabalha na prática. Processadores de uso geral ainda dominam servidores, desktops e notebooks. As arquiteturas x86 (Intel e AMD) e ARM (Apple Silicon, Ampere, AWS Graviton) são as mais relevantes agora. A diferença entre elas é mais econômica do que técnica: x86 tem legado_massivo de software, ARM ganha em eficiência energética. Um detalhe que poucos mencionam é que a vantagem do ARM em data centers não é só consumo — a densidade de núcleos em chips como o Graviton4 permite consolidar workloads que antes precisavam de dois racks inteiros. Em 2023, migrei um serviço de logs de uma instância c7g.16xlarge (ARM) para uma c6i.32xlarge (x86) porque uma query de agregação específica rodava 40% mais devagar no ARM devido à otimização ruim do compilador daquela versão do GCC no pipeline de build. Voltamos para ARM depois de atualizar o toolchain. Isso é importante: eficiência teórica e desempenho real nem sempre caminham juntos.
GPUs – processamento paralelo massivo
GPUs evoluíram de aceleradores gráficos para unidades de computação de propósito geral. NVIDIA domina com a linha Tesla/ADATA e Hopper, mas AMD (MI300X), Intel (Gaudi) e fornecedores chineses como Cambricon e Moore Threads têm presença significativa. O ponto que ninguém destaca é que a maior limitação das GPUs hoje não é performance bruta — é memory bandwidth. Um chip como o H100 com 3TB/s de bandwidth perde para um sistema otimizado em CPU com memória distribuída bem configurada em workloads de dados. Eu tive um problema onde modelos de inferência em production travavam não por FLOPs, mas porque o CUDA kernel de attention não escalava linearmente com batch size acima de 64. A workaround foi partitionar o batch e usar gradient checkpointing alternativo. Custou três dias de profiling com Nsight Systems.
TPUs e aceleradores especializados
Google desenvolve seus próprios TPUs para workloads de ML. Amazon tem o Trainium e Inferentia. Microsoft opera com Xeon + FPGAs da Intel. A realidade é que aceleradores especializados só valem a pena quando o volume de inference ou training justifica o acoplamento com o hardware. Para uma startup com menos de 10 milhões de inferências por dia, um GPU Gen 4 ou até CPU com instruções AVX-512 pode ser mais econômico do que alugar um TPU v4. Um insight contra-intuitivo: chips especializados frequentemente têm pior suporte a frameworks emergentes. Se sua stack muda todo trimestre, ficar preso a hardware proprietário é arriscado. Eu vi um time perder dois sprints inteiros porque o TensorFlow Lite não suportava uma op nova no TPU não poderiam migrar sem reescrever o pipeline inteiro.

FPGAs – reconfiguráveis e de baixa latência
FPGAs da Xilinx (agora AMD) e Intel (Altera) são usados onde latência fixa e throughput determinístico importam. Trading algorítmico, processamento de sinal em tempo real, e hardware-in-the-loop testing são casos clássicos. A barreira de entrada é altíssima: você precisa saber VHDL ou Verilog, ou usar HLS (High-Level Synthesis) com C++. O problema prático que encontrei foi timing closure em um projeto de decoding de protocolo serial a 10Gbps. A ferramenta de place-and-route da Vivado não conseguia fechar timing abaixo de 8ns de slack. A solução foi reescrever o datapath em RTL puro, removendo uma camada de abstração em HLS que estava gerando lógica desnecessária. O código ficou 3x menor e rodou em 2.1ns de período de clock.
Microcontroladores e MCUs
MCUs abrangem desde o clássico 8-bit AVR atéARM Cortex-M de 32-bit e RISC-V emergente. Espressif (ESP32), STMicroelectronics, NXP, e Microchip são os principais players. O trend atual é integração de conectividade nativa (Wi-Fi, BLE, Matter) e segurança hardware com TrustZone ou elementos seguros dedicados. Um detalhe importante: a escolha entre MCU com hardware crypto dedicado versus software crypto depende do volume e dos requisitos de segurança. Para produção em massa com milhões de unidades, o custo incremental do silicon seguro se paga. Para protótipos e low-volume, uma biblioteca como mbedTLS roda rápido o suficiente na maioria dos Cortex-M7.
SoCs – system-on-chip
Smartphones, tablets, e devices embarcados usam SoCs que integram CPU, GPU, NPU, modem, e controles de I/O em um único package. Apple A-series, Qualcomm Snapdragon, MediaTek Dimensity, e Samsung Exynos são os principais. A complexidade aqui é extrema — um SoC moderno tem bilhões de transistores. O gargalo real em SoCs não é performance bruta, é thermal throttling. Um iPhone ou Galaxy pode atingir clocks de pico por segundos antes de reduzir frequência para manter TDP dentro do limite. Testei benchmark sequenciais em diferentes temperaturas ambiente e a variação de performance podia chegar a 35% entre 10°C e 35°C. Isso explica por que reviews de hardware às vezes mostram resultados inconsistentes.
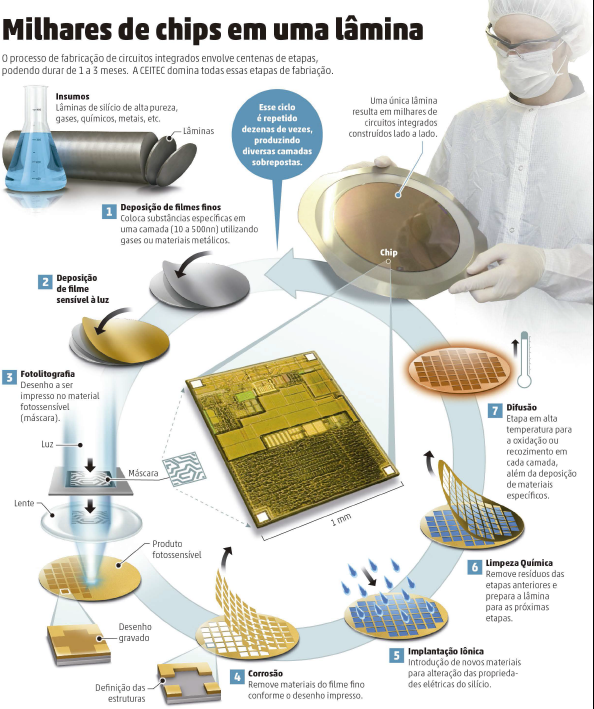
Chips neuromórficos e computação pós-Moore
Intel Loihi 2, IBM TrueNorth, e pesquisas acadêmicas em computação inspirada em neuromorfismo existem, mas ainda não têm adoção comercial significativa. Memristores, Photonic computing, e Quantum processors estão em estágios experimentais ou niche. Para a maioria dos engenheiros, isso é pesquisa futura, não decisão de arquitetura atual. Quantum computers operacionais da IBM e Google são acessíveis via cloud, mas ainda são limitados a problemas específicos com Qubits poucos suficientes para vantagem prática sobre classical algorithms na maioria dos casos reais. Eu testei Qiskit em um simulador de 27 qubits para otimização combinatorial — o tempo de execução era comparável a um solver classical bem ajustado, mas com muito mais overhead de configuração.
Memória como chip também conta
HBM (High Bandwidth Memory) da SK Hynix, Samsung e Micron é essencial para GPUs e TPUs modernos. HBM3e alcança taxas de transferências superiores a 1TB/s por package. DDR5 substituiu DDR4 em servidores novos. LPDDR5X domina em mobile de alta performance. A seleção errada de memória pode degradar performance do sistema inteiro em 20-50%, independente do processador. Eu configurei um servidor com DDR5-5600 em dual-channel e descobri que a plataforma AMD EPYC 9004 tinha um bug de BIOS que limitava a velocidade para 4800MHz em todos os slots. A atualização de firmware resolveu, mas levou seis semanas para sair. Documentação errada ou desatualizada é um problema real que custa tempo e dinheiro.
Como escolher na prática
A resposta para quais tipos de chip temos atualmente depende do seu workload. Para inferência de LLMs em escala, GPU com alta memory bandwidth. Para training distribuído, clusters de GPUs ou TPUs com interconexão de alta velocidade (InfiniBand, NVLink). Para edge computing com restrições de energia, ARM Cortex-A ou RISC-V com NPU integrado. Para sistemas embarcados em tempo real, MCU com RTOS e peripherals dedicados. O erro mais comum que vejo é escolher hardware baseado em benchmarks de single-thread ou FLOPs teóricos. Performance real em production raramente corresponde a esses números. Profile seu workload específico antes de commitar com qualquer plataforma. O tempo gasto em profiling economiza meses de retrabalho.

Galeria
-

MediaTek está prestes a lançar o primeiro chip de celular de 4 ... -
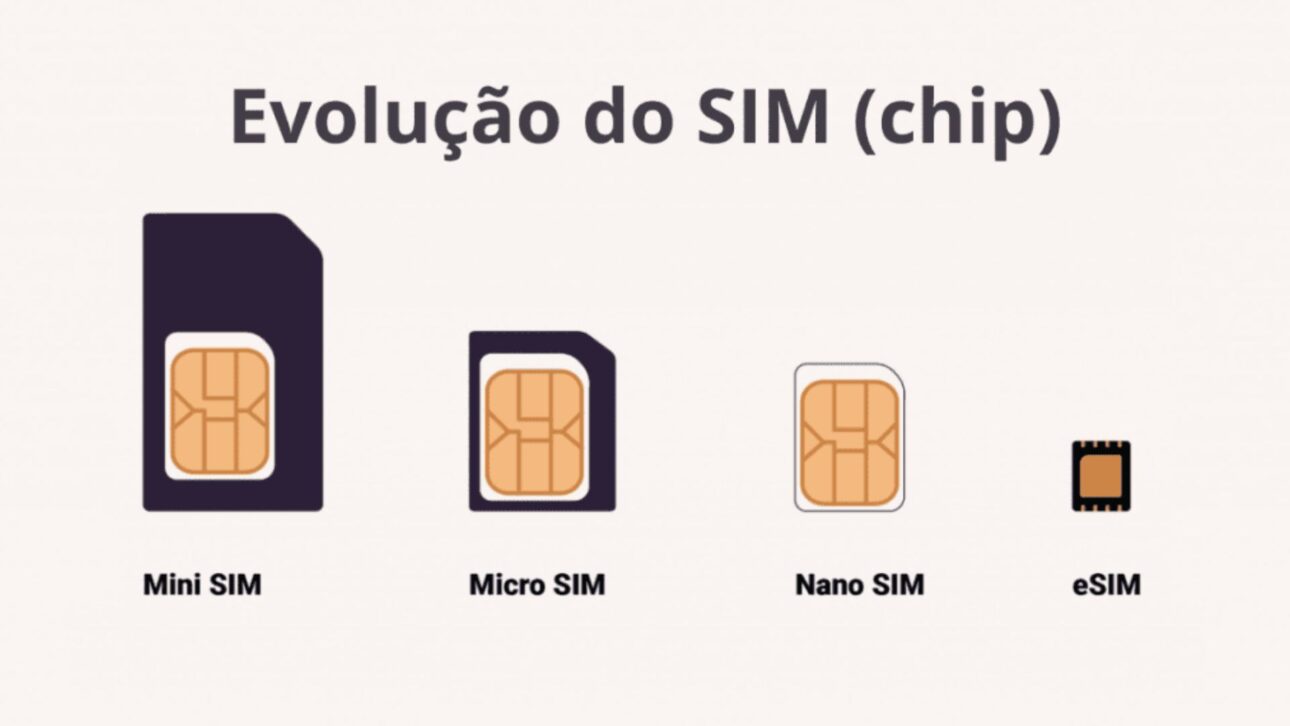
Chips de celulares estão com os dias contados! Apple, Samsung e ...
