Qual Caminho Se Faz Para Escolher Os Símbolos Por Subconjunto

Selecionando subconjuntos de símbolos na prática
O problema é mais comum do que parece. Você tem um conjunto grande de símbolos — variáveis, features, tokens, o que for — e precisa decidir quais realmente importam. A escolha por subconjunto não é trivial. Dependendo da ferramenta ou framework que você estiver usando, existem vários caminhos, mas a maioria das pessoas acaba seguindo três rotas principais. A maneira mais direta é usar seleção baseada em importância. Você treina um modelo rápido — random forest, XGBoost, até uma regressão logística com penalização L1 — e pega os símbolos com maior peso ou pontuação de importância. Em Python, isso se resume a algumas linhas usando scikit-learn. A função SelectFromModel faz exatamente isso: você passa o estimador e ela devolve o subconjunto dos features que superam um threshold. O threshold pode ser fixo, como a média das importâncias, ou médio, dependendo de quantos símbolos você quer manter. A segunda rota é a seleção recursiva. Recursive Feature Elimination, ou RFE, remove iterativamente os símbolos menos relevantes e recalcula o modelo a cada passo. É mais caro computacionalmente, mas costuma entregar resultados mais limpos. O problema é que o tempo de execução cresce rapidamente com o número de símbolos. Se você tem mais de mil features, prepare-se para esperar. Minha experiência com conjuntos do tipo texto-tokenizado mostra que RFE com 3 mil features levou cerca de 40 minutos em uma máquina razoável, enquanto a seleção direta por importância levou menos de dois.
A terceira rota, que eu recomendo raramente porque a maioria das pessoas superestima sua utilidade, é a busca exaustiva por subconjunto ótimo. Você avalia todas as combinações possíveis. Isso só funciona quando o universo de símbolos é pequeno — digamos, menos de 30. Passa disso e o espaço de busca cresce de forma exponencial e vira pesadelo. Eu já vi gente tentar com 50 features e o script rodar por horas sem produzir nada útil.
Um caso real que quase me custou o prazo
Trabalhando em um projeto de classificação de texto comEmbeddings de alta dimensão, me deparei com um problema específico: a seleção por importância de árvore descartava símbolos que eram irrelevantes isoladamente, mas extremamente poderosos quando combinados. O modelo de floresta via cada token como separado, então cruzamentos sinérgicos entre dois ou três termos pouco frequentes simplesmente sumiam do ranking. A solução foi híbrida. Usei primeira etapa com SelectFromModel para reduzir de 12 mil para 800 símbolos, depois apliquei uma versão personalizada de buscaForward Selection com validação cruzada estratificada. Não foi bonito, mas funcionou. O modelo final com 800 símbolos batia o anterior com 12 mil em F1-score e ainda treinava três vezes mais rápido. A parte chata é que essa abordagem híbrida não é automática — exige ajuste manual de parâmetros como o número de símbolos a adicionar em cada passo de forward selection. Sem isso, ou você para cedo demais ou gasta mais tempo do que o orçamento permite.

Armadilhas comuns que ninguém comenta
Vazamento de dados durante a seleção é o erro mais frequente. Se você faz feature selection antes de separar treino e teste, o subconjunto escolhido já viu informações do teste. O resultado é inflado e não generaliza. A correção é simples: embute o pipeline inteiro — seleção mais modelagem — dentro de uma etapa de cross-validation, usando Pipeline do scikit-learn. Assim, a seleção acontece apenas dentro dos folds de treino. Outro problema silencioso é a multicolinearidade. Dois símbolos altamente correlacionados podem competir pelo mesmo espaço de importância. Um deles recebe peso alto e o outro zero, mas ambos podem ser úteis. Nesses casos, a seleção gulosa simplesmente joga fora um deles sem razão real. Resolver isso exige pré-processamento — remover correlações acima de um threshold, digamos 0,95, antes de aplicar qualquer método de seleção — ou usar técnicas como LASSO estabilizado, que tende a distribuir peso entre features correlatas em vez de eliminar uma abruptamente.
Quando desistir da seleção por subconjunto
Às vezes, o melhor caminho é não escolher nada. Modelos como redes neurais profundas ou gradient boosting com árvores bemadas conseguem lidar com centenas ou milhares de features nativamente. A seleção de subconjunto faz sentido quando o custo computacional de treinar com tudo é proibitivo, ou quando a interpretabilidade do modelo final importa — diagnóstico médico, por exemplo, onde você precisa explicar porquê um preditor foi incluído ou excluído. Fora desses cenários, a seleção adiciona Complexidade sem ganho proporcional. Já perdi tempo refinando subconjuntos que não melhoravam a acurácia final em mais de 0,3 pontos percentuais, e mesmo assim o risco de overfit aumentava. Para quem quer implementar, o caminho mais confiável começa com scikit-learn. A documentação oficial cobre SelectFromModel, RFE e SequentialFeatureSelector, que é uma versão melhorada de forward-backward selection. Se precisar de algo mais robusto para dados textuais, olhe o TextFeatureSelection do pacote feature-engine, que lida especificamente com a esparcecidade típica de representations de texto. Para casos onde a seleção precisa levar em conta interações entre símbolos, o pacote mutmut ou abordagens baseadas em informação mútua podem ser alternativas válidas, embora exijam mais tuning. O que funciona varia conforme o domínio. Não existe atalho universal. O importante é validar cada decisão de subconjunto dentro de um pipeline fechado, medir o impacto real no modelo final, e ter a honestidade de reconhecer quando a seleção está mais atrapalhando do que ajudando.
Galeria
-
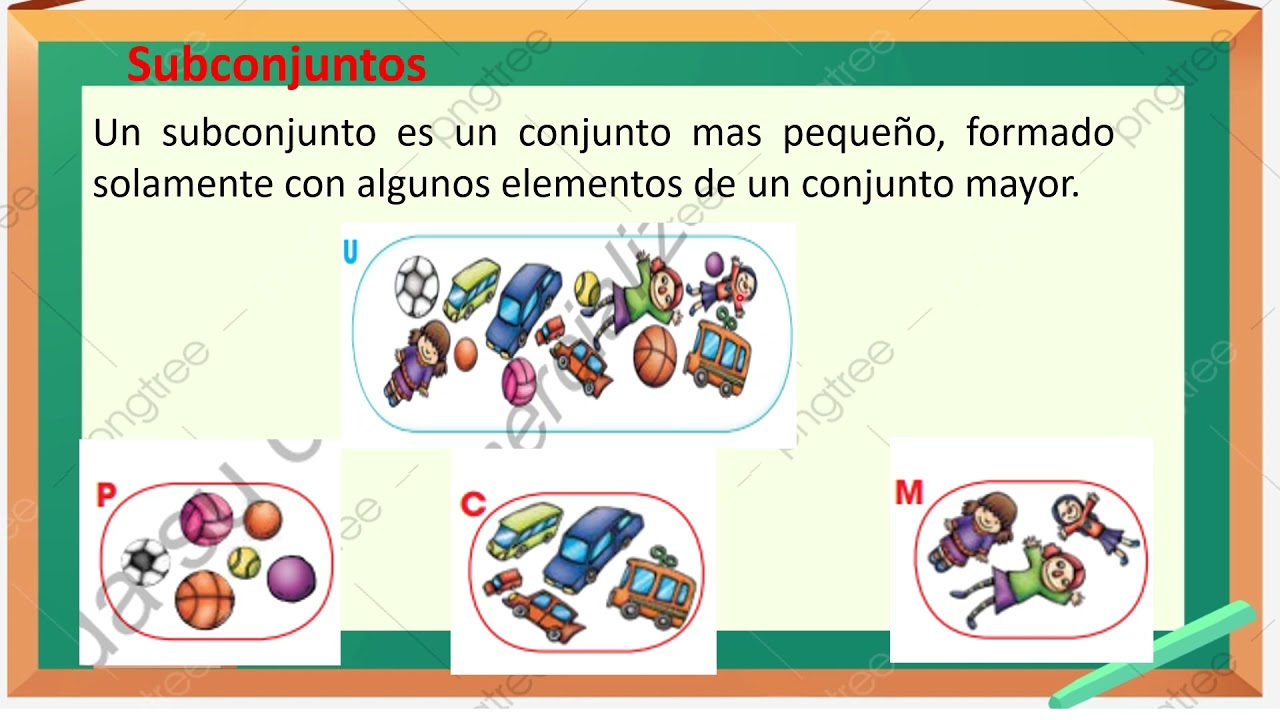
Qual Caminho Se Faz Para Escolher Os Símbolos Por Subconjunto - FDPLEARN -

Qual Caminho Se Faz Para Escolher Os Símbolos Por Subconjunto - RETOEDU -

quais os símbolos são usados quando relacionamos conjuntos e ... -
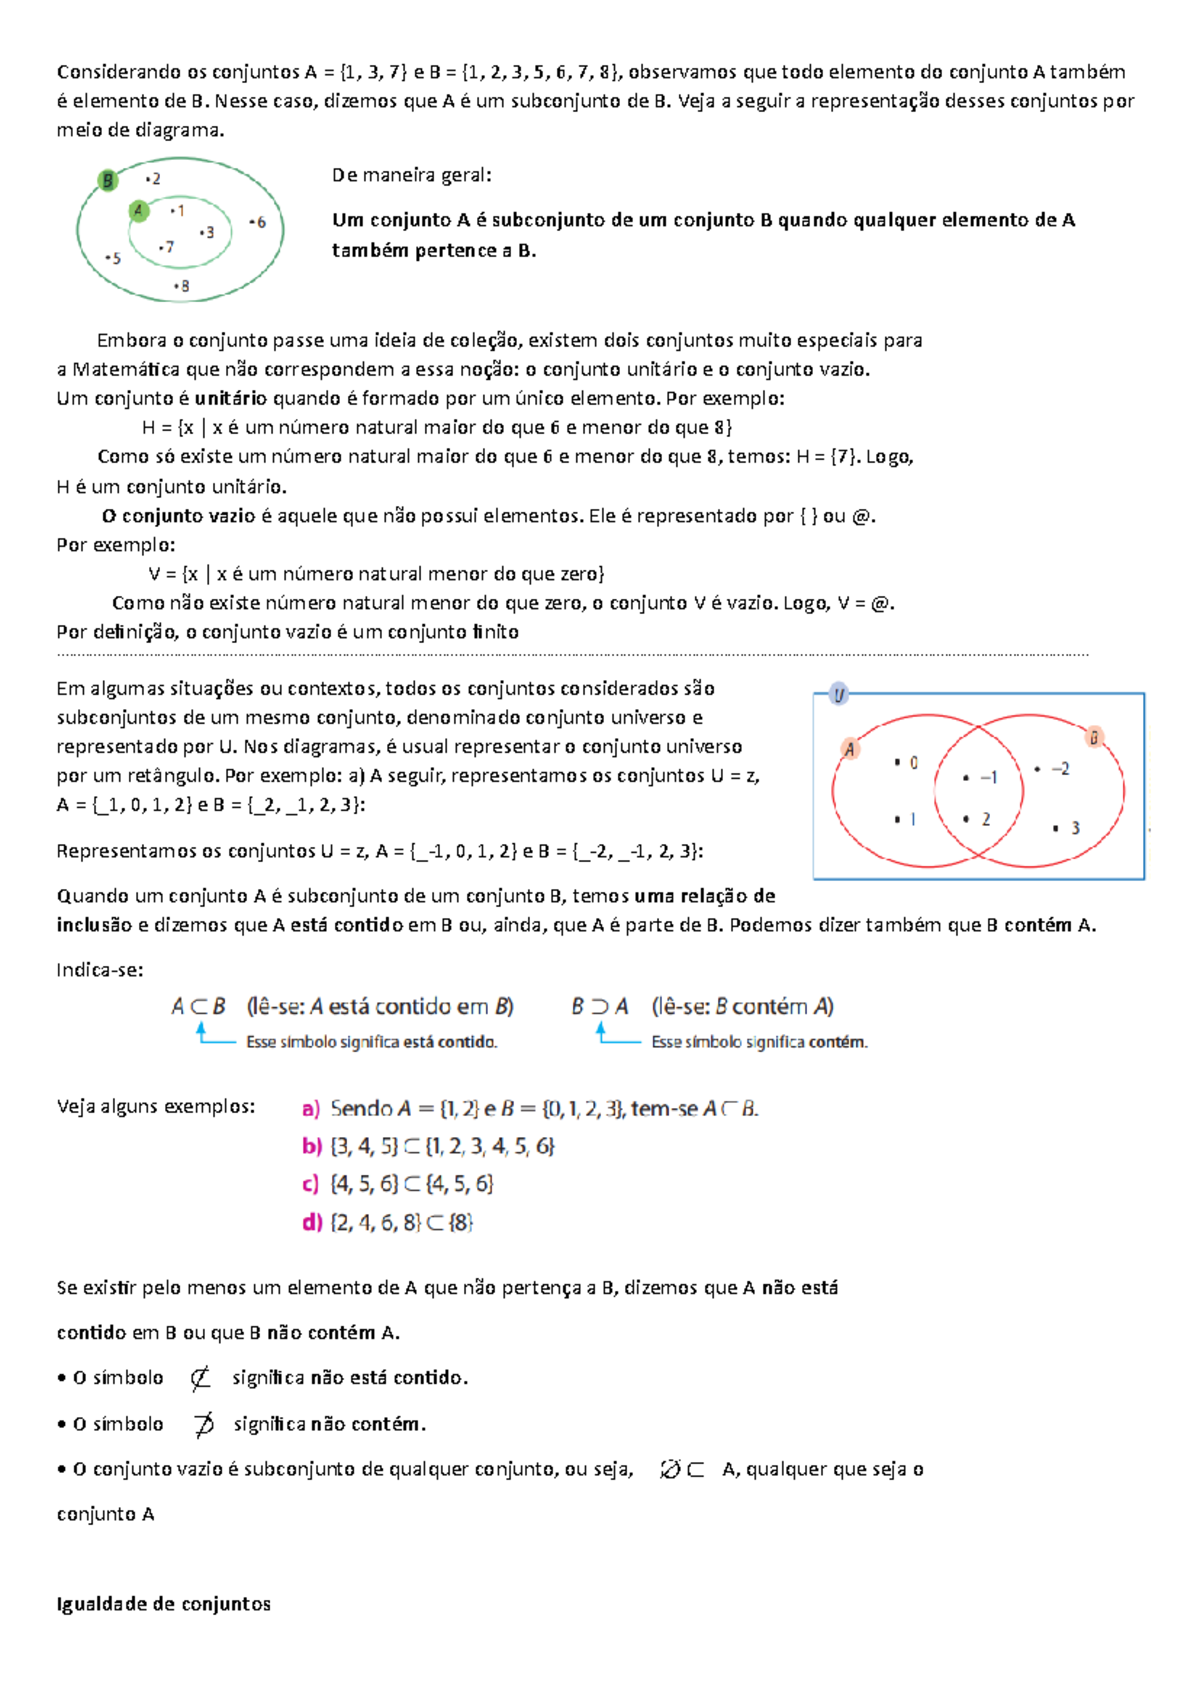
AULA 02 - Subconjuntos - Considerando os conjuntos A = {1, 3, 7} e B ...
