Qual Comando Podemos Contar Quantos Documentos Existem Na Nossa Base.
Contando documentos no MongoDB: o que funciona de verdade
Muita gente ancora em `count()` e se queixa depois que os números não batem. A razão é simples: o método antigo foi depreciado porque devolve resultados imprecisos em shards e replica sets. A solução oficial é `countDocuments()`. Eis como usar e quando ela te deixa na mão. A resposta curta, sem rodeio: `db.db.vendas.countDocuments({ status: "aprovado", data: { $gte: ISODate("2025-01-01") } })
O comportamento padrão espera varrer a coleção inteira quando não há índice que satisfaça a query. Isso significa que, em coleções grandes, o comando pode levar de segundos a minutos dependendo do hardware e da presença de índices relevantes. Se você precisa de velocidade e vive com números aproximados, existe o atalho `estimatedDocumentCount()`, mas ele não aceita filtros. Conta apenas o total estimado baseado nas estatísticas da coleção, o que costuma ser rápido porque consulta o plano de execução armazenado pelo motor. Aqui vai algo que eu aprendi na marra: em clusters sharded, o `countDocuments()` envia a query para todos os shards e agrega os resultados no mongos. Se algum shard estiver degradado ou com lag de replicação, a query pode demorar bem mais do que o esperado ou travar em timeout. No meu caso, uma collection de 40 milhões de documentos em quatro shards levou cerca de 11 minutos para um `countDocuments({ tipo: "A" })` sem índice cobrindo `tipo`. Eu coloquei um índice composto em `tipo` + `data`, e o tempo caiu para 23 segundos. Sem esse índice, o comando simplesmente fazia scan completo em cada shard. Outro ponto que ninguém avisa: `countDocuments()` ignora documentos marcados para deleção mas ainda presentes no WiredTiger cache até que o compactor libere o espaço. Em cargas pesadas de write com deletes frequentes, o número retornado pode ser levemente superior ao que você vê em um `find()` real, porque o documento tecnicamente ainda existe nos dados brutos até a limpeza ocorrer. Se isso importa pro seu relatório, vale rodar um `repairDatabase()` ou agendar fora do horário de pico, senão aceite a pequena discrepância e documente isso pra quem for cobrar consistência.
Se o seu cenário é puramente dashboards que precisam de número rápido e estão OK com uma estimativa, use `estimatedDocumentCount()`. Ela lê a metadata da coleção e responde em milissegundos, independente do tamanho. Se precisa de precisão com filtros complexos, `countDocuments()` é o caminho, mas verifique sempre se existe índice cobrindo os campos da query antes de rodar em produção. Senão você vai gastar tempo de CPU desnecessário e criar lock contention em collections que já sofrem. Resumo prático, porque às vezes a gente só quer copiar e colar: — Total exato: `db.colecao.countDocuments({})`
— Total estimado (rápido, sem filtros): `db.colecao.estimatedDocumentCount()`
— Total com filtro indexado: `db.colecao.countDocuments({ campo: valor })`
— Versão legacy, evitar: `db.colecao.count({})`

Coleção nova, pouquíssimos documentos, índice em construção: teste local antes de subir. Contagem em produção com filtros sem índice em tabelas acima de 50 milhões costuma ser o tipo de coisa que aparece às 3 da manhã quando o dashboard trava e o gerente pergunta por quê. Tenho esse hábito de rodar um `explain("executionStats")` antes de qualquer `countDocuments()` em coleções grandes, só pra garantir que o plano de execução não vai ser full collection scan.
Galeria
-

Como contar os arquivos em uma pasta usando PowerShell, CMD ou File ... -

Como contar os arquivos em uma pasta usando PowerShell, CMD ou File ... -
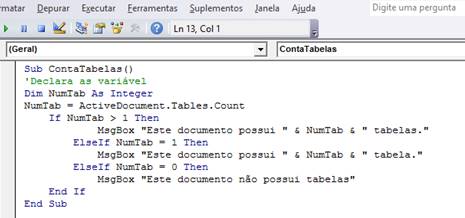
Macro para Contar quantas tabelas o documento possui -

Como contar os arquivos em uma pasta usando PowerShell, CMD ou File ...
