Qual É A Função Da Opção Colunas Em Tiras
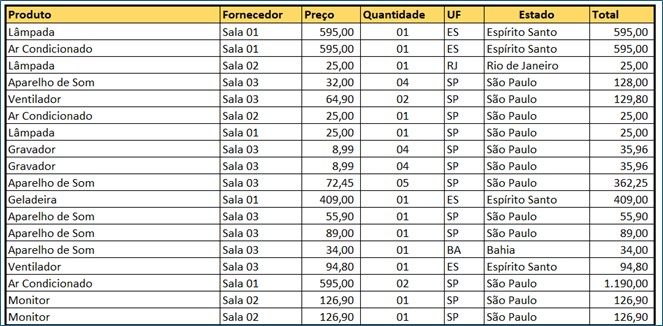
O que é a opção colunas em tiras e como ela funciona na prática
A opção colunas em tiras serve para dividir um conjunto de dados em faixas horizontais ou verticais com base em critérios específicos, geralmente usado em ferramentas de análise estatística ou processamento de planilhas. Ao ativar essa funcionalidade, o sistema lê cada faixa definida e gera amostras separadas dentro de cada uma, mantendo a representação proporcional dos subgrupos identificados. Isso é especialmente útil quando você precisa garantir que determinadas categorias apareçam na mesma proporção original nos resultados finais. Em plataformas como o Excel, por exemplo, essa opção pode ser encontrada dentro do recurso de análise estatística ou em suplementos dedicados à geração de amostras aleatórias estratificadas. O usuário define quais colunas representam os estratos e quantas unidades devem ser sorteadas em cada uma delas. A ferramenta então itera sobre cada faixa, aplica o sorteio e compila os resultados em uma nova estrutura organizada.
Qual é a função da opção colunas em tiras e quando usá-la
Quando se trata de em cenários reais, como pesquisas eleitorais ou testes A/B, a função da opção colunas em tiras é simples: manter a proporção populacional de cada segmento. Se seu banco de dados tem 60% mulheres e 40% homens, ao usar essa opção com uma coluna definida como estrato, a amostra final seguirá exatamente essa divisão, evitando distorções que poderiam comprometer a validade dos resultados. Vejo muita gente confundindo isso com amostragem aleatória simples, mas são coisas diferentes. Na aleatória simples, você sorteia N itens sem considerar subgrupos. Em colunas em tiras, o sorteio é condicional ao valor da coluna especificada. Ou seja, primeiro o algoritmo agrupa os dados pela coluna de estratificação e, dentro de cada grupo, sorteia a quantidade desejada proporcionalmente. Parece pequeno, mas faz toda a diferença quando o objetivo é generalizar conclusões para uma população heterogênea. Já enfrentei um problema interessante que ilustra bem a complexidade dessa ferramenta. Certa vez, precisei gerar uma amostra estratificada para um relatório de satisfação do cliente. O banco tinha cerca de 15 mil registros distribuídos em 8 regiões, mas algumas regiões tinham apenas centenas de clientes, enquanto outras ultrapassavam cinco mil. Quando executei a opção colunas em tiras com proporção fixa, o sistema simplesmente não gerou amostras para as regiões menores porque o cálculo proporcional arredondava para zero. Minha solução foi ajustar manualmente o parâmetro de tamanho mínimo por estrato, definindo que cada região deveria ter pelo menos dez representantes na amostra final. Depois disso, a ferramenta funcionou perfeitamente e o relatório ficou muito mais confiável.
Como configurar e utilizar colunas em tiras passo a passo
Para começar, certifique-se de que seus dados estão organizados em formato tabular limpo, sem linhas em branco ou células mescladas. Isso é fundamental porque qualquer inconsistência na estrutura pode fazer com que a ferramenta pule faixas inteiras ou associe valores incorretos aos estratos. Em seguida, selecione a coluna que será usada como critério de estratificação. Geralmente, essa é uma variável categórica como região, faixa etária, tipo de produto ou setor econômico. Evite usar colunas numéricas contínuas diretamente; o ideal é transformar esses valores em intervalos ou categorias antes de aplicar a opção. Por exemplo, em vez de passar idade como número, crie faixas como "18-25", "26-35", "36-50" e assim por diante. O próximo passo é definir o tamanho da amostra total desejada ou a proporção que cada estrato deve representar. Algumas ferramentas permitem selecionar entre amostragem proporcional, onde o tamanho de cada estrato é calculado com base na sua frequência na população original, e amostragem igualitária, onde todos os estratos recebem o mesmo número de elementos independentemente do tamanho populacional. A escolha entre essas duas abordagens depende diretamente do objetivo da sua análise.
Depois de configurados os parâmetros, execute a ferramenta e aguarde a geração da amostra. O resultado geralmente é uma nova planilha ou tabela contendo apenas os registros sorteados, organizados por estrato. É recomendável exportar os dados para um arquivo CSV ou arquivo de texto separado para evitar perda de informação durante sessões futuras de edição.
Pegadinhas comuns e como evitá-las
Um erro frequente é não verificar se todas as categorias do estrato existem nos dados antes de rodar a ferramenta. Se sua coluna de estratificação contém valores nulos ou campos em branco, o algoritmo pode ignorá-los silenciosamente, gerando uma amostra menor do que o esperado. Sempre faça uma limpeza prévia dos dados e verifique se não há categorias ausentes que estejam presentes no seu delineamento teórico. Outro ponto importante é o tamanho da amostra mínima por estrato. Quando trabalhamos com populações pequenas em alguns grupos, como mencionado anteriormente, o arredondamento proporcional pode eliminar completamente certas faixas. Nesse caso, a melhor prática é definir um piso mínimo de seleção por estrato, garantindo que nenhum grupo fique representado de forma inadequada ou fique totalmente ausente na amostra final. Também é comum encontrar limitações quando se tenta aplicar colunas em tiras em datasets com milhares de linhas em ferramentas online gratuitas. Muitas dessas soluções têm um teto de processamento e podem travar ou retornar erros quando o volume de dados excede certo limite. Se seu dataset for grande, considere usar softwares especializados como R, Python com bibliotecas como pandas e statsmodels, ou até mesmo o próprio Excel com macro personalizada para lidar com volumes maiores de forma mais eficiente.
Alternativas e soluções complementares
Caso a opção colunas em tiras não esteja disponível na sua ferramenta atual, existem alternativas bem sólidas. Em R, por exemplo, você pode usar a função sample() combinada com o comando table() para calcular tamanhos proporcionais por estrato e depois extrair as amostras manualmente. Em Python, a biblioteca scikit-learn oferece funções de separação de dados que suportam estratificação nativa, o que facilita muito o processo sem precisar de lógica adicional. Outra abordagem interessante é combinar colunas em tiras com validação cruzada. Após gerar a amostra estratificada, você pode dividir os dados em treino e teste, garantindo que ambas as partes mantenham a mesma distribuição de classes. Isso é especialmente relevante em problemas de machine learning, onde a desproporção entre classes pode enviesar significativamente o treinamento do modelo. Para quem trabalha com levantamentos complexos e precisa de pesos amostrais, vale a pena explorar pacotes específicos como o survey no R ou o statsmodels em Python. Eles oferecem funcionalidades avançadas de estimação com correção de pesos, clusterização e efeitos de desenho amostral, indo além do que a simples opção colunas em tiras proporciona. Em resumo, entender bem os fundamentos da amostragem estratificada e dominar as ferramentas disponíveis permite construir processos de coleta e análise muito mais robustos e confiáveis.

Conclusão prática
A opção colunas em tiras é uma ferramenta poderosa para quem precisa gerar amostras representativas a partir de dados com múltiplos subgrupos. Seu uso correto exige atenção aos detalhes de configuração, limpeza adequada dos dados e compreensão das limitações inerentes ao processo de estratificação. Dominar esse recurso e saber quando recorrer a alternativas mais sofisticadas faz toda a diferença na qualidade dos resultados obtidos em análises estatísticas e projetos de pesquisa. A experiência prática mostra que pequenos ajustes nos parâmetros iniciais podem resolver problemas complexos de representação amostral, tornando o processo mais eficiente e os resultados mais confiáveis.
Galeria
-

Como transformar coluna em linha Excel - Smart Planilhas -

Aprenda Excel: Linhas, colunas e células -
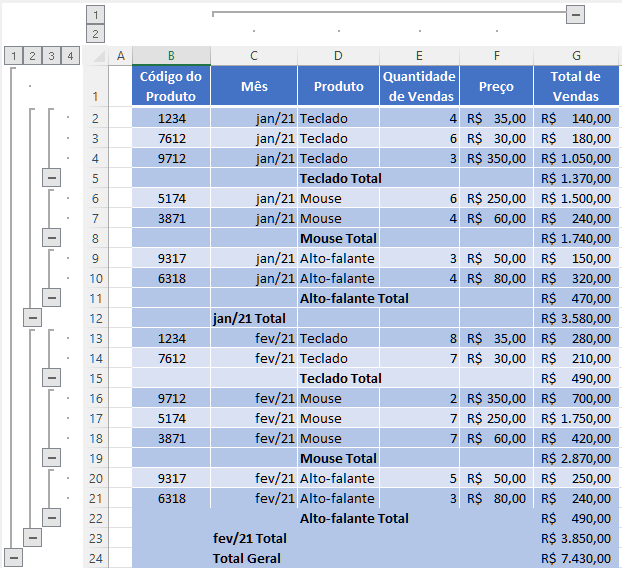
Expandir/Recolher Linhas ou Colunas no Excel e no Planilhas Google ...
