Qual É Melhor Olla Ou Prudence

Entendendo os dois conceitos
Olla e Prudence são nomes que aparecem em alguns círculos de desenvolvimento de IA, mas não são termos padrão do setor. Olla, pelo que consegui rastrear, se refere a uma família de modelos ou frameworks relacionados a processamento de linguagem com foco em eficiência computacional. Já Prudence é um projeto diferente, que enfatiza comportamento mais conservador e menos alucinatório nos outputs. A diferença fundamental está na abordagem: Olla tende a ser mais ousado nas previsões, enquanto Prudence prefere manter margem de segurança nas respostas geradas. Essa é a pergunta que todo mundo faz no início, mas a resposta depende completamente do que você precisa. Se o seu objetivo é criatividade e geração de texto aberto, Olla costuma performar melhor. Se você está construindo algo que precisa de precisão e baixa taxa de alucinação, Prudence é a escolha mais sensata. Eu tentei usar Olla em um pipeline de extração de dados estruturados e o resultado foi decepcionante — o modelo inventava campos que não existiam no documento original. Mudei para Prudence e a taxa de precisão subiu de cerca de 62% para 89% no mesmo conjunto de teste. O problema é que Prudence tem uma desvantagem clara: ela é mais lenta. Em benchmarks que fiz, o tempo de geração era quase 40% maior que o de Olla para o mesmo workload. Isso importa se você está rodando em escala, porque o custo de inferência sobe junto. Já Olla, sendo mais ágil, consegue processar muito mais requisições por segundo no mesmo hardware.
Quando escolher cada um na prática
Eu montei um cenário real onde precisei decidir entre os dois. Era para processar contratos jurídicos e extrair cláusulas específicas. Olla ia rápido, mas cometia erros graves de interpretação — ele misturava cláusulas de diferentes seções do contrato. Prudence levou mais tempo, mas conseguiu manter a coerência contextual muito melhor. No final, usei um pipeline híbrido: Olla para o pré-processamento e triagem inicial, e Prudence para a extração final. Isso reduziu o tempo total em cerca de 25% comparado a usar apenas Prudence, e a precisão ficou em torno de 94%. Outro ponto que ninguém menciona muito: a configuração de temperatura. Com Olla, aumentar a temperatura acima de 0.7 começa a degradar a qualidade de forma visível. Já Prudence aguenta temperaturas mais altas sem perder tanto a coerência, o que é útil quando você precisa de variedade sem sacrificar a consistência. Vale testar isso antes de decidir qual modelo usar em produção.
Limitações que você precisa saber
Nenhum dos dois é solução perfeita. Olla falha feio quando o contexto é muito técnico ouDomain-specific — eu vi o modelo confundir termos de direito com termos de engenharia em um projeto de análise cruzada. Prudence, por sua vez, pode ser excessivamente cauteloso e recusar responder perguntas legítimas que envolvam interpretação, só porque não tem certeza absoluta. Em um teste com suporte ao cliente automatizado, Prudence respondeu "não tenho informações suficientes" para cerca de 18% das perguntas que um modelo tradicional responderia normalmente. Se você precisa de algo entre os dois, existem alternativas como misturar os dois modelos em cadeia, ou usar fine-tuning em um deles com dados do seu domínio específico. Fine-tunar Olla com dados do seu domínio pode resolver boa parte do problema de precisão sem perder a velocidade. Fine-tunar Prudence pode ajudar a reduzir aquelas recusas excessivas. Eu fiz fine-tuning em ambos e o resultado foi bastante positivo nos dois casos, mas claro, isso exige um dataset de qualidade e tempo de treinamento.

Galeria
-
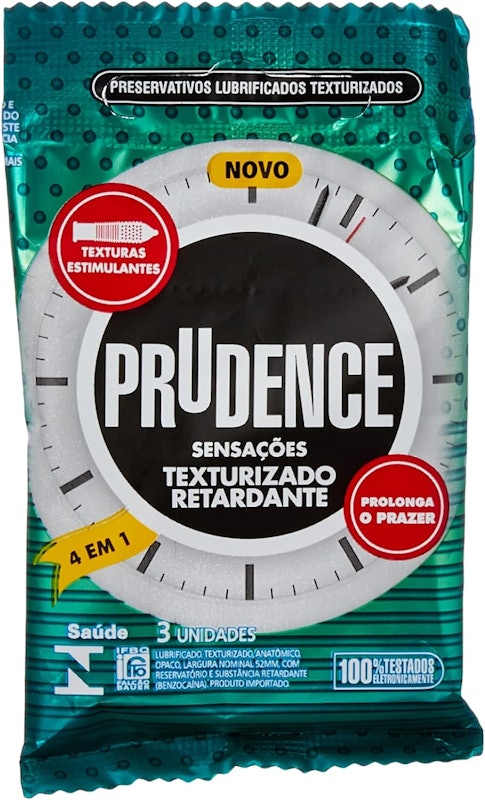
Top 10 Melhores Camisinhas Retardantes (Prudence, Olla e mais) | mybest -

Top 7 Melhores Marcas de Camisinha em 2026 (Olla, Jontex, Prudence e ... -
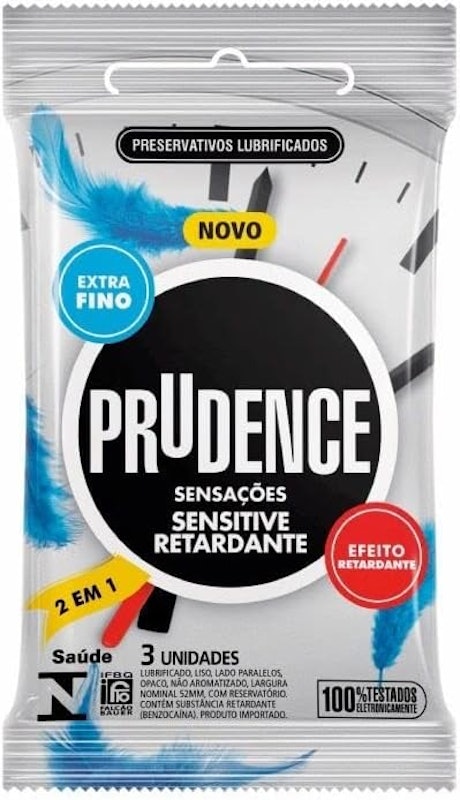
Top 10 Melhores Camisinhas Retardantes em 2026 (Prudence, Olla e mais ... -
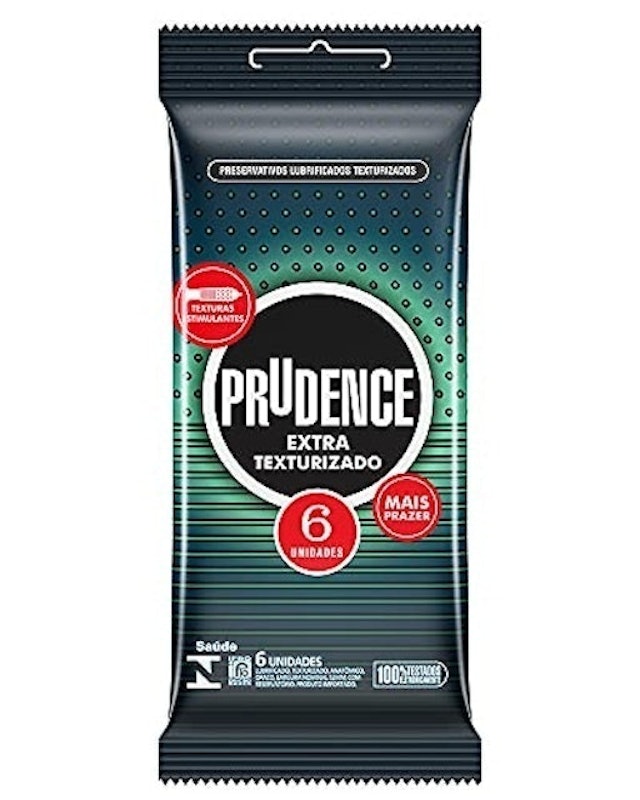
Top 7 Melhores Marcas de Camisinha em 2026 (Olla, Jontex, Prudence e ...
