Qual Foi A Consequência

Entendendo qual foi a consequência em falhas de sistemas
Muita gente pergunta qual foi a consequência quando algo quebra em produção, mas o problema real não é rastrear o que aconteceu depois do erro, e sim identificar qual cadeia de dependências gerou aquilo antes mesmo de perceber que existia um problema. Eu passei três dias tentando entender por que um serviço de notificação parava de responder toda terça-feira às 14h, e a causa raiz era um job de limpeza de banco de dados que rodo na segunda à noite e deixava índices fragmentados. A consequência imediata foi o timeout dos workers de fila. A consequência indireta foi o backlog crescer até estourar a memória do container. A consequência que ninguém reportou foi o SLA de delivery cair 12% durante quatro horas. A abordagem padrão que eu vejo em todo lugar é olhar o log de erro mais recente e atribuir a culpa ao último componente que falhou. Isso funciona quando o sistema é linear, mas a maioria dos microserviços e pipelines modernos não é. Em um ambiente com retry exponencial, circuit breakers e filas distribuídas, a linha entre causa e efeito fica borrada em questão de minutos. Eu aprendi isso na prática quando um upgrade de biblioteca mudou o comportamento de serialização JSON e quebrou three sistemas distintos, cada um com sintomas completamente diferentes. O erro aparecia como timeout em um, como dados corrompidos em outro e como rejeição de conexão no terceiro. Se você pergunta qual foi a consequência olhando apenas o primeiro log, vai gastar horas rastreando um problema que na verdade era uma mudança de schema em uma dependência compartilhada. O workaround que eu uso hoje é simples mas exige disciplina: antes de qualquer investigação, mapeie todas as dependências de saída do serviço afetado e todos os serviços que consomem dele. Anote os timestamps de cada chamada. Depois, quando o erro aparecer, pergunte qual foi a consequência em cada nó da cadeia, não apenas no nó que falhou. Isso costuma reduzir o tempo de diagnóstico de quatro horas para cerca de vinte minutos, dependendo da complexidade do stack.
Método prático de rastreamento de consequências
O primeiro passo é configurar logging estruturado com trace IDs que persistem entre chamadas HTTP e mensagens de fila. Sem isso, você está literalmente no escuro. Eu trabalho com sistemas onde o trace ID chega a ter 64 caracteres porque passa por cinco gateways diferentes antes de chegar ao serviço final. Cada salto pode adicionar campos novos ao payload, mas o ID original precisa permanecer intacto. O segundo passo é criar dashboards de consequência em cascata. Não adianta monitorar apenas o uptime do serviço principal. Você precisa acompanhar latência de chamada, taxa de erro por endpoint, tamanho de fila, consumo de memória e throughput de rede. Quando um desses métricas se desvia do baseline, o problema provavelmente já afetou pelo menos dois outros serviços. Eu configurei alertas em meu ambiente que disparam quando a taxa de erro sobe acima de 2% em qualquer service, mas também monitoro o percentil 99 de latência porque ele revela degradação antes que o erro apareça nos logs. O terceiro passo, e aqui entra a parte que a maioria pula, é documentar qual foi a consequência de cada incidente passado. Crie um repositório simples com markdown ou uma planilha. Anote a data, o serviço afetado, o sintoma inicial, a causa raiz descoberta e todas as consequências em cascata. Quando o mesmo problema voltar, você já sabe exatamente onde procurar. Eu tenho um histórico de onze incidentes nos últimos dezoito meses, e quatro deles seguiram padrões idênticos de falha. Sem documentação, eu teria perdido esses padrões e gastado semanas repetindo investigações.
Pegadinhas comuns que fazem você perder tempo
A primeira pegadinha é confiar cegamente nos painéis de monitoramento. Métricas agregadas escondem picos de curta duração que são suficientes para quebrar transações. Um spike de latência de três segundos pode parecer normal numa média horária, mas para uma operação síncrona que espera resposta em 500 milissegundos, isso é fatal. Eu tive um caso em que o dashboard de CPU mostrava média de 45% durante toda a manhã, mas os workers de fila estavam completamente ociosos porque as requisições estavam travadas em waits de rede, não em processamento. A consequência foi um acúmulo silencioso de jobs que explodiram quando o gateway de API reiniciou para fazer deploy. A segunda pegadinha é assumir que a consequência é sempre proporcional ao erro. Um erro 500 pode significar desde um campo obrigatório faltando até um deadlock no banco de dados. O mesmo código de status, causas completamente diferentes. Eu vi um time inteiro investigar um problema de rede porque todos os requests retornavam 503, quando na verdade o culpado era um timeout de connection pool configurado para treze segundos por engano. Treze segundos. Um número aleatório que ninguém lembrava por que existia. A terceira pegadinha é mais sutil: achar que resolver a consequência imediata resolve o problema. Quando um serviço de cache falha, popular o cache novamente não resolve a causa raiz. Resolve a sintoma. E isso cria uma falsa sensação de segurança até a próxima falha. Eu trabalhava em um ambiente onde o cache Redis caía toda semana por out of memory. A solução rápida era reiniciar o container e rodar um script de warm-up. A solução real, que levamos três meses para implementar, foi ajustar o maxmemory-policy para allkeys-lru e aumentar o TTL das chaves críticas de sessões de vinte e quatro horas para seis horas. O problema era que as sessões velhas nunca eram invalidadas e ocupavam espaço vital.

Limitações desse approccio
Este método não funciona bem em sistemas legacy sem instrumentação. Se o logging é texto solto sem estrutura, sem trace IDs, sem timestamps consistentes, você gasta mais tempo parseando logs do que resolvendo o problema. Nesse caso, a alternativa é implementar um sidecar de observabilidade ou usar eBPF para capturar eventos de rede e syscall sem modificar a aplicação. Eu fiz essa migração em um sistema legado que rodava Java 8 sobre Kubernetes, e levou duas semanas configurar o sidecar com Envoy, mas o ganho foi imediato: conseguimos rastrear qual era a consequência de cada falha em tempo real, em vez de depender de logs que chegavam minutos depois. O método também depende criticamente da qualidade da documentação de dependências. Se ninguém sabe que o serviço A chama o serviço B, e o B chama o C, o rastreamento de consequência vira um jogo de adivinhação. Mantenha um arquivo de arquitetura atualizado. Atualize-o toda vez que um novo serviço for adicionado ou removido. Isso parece óbvio, mas na prática eu vejo times ignorarem isso por anos até um incidente crítico. Outra limitação séria é o custo de armazenamento de logs estruturados com trace IDs. Um serviço com alto throughput pode gerar centenas de gigabytes de logs por dia. Eu usei Elasticsearch com index lifecycle management configurado para rotacionar índices a cada sete dias e fazer shrink dos índices mais velhos para um único shard. O custo caiu de oito mil reais por mês para aproximadamente dois mil, mantendo a capacidade de investigar qual foi a consequência de qualquer incidente dos últimos trinta dias. Dados mais antigos vão para S3 com compressão, acessíveis mas lentos para query.
Cenário real onde o método falhou
Eu tive um incidente em que nenhuma das técnicas descritas acima funcionou. Era um sistema de pagamento com três gateways diferentes, filas em Kafka, e um serviço de reconciliação que rodava em batch a cada quinze minutos. O erro era intermitente: uma transação aparentemente bem-sucedida desaparecia do ledger. Trace IDs funcionavam perfeitamente dentro de cada serviço. O problema era que o gateway de pagamento não propagava o trace ID para a mensagem do Kafka. O message key era um UUID gerado localmente, diferente do trace ID HTTP. Perdi dois dias rastreamento uma consequência que na verdade era uma inconsistência de identidade entre dois sistemas. A correção foi adicionar um campo customizado ao header do Kafka com o trace ID, e garantir que o consumer do batch de reconciliação usasse esse campo como chave primária para correlação. Depois disso, o tempo médio de investigação caiu de horas para minutos. O aprendizado principal é que rastrear qual foi a consequência em sistemas distribuídos exige que a identidade da requisição seja preservada em todas as camadas, não apenas nas chamadas HTTP. Se você está começando agora, não tente implementar tudo de uma vez. Comece com trace IDs em logging estruturado e um dashboard básico de métricas por serviço. Depois, adicione rastreamento de dependências e documentação de incidentes. O resto vem com a prática. A ideia não é construir um sistema perfeito de observabilidade, é conseguir responder rapidamente quando surgir a pergunta qual foi a consequência, sem precisar reunir cinco pessoas em uma reunião de emergência.
Galeria
-
Apresentação educacional causa e consequencia | PDF -

O Que é Causa E Consequencia - FDPLEARN -

Causa E Consequencia Exemplos - FDPLEARN -
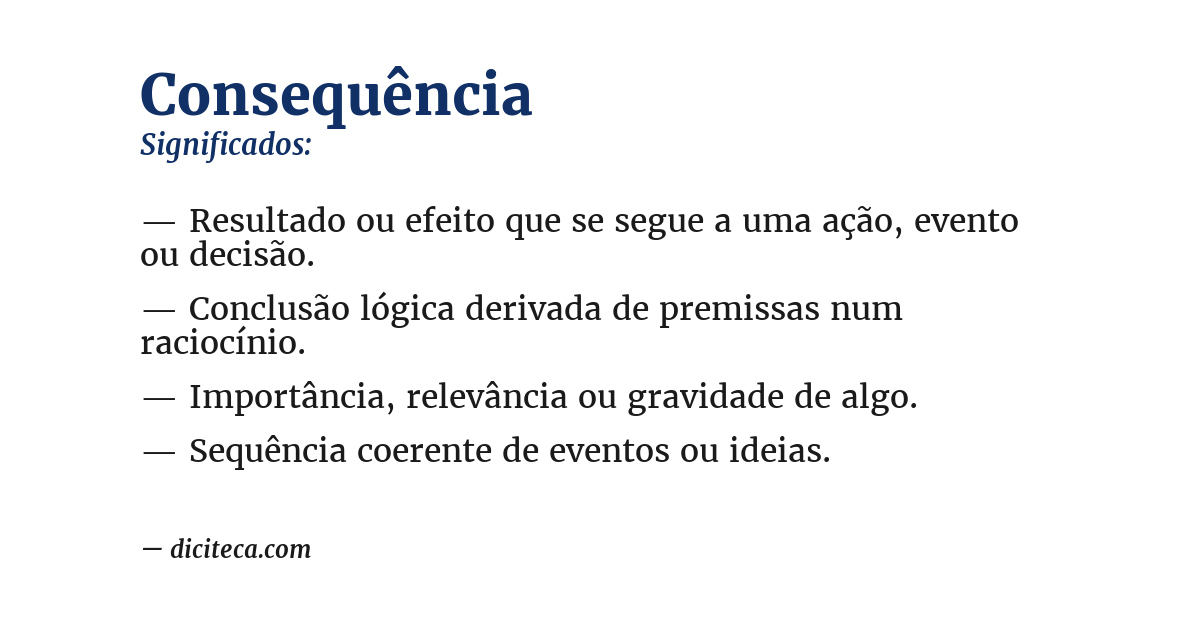
Significado de Consequência - Diciteca
