Qual São Os Tipos De
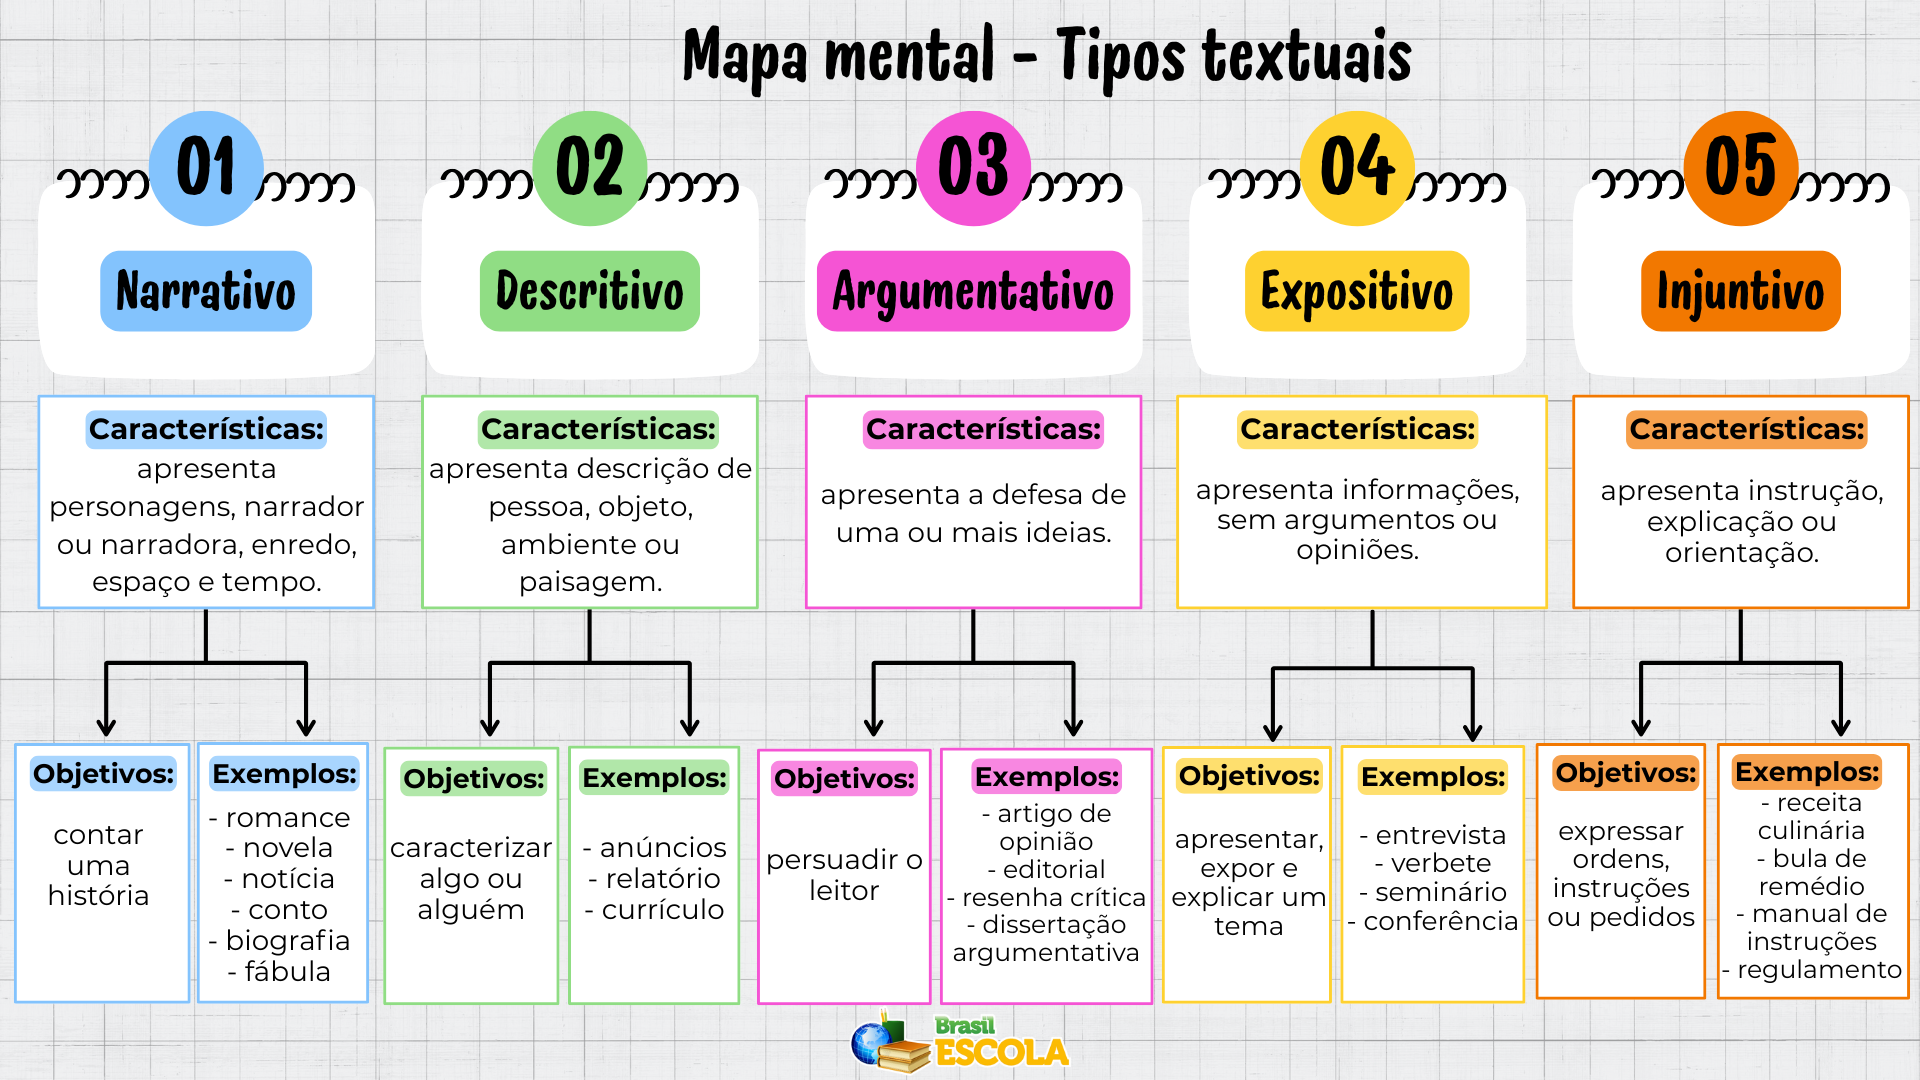
O que você precisa saber sobre classificação de tipos
Se você está começando agora e se pergunta qual são os tipos de arquivos, formatos ou estruturas que precisa dominar no dia a dia, a resposta curta é: depende do trabalho que você faz. Mas tem um padrão que aparece o tempo todo. No meu caso, trabalhando com integração de dados há anos, os tipos que mais aparecem são:
Textuais: CSV, JSON, XML, TSV. CSV é o mais usado por simplicidade, mas tem uma armadilha que muita gente não vê: separadores regionais. No Brasil usamos vírgula como separador decimal. Um arquivo exportado de um sistema americano pode ter campos com vírgula dentro de aspas e quebrar todo o parse quando você tenta importar. A solução mais confiável é sempre especificar explicitamente o encoding e o delimitador na sua leitura, nunca confiar no padrão. Binários: PDF, imagens (PNG, JPG), arquivos compactados (ZIP). Estes exigem bibliotecas específicas para manipulação. Não tente ler binário como texto.
Estruturados: Bancos de dados relacionais com tipos NUMERIC, VARCHAR, DATE, BOOLEAN. A questão aqui é conversão. Um campo que parece data pode estar vindo como string com formato inconsistente. Já vi systems enviar "2024-01-15", "15/01/2024" e "Jan 15, 2024" no mesmo campo. O workaround que funcione para mim foi normalizar tudo com expressão regular antes de qualquer processamento, mapeando os três formatos para um padrão único. NoSQL / documentos: BSON, avro, parquet. Parquet ganhou força porque permite compressão eficiente e schema enforcement. Se você trabalha com grandes volumes e consultas analíticas, vale a migração de CSV para parquet. O ganho em performance de leitura costuma ser de 5x a 10x em comparação com texto plano, especialmente em queries que leem apenas parte das colunas.
tipos avançados que você encontra na prática
O que ninguém te conta é que existirem tipos compostos e aninhados muda completamente a forma como você trata os dados. Um JSON com arrays dentro de objetos dentro de arrays não pode ser flattado com uma função genérica. Eu gastaria horas tentando parsear um payload que vinha de uma API de pagamento com campos variáveis dependendo do método escolhido. A solução foi criar um mapeador manual com validação schema-first usando algo como pydantic ou jsonschema antes de processar qualquer dado. Também tem os tipos geoespaciais (GeoJSON, WKT) e os tipos temporais com timezone. Data sem timezone é uma fonte constante de bugs. Um timestamp anotado como "2024-06-15T10:00:00" sem sufixo pode significar coisas completamente diferentes dependendo de onde o servidor está. Sempre armazene e trate como UTC internamente.

quando nenhum tipo resolve
A realidade é que em muitos projetos os dados chegam sujos. Formatos misturados, colunas vazias que o sistema preenche com "null" literal (string) em vez de NULL real, caracteres especiais quebrados na transferência. Nesses casos, o ideal é construir uma camada de ingestão que valide e transforme antes de jogar no banco ou na pipeline de processamento. Isso aumenta o trabalho inicial em cerca de 30% a 40%, mas elimina o retrabalho que normalmente consome o dobro do tempo depois. Se você precisa de bibliotecas práticas, algumas opções sólidas em Python incluem: pandas para tabulares, orjson ou ujson para JSON rápido, pyarrow para parquet, e thefuzz para fuzzy matching de strings quando os campos não batem exatamente. Em JavaScript, a biblioteca d3-dsv lida bem com CSVs irregulares e a própria API built-in de TextDecoder resolve a maior parte dos problemas de encoding sem dependências externas.
Galeria
-
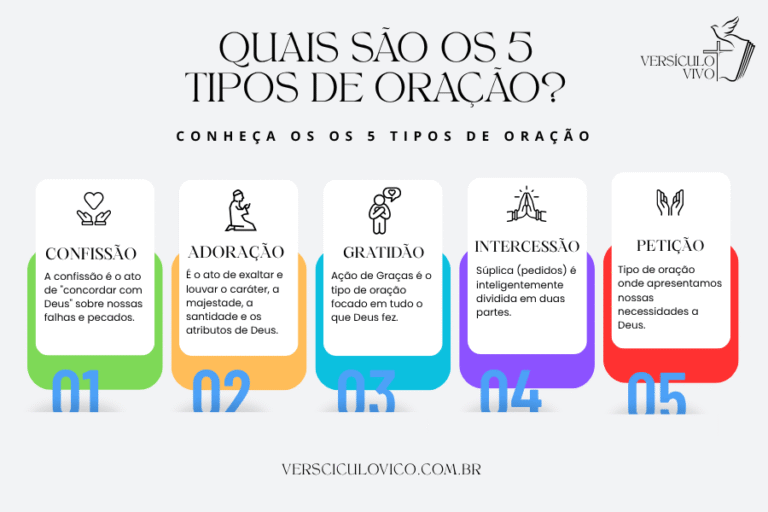
Quais são os 5 tipos de oração? -

Quais São Os Tipos De Texto _ Textos dramáticos: o que são, tipos ... -

Tipologia Textual: Conheça Os Principais Tipos De Textos! – TMBI -

15 tipos de texto e suas características - aprenda quais são
