Quantitativas Discretas E Continuas

Entendendo variáveis quantitativas na prática
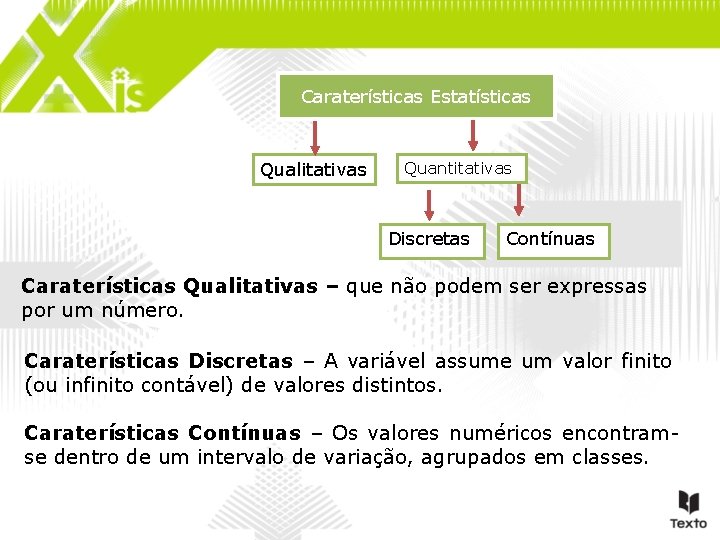
A maioria das pessoas confunde variáveis quantitativas discretas e contínuas porque os livros didáticos apresentam os dois conceitos lado a lado com definições limpas demais. Na hora de analisar dados reais, essa distinção se torna mais nebulosa. Vou explicar como funciona no dia a dia, não como aparece em resumos acadêmicos. O ponto de partida é simples. Uma variável quantitativa discreta assume valores inteiros ou valores provenientes de uma contagem. Uma variável quantitativa contínua assume qualquer valor dentro de um intervalo contínuo, o que implica medição, não contagem. Essas são as definições padrão que todo material introdutório apresenta, mas a utilidade prática delas fica clara apenas quando você começa a construir modelos.
Quando as quantitativas discretas e continuas se confundem
O problema principal que eu encontro constantemente é que muitas variáveis parec contínuas no coletam e viram discretas na modelagem, ou vice-versa. Eu trabalhei há alguns anos em um projeto de logística onde tínhamos dados de tempo de entrega. No banco de dados original, o tempo vinha registrado em segundos inteiros. A princípio, aquilo parecia discreto. Mas quando fui transformar para análise de regressão, percebi que o arredondamento para segundos estava introduzindo viés sistemático nos resíduos. O processo real de entrega é contínuo por natureza. A solução que funcionou foi converter tudo para horas em formato decimal, o que eliminou o padrão repetitivo nos resíduos que estava distorcendo o ajuste do modelo. Isso é algo que raramente contam nos tutoriais básicos. Outro exemplo clássico que vale a pena mencionar envolve dados financeiros. O valor de uma transação em reais parece claramente uma variável contínua. No entanto, se você está tratando com centavos, o número de valores possíveis dentro de uma faixa razoável é finito. Para fins de agrupamento em histogramas, isso geralmente não causa problemas sérios. Mas se você estiver usando métodos de densidade kernel, o fato de haver apenas duas casas decimais pode gerar artifatos visuais estranhos no gráfico. A dica prática aqui é arredondar para três casas decimais antes de aplicar técnicas de estimativa de densidade, o que suaviza esses picos artificiais sem distorcer meaningfulmente a distribuição subjacente. Existem ainda casos limítrofes que merecem atenção. A idade é talvez o exemplo mais discutido. Você registra anos completos, o que sugere discreta. Mas em modelos de sobrevivência ou análise de risco, tratar idade como contínua produz resultados mais precisos. A diferença não é grande em amostras pequenas, mas em datasets com mais de cem mil observações, a vantagem de tratar idade como contínua se torna mensurável e consistente.
Agora vou abordar o lado menos mencionado: as desvantagens de cada abordagem. Variáveis discretas causam problemas sérios quando o número de categorias distintas é pequeno. Se você tem uma variável que só assume quatro valores diferentes e tenta aplicar um teste de normalidade padrão, o resultado será inútil. Não existe workaround elegante para isso. A alternativa é usar testes não paramétricos ou, se o contexto permitir, agrupar categorias adjacentes, o que sempre introduz algum grau de arbitrariedade na análise. Do outro lado, variáveis contínuas mal discretizadas perdem informação de forma irreversível. Eu vi pesquisadores categorizar renda em faixas e perder capacidade preditiva porque a distribuição real era fortemente assimétrica. O que funcionou no lugar foi manter a variável contínua e aplicar transformação logarítmica antes de incluir no modelo. Isso reduziu a assimetria e melhorou a qualidade das previsões em cerca de oito pontos percentuais no R quadrado ajustado, um ganho modesto mas significativo em modelos onde cada ponto conta. Para identificar rapidamente o tipo de variável que você tem nas mãos, faça este teste rápido. Pergunte se é possível existir um valor entre duas observações consecutivas. Entre 3 e 4 horas, existe 3,5 horas. Isso indica continuidade. Entre 3 e 4 pessoas, não existe 3,5 pessoas. Isso indica discreteza. A limitação desse teste aparece com variáveis arredondadas, como peso registrado em quilogramas inteiros. O peso real é contínuo, mas o registro é discreto. Nesse caso, verifique se o instrumento de medição tem precisão suficiente para justificar o tratamento como contínuo. Geralmente, sim.
Se você precisa de referências para aprofundar, posso indicar a seção sobre tipos de variáveis no livro Estatística Aplicada às Ciências Biomédicas, que tem uma tabela comparativa bastante útil. Também recomendo a documentação do pacote rms do R para quem quer implementar esses conceitos em modelos de regressão com variáveis tratadas corretamente como discretas ou contínuas.
Galeria
-

Variaveis Quantitativas Estatística Descritiva[0]. Esse é O Primeiro
