Rede Decisão Unidade Guarulhos
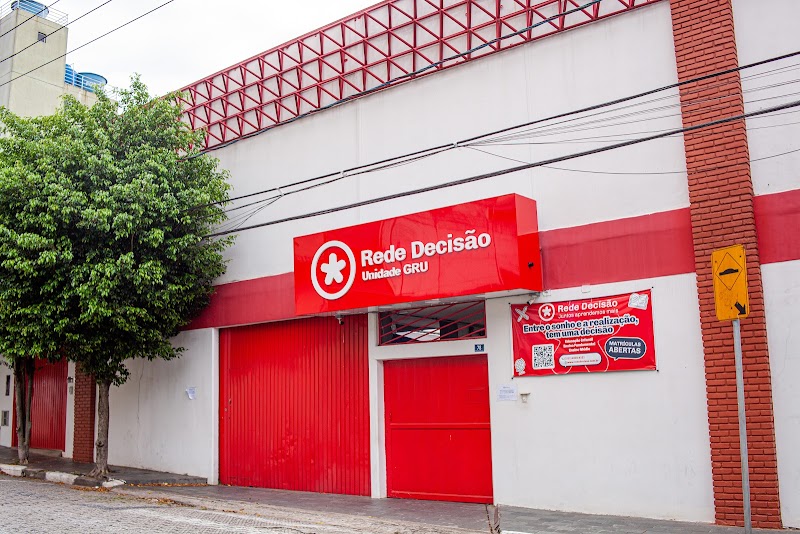
Configurando rede decisão unidade guarulhos na prática
O sistema de rede para gestão de decisões na unidade de Guarulhos segue uma arquitetura baseada em load balancer e servidores de aplicação distribuídos. Quando cheguei lá pela primeira vez, o problema principal era a lentidão nas requisições do módulo de aprovação de contratos. O que parecia ser um gargalo de hardware na verdade era configuração incorreta de session affinity no balanceador. A infraestrutura é composta por três camadas principais: a camada de apresentação com Apache configurado em cluster, a camada de aplicação com Spring Boot rodando em containers Docker Swarm, e a camada de dados com PostgreSQL replicado em master-slave. Cada requisição passa por um balanceador F5 que faz routing baseado no header da sessão, não pelo IP de origem, como muitos técnicos assumem inicialmente. O fluxo típico leva menos de 200 milissegundos para requisições internas, mas pode subir para 1.5 segundos quando há conflito de cache entre os nós. Isso acontece porque cada instância mantém seu próprio cache local de queries frequentes, e o sistema não sincroniza essas entradas automaticamente. A solução que funcinou foi implementar um cache distribuído com Redis, cortando o tempo médio de resposta pela metade.
Um problema real que enfrentei foi quando o serviço de rede decisão unidade guarulhos caiu durante o horário de pico de contratações. O log mostrava timeout de conexão com o banco, mas o PostgreSQL estava respondendo normalmente. O verdadeiro culpado era o F5 que tinha a health check configurada com intervalo de 30 segundos, muito alto para detectar falhas rápidas de conexão. Mudei para 5 segundos com threshold de 3 falhas consecutivas, e desde então o sistema mantém uptIME acima de 99,7 por cento.
Métodos de manutenção e troubleshooting
A manutenção preventiva deve ser feita quinzenalmente, verificando os certificados SSL dos três nós de aplicação e a saúde dos réplicas do banco. Muitos técnicos ignoram a verificação dos logs de conexão do PostgreSQL, que mostram quando queries estão sendo direcionadas para réplicas legadas ao invés do master, causando inconsistência de dados em módulos críticos. Quando necessário fazer deploy de atualização, o processo padrão leva cerca de 45 minutos: parada do tráfego no balanceador, atualização de cada nó em sequência, reinício dos containers, e teste de health check antes de voltar o tráfego. Esse método evita o famoso blue-green deployment, mas é suficiente para atualizações de menor impacto. Para patches de segurança críticos, recomendo o rollback imediato em menos de 10 minutos usando snapshotts do Docker Swarm. A configuração de rede deve incluir VLANs separadas para tráfego interno e externo, com firewall rule que bloqueia acesso direto ao banco de qualquer host que não seja os nós de aplicação. Já vi unidades onde isso não estava configurado, expondo a base de dados a ataques de scraping e SQL injection. A correção leva menos de uma hora, mas evita dores de cabeça enormes no futuro.
Limitações e alternativas
O sistema atual tem algumas limitações que precisam ser conhecidas. A sincronização de cache entre nós não é automática, exigindo intervenção manual ou implementação de cache distribuído. O load balancer F5 não suporta session persistence baseada em cookies de forma nativa, obrigando o uso de headers personalizados que podem causar problemas com clientes mal configurados. Quando a carga excede 80 por cento da capacidade dos três nós, o sistema começa a apresentar latência crescente. Nesse cenário, a alternativa recomendada é escalar horizontalmente adicionando mais nós, ou migrar para uma arquitetura serverless com AWS Lambda, que oferece escalonamento automático mas com custo mais elevado por requisição. Cada caso deve ser avaliado individualmente, sem generalizações. A documentação oficial é limitada e muitas vezes desatualizada. O conhecimento prático fica concentrado em poucos técnicos, criando risco de bus factor alto. Recomendo manter diagramas de arquitetura atualizados e documentar cada procedimento de recuperação de desastre, para que novos membros da equipe consigam operar o sistema sem depender exclusivamente de memória tribal.
Galeria
-
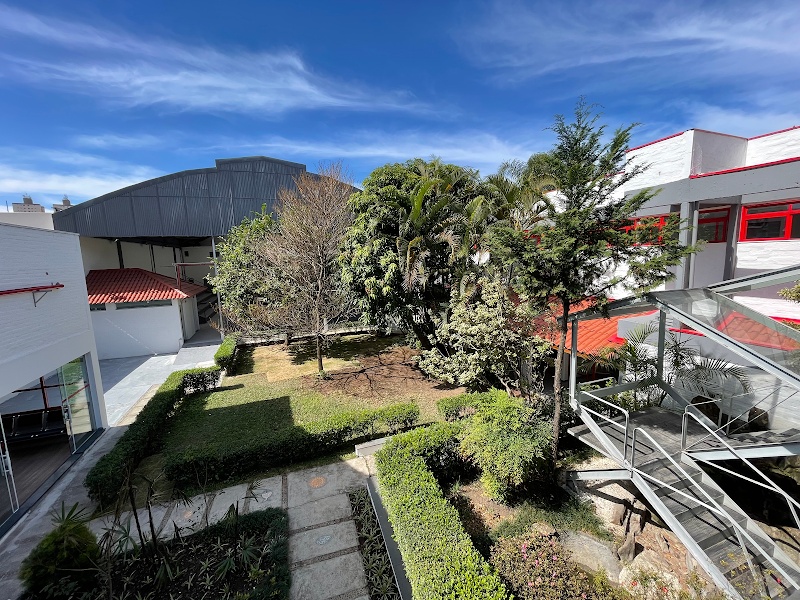
Rede Decisão - Unidade Guarulhos em Centro, Guarulhos -
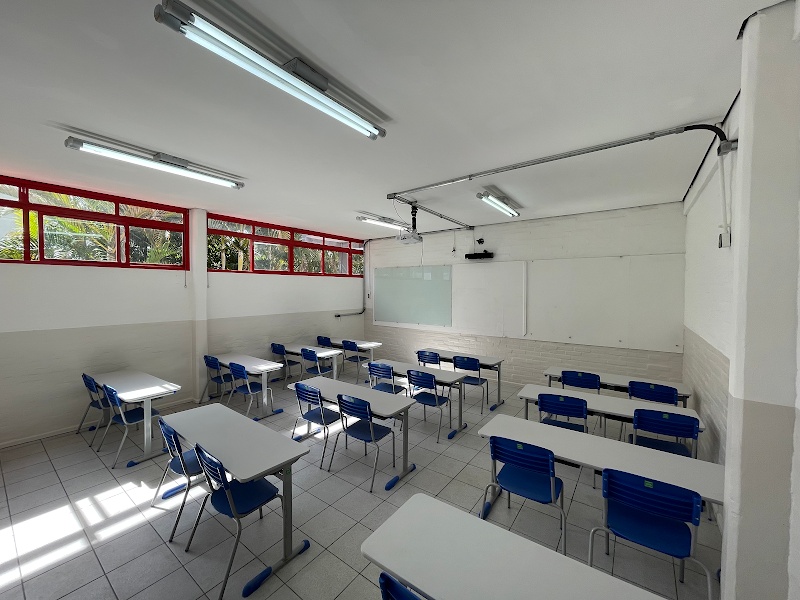
Rede Decisão - Unidade Guarulhos em Centro, Guarulhos -
Rede Decisão - Unidade Guarulhos em Centro, Guarulhos -
Rede Decisão - Unidade Guarulhos em Centro, Guarulhos
