Região E Regionalização

Por que a maioria das regionalizações quebra na prática
Você já tentou agrupar municípios, bairros ou áreas de saúde por critérios objetivos e viu o resultado ficar completamente desconectado da realidade local? Isso é exatamente o problema central da região e regionalização quando sai da teoria dos livros didáticos e vai para a planilha. A questão não é definir o que é uma região — isso todo mundo sabe — mas sim decidir quantas classes usar, qual algoritmo escolher e como justificar os limites para quem vai reclamar que ficou de fora do grupo certo. Em termos práticos, regionalização é o processo de particionar um espaço geográfico em subáreas homogeneizadas segundo algum critério. Pode ser população, renda, cobertura vegetal, infraestrutura hospitalar, tempo de deslocamento. O que todo mundo esquece de mencionar é que o critério define a região, não o contrário. Se você começa com os limites políticos existentes e depois tenta encaixar variáveis neles, está fazendo divisão administrativa, não regionalização. A diferença é importante porque gera resultados completamente distintos. Acho que entendi de verdade quando precisei regionalizar o atendimento odontológico de uma microrregião do interior de São Paulo. Tinha 47 municípios e o objetivo era identificar áreas de vulnerabilidade para alocar equipes móveis. Usei clustering hierárquico com variáveis de densidade demográfica, índice de desenvolvimento e distância até o município sede mais próximo. O resultado natural do algoritmo entregou sete grupos, mas dois deles estavam geograficamente fragmentados — um município isolado no meio do grupo vizinho porque tinha dados socioeconômicos similares, ainda que distasse 80 quilômetros do núcleo. Ajustei adicionando uma restrição de contiguidade no algoritmo e os grupos ficaram territorialmente coerentes. O processo inteiro levou cerca de três horas rodando no R, considerando a validação cruzada.
Métodos que funcionam e os que só geram trabalho extra
Existem basicamente três abordagens que valem o esforço. A primeira é a classificação por similaridade, onde você agrupa unidades que se parecem nas variáveis de interesse. Funciona bem quando os dados são consistentes e as escalas estão normalizadas. A segunda é a regionalização por restrição de contiguidade, que impõe que os grupos formem áreas geograficamente conectadas. A terceira é a combinação das duas, usando similaridade como base e contiguidade como correção pós-processamento. Esta última costuma ser a que produz os resultados mais úteis para tomada de decisão. O erro mais comum é confiar cegamente no número de clusters sugerido por métricas automáticas como o índice de Davies-Bouldin ou a silhueta. Essas métricas indicam um valor ótimo matematico, mas raramente corresponde a algo que faz sentido geograficamente ou administrativamente. No caso que citei acima, a silhueta máxima estava em cinco grupos, mas o mapa resultante tinha aglomerações sem lógica territorial. Ajustei manualmente para sete e a validade de face melhorou significativamente.
Região e regionalização: ferramentas acessíveis
Para quem precisa fazer isso sem montar um servidor GIS completo, o pacote R `Rook` combinado com `sf` resolve boa parte do trabalho. Há também a opção de usar o GeoDa para regionalização com restrição de contiguidade via algoritmo de DCP (Dynamic Clustering Procedure). Se preferir uma interface mais visual sem programação, o QuantumGIS com o plugin LISA Map Cluster permite experimentação rápida, embora a flexibilidade seja menor. O link direto para o pacote Risk é https://cran.r-project.org/package=Rook, e o GeoDa pode ser baixado em https://geoda.center. Ambos são gratuitos e funcionam em Linux, Windows e macOS.
Limitações que ninguém gosta de ouvir
Regionalização tem um problema estrutural que poucos admitem em publicações acadêmicas: ela é intrinsicamente arbitraria. Não importa quantos testes estatísticos você faça, sempre haverá fronteiras artificiais dividindo áreas que na prática funcionam como um continuum. Uma cidade no limite entre dois grupos nunca foi realmente diferente da cidade ao lado, apenas o algoritmo decidiu que sim. Aceitar isso é o que separa quem produz regionalizações úteis de quem as usa como se fossem verdades absolutas. Outra limitação séria é a dependência da escala. Mudar a unidade básica de análise — de município para bairro, por exemplo — pode produzir regionalizações completamente diferentes para o mesmo fenômeno. Isso se chama problema da unidade módulo ou MAUP, e existem duas variações: a de definição de fronteira e a de agregação. Ignorar o MAUP é provavelmente o erro mais frequente em estudos regionais aplicados. Quando os dados têm muitas variáveis correlacionadas, o clustering tende a dar peso excessivo a dimensões redundantes. Antes de rodar qualquer algoritmo, faça uma análise de componentes principais e use apenas os fatores com autovalor maior que um ou retenha aqueles que explicam pelo menos dez por cento da variância acumulada. Isso reduz ruído e estabiliza os grupos. Em média, essa etapa corta o tempo de convergência do algoritmo pela metade em datasets com mais de quinze variáveis.
Se o seu objetivo é pureza estatística e não usabilidade prática, considere abandonA a regionalização tradicional e parta para uma abordagem de zoneamento fuzzy, onde cada unidade pertence a múltiplos grupos com graus de pertinência diferentes. Não é tão para apresentações, mas reflete melhor a realidade e evita a falsidade de fronteiras nítidas em fenômenos contínuos.
Galeria
-

Mapa Mental Regionalização Do Brasil - NAZAEDU -

CONTEÚDOS PARA ESTUDO: Regionalização - O que é, conceito e classificação -
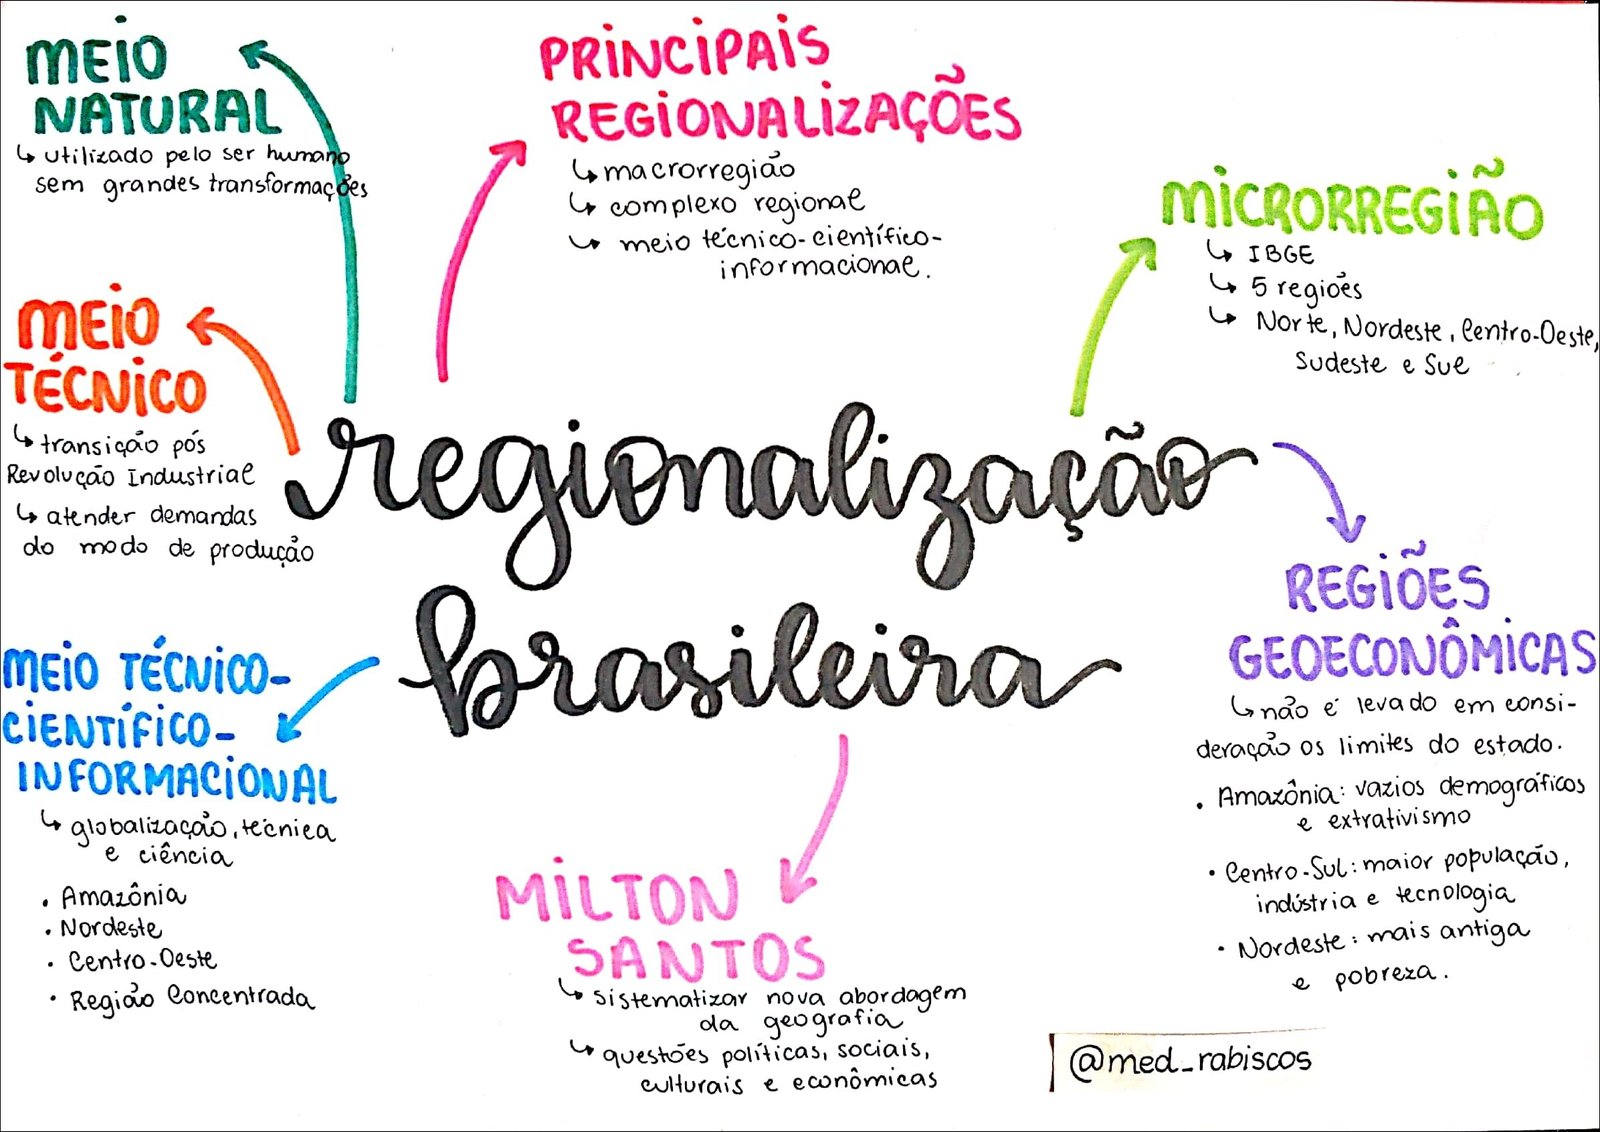
Mapas Mentais sobre REGIONALIZAÇÃO - Study Maps -
7º ano - Brasil - Regionalização | PDF | Brasil

