Seleção Natural Darwiniana

Como implementar seleção natural em simulações computacionais
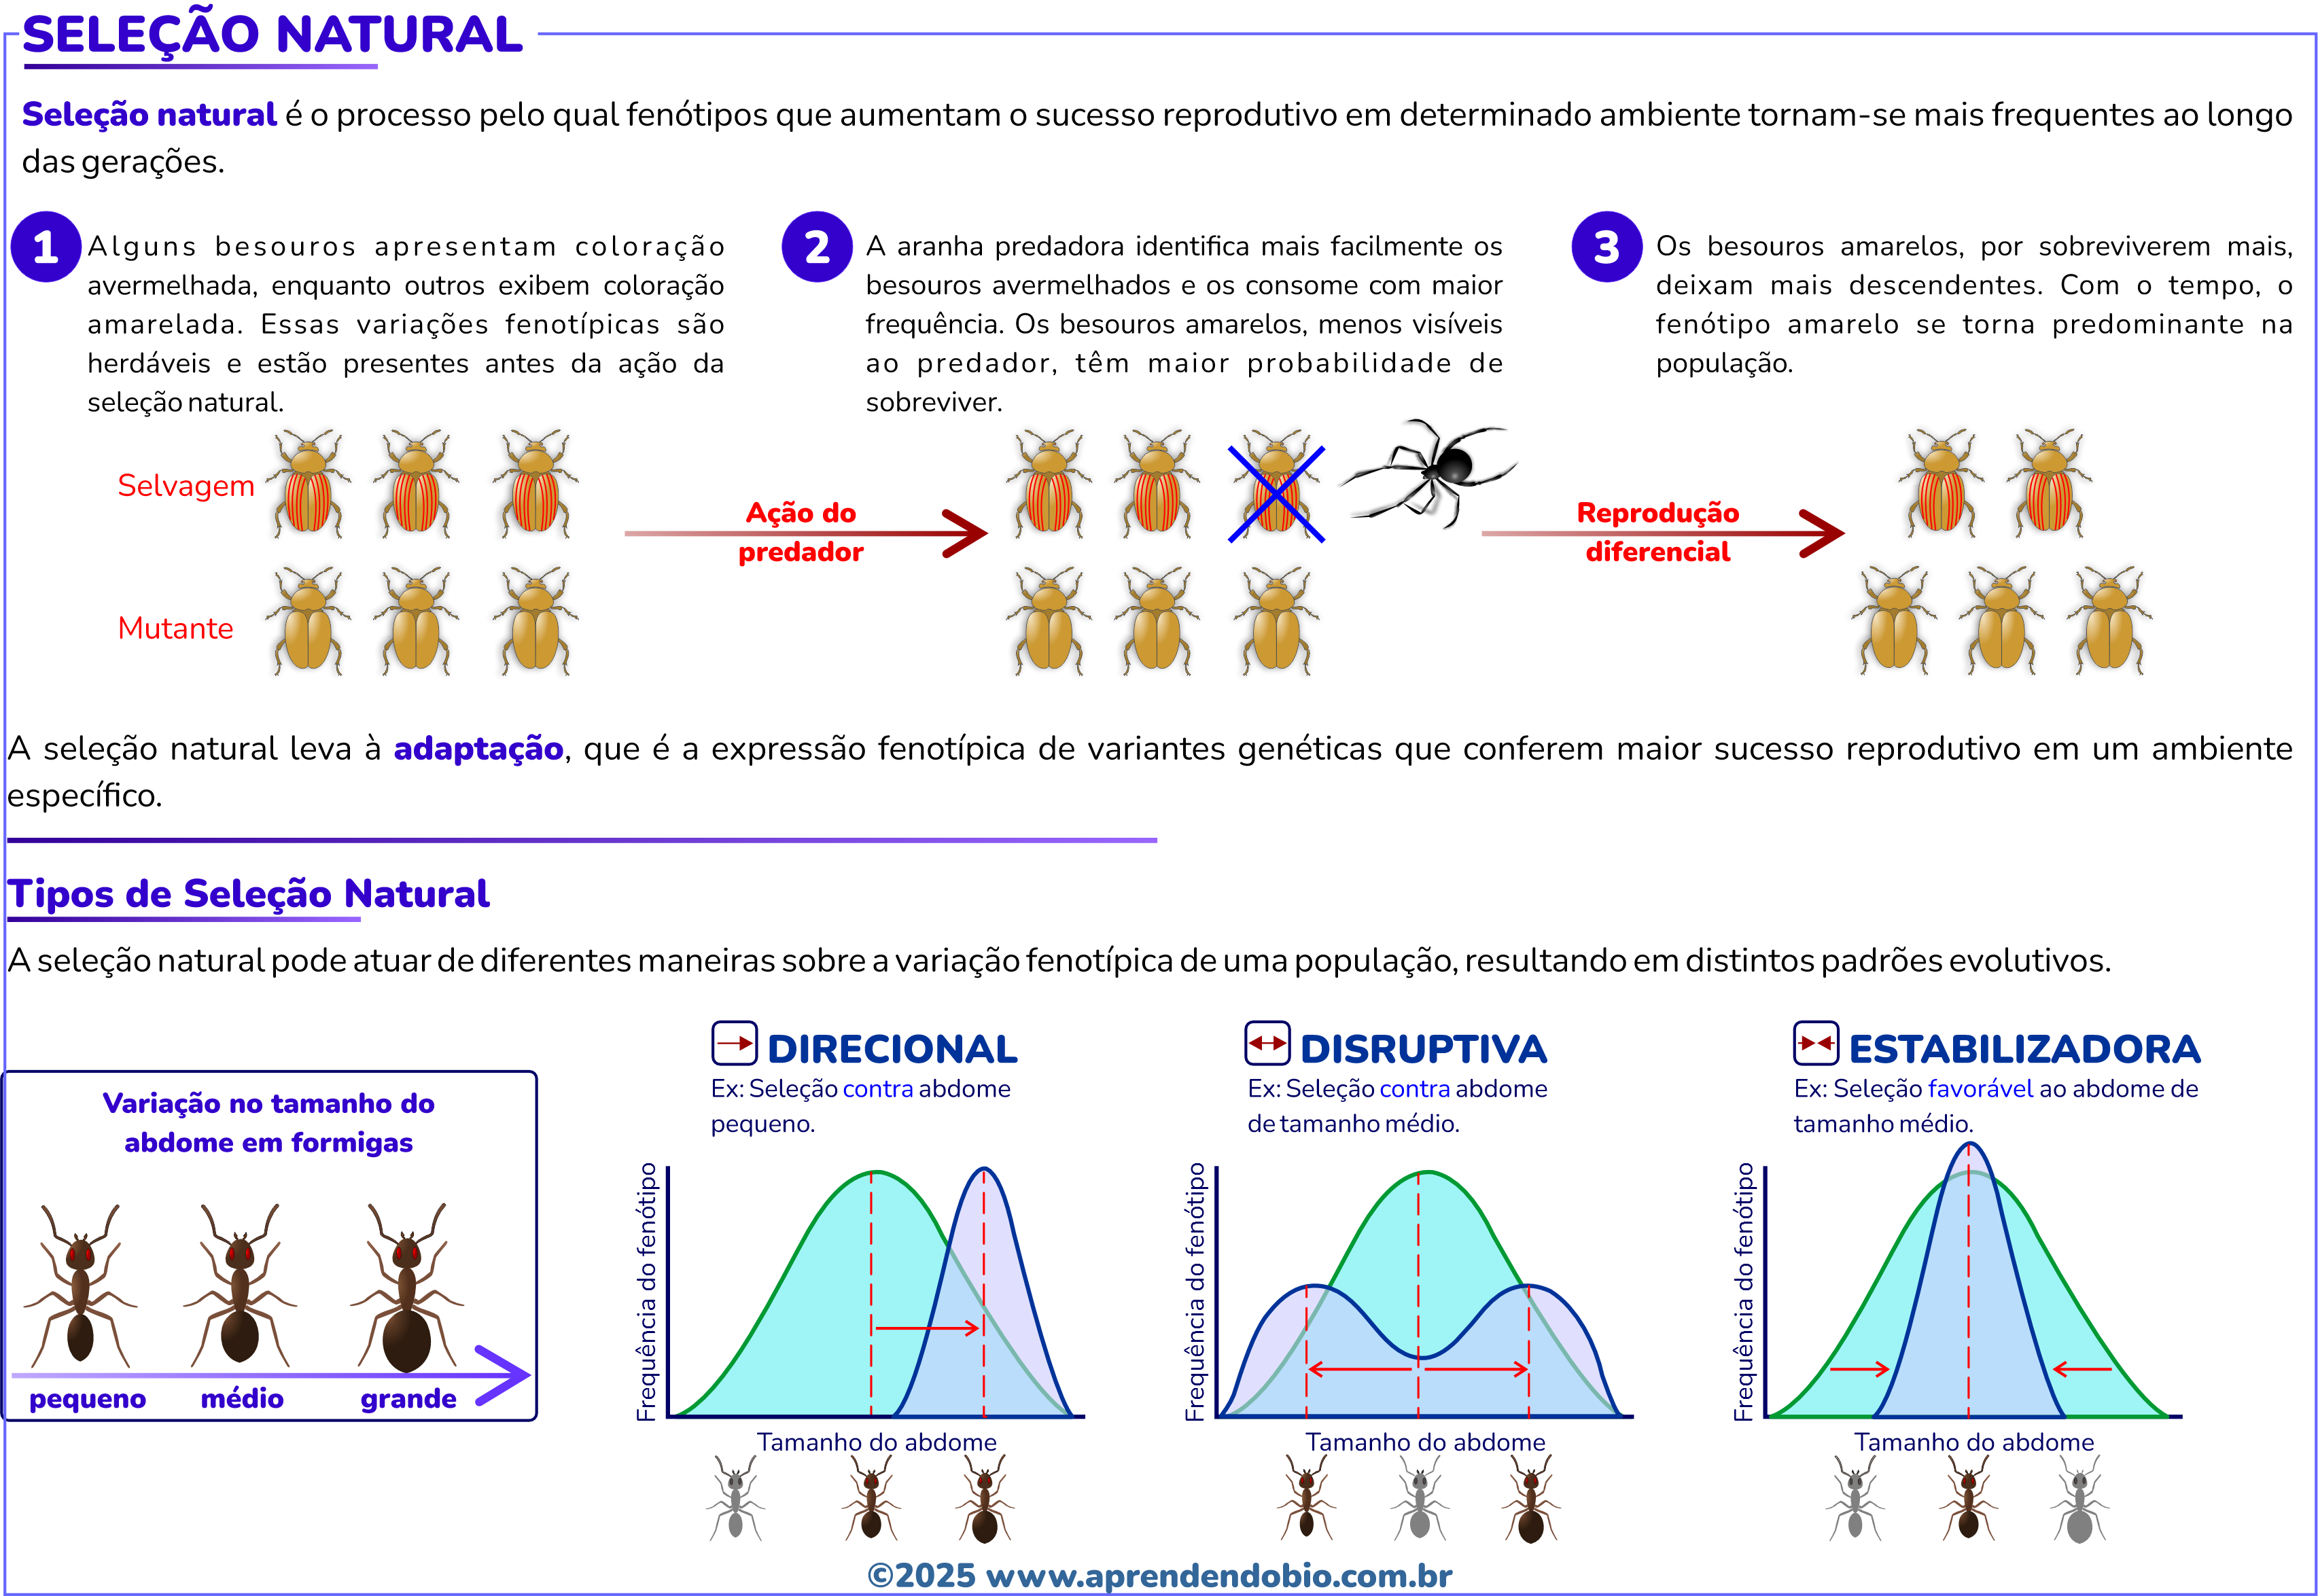
A maioria dos tutoriais na internet explica a teoria e já Para. A prática é bem diferente. Vou explicar como isso funciona do lado de cá, depois de ter quebrado uns quantos códigos tentando fazer algoritmos genéticos simples responderem como o esperado. O conceito de seleção natural darwiniana aplicado a computação se resume a três operações básicas: população, avaliação de fitness e reprodução seletiva. O problema é que as pessoas subestimam o que acontece entre esses três passos. É aí que o bicho pega.
Configurando a população inicial
Você começa gerando um conjunto de soluções candidatas aleatórias. Cada solução é um cromossomo, que nada mais é do que um vetor de números. Pode ser binário, pode ser real, depende do seu problema. Para problemas de otimização contínua, vetores de ponto flutuante são mais fáceis de trabalhar. O tamanho da população importa mais do que quem escreve os tutoriais admite. Populações muito pequenas — menos de 50 indivíduos — tendem a convergir prematuramente para soluções subótimas. Populações maiores demandam mais avaliações de fitness por geração, o que em problemas caros computacionalmente vira um pesadelo. Um tamanho entre 100 e 200 é um ponto razoável de partida para a maioria dos problemas.
A função de fitness é tudo
Aqui está o primeiro insight que poucos mencionam: a função de fitness dita mais do que o algoritmo em si. Se você formular mal a função, o algoritmo vai otimizar a coisa errada com eficiência impressionante. Já vi gente reclamar que o algoritmo genético "não funciona" quando na verdade a função objetivo estava scaling mal ou tendo pontos de inflexão que enganavam o operador de seleção. Um detalhe prático que todo mundo esquece: normalizar os valores de fitness entre gerações ajuda muito. Sem normalização, se a escala do fitness mudar drasticamente — o que é comum quando a população começa a convergir — os operadores de seleção perdem eficácia. A diferença entre o melhor e o pior indivíduo fica tão pequena que a pressão seletiva essentially some.

Operadores genéticos e os problemas reais
Crossover e mutação são os operadores padrão. Crossover recombina partes de dois pais para gerar filhos. Mutações introduzem variação aleatória. A taxa de crossover típica fica entre 0,7 e 0,9. A taxa de mutação, entre 0,01 e 0,1 por gene. Esses números não são sagrados, são pontos de partida. O problema que eu enfrentei na prática — e que raramente aparece nos tutoriais — é o cenário de múltiplos picos de fitness. Eu estava otimizando uma função com cinco picos globais locais, e o algoritmo simplesmente escolhia um pico qualquer e ficava orbitando ele para sempre. A população perdia diversidade genética rapidamente porque os melhores indivíduos daquele pico local dominavam a reprodução. O algoritmo nunca explorava outras regiões do espaço de busca. A solução que funcionou foi introduzir crowding: em vez de substituir os pais diretamente pelos filhos, cada filho compete para replacing o indivíduo mais geneticamente similar da população. Isso preserva nichos. Outra opção que usei foi fitness sharing, que reduz o fitness percebido de indivíduos muito similares entre si. Combinei as duas técnicas e o algoritmo passou a explorar múltiplas regiões simultaneamente.
Seleção: escolhas que fazem diferença
Torneio é o método mais popular e funciona bem na maioria dos casos. Você pega k indivíduos aleatórios e seleciona o melhor. K=2 é agressivo o suficiente sem ser destrutivo. Rotação é mais suave mas pode ser lenta demais em espaços complexos. Elitismo — preservar os melhores indivíduos da geração anterior — é quase obrigatório. Sem elitismo, você pode perder a melhor solução encontrada em uma geração devido à stochasticidade dos operadores. Uma armadilha comum: usar seleção por ranking em vez de seleção por escala linear quando a população ainda está muito diversificada no início da execução. Ranking pune os indivíduos muito bons de forma desproporcional, o que pode retardar a convergência inicial sem ganho real em qualidade final.
Quando o algoritmo falha
Algoritmos baseados em seleção natural darwiniana não são solução para tudo. Problemas com espaço de busca discreto e extremamente vasto, como certos problemas de scheduling com milhares de variáveis inteiras, podem exigir gerações demais para encontrar algo razoável. Nesses casos, combinar com busca local — o que chamamos de algoritmo memético — costuma ser a saída. Você aplica o algoritmo genérico para explorar o espaço e uma busca local greedy para refinamento em regiões promissoras. Outro limitação séria: se a avaliação de fitness for computacionalmente cara, mesmo uma população de 100 indivíduos avaliada por 1000 gerações já são 100 mil avaliações. Isso pode levar horas ou dias dependendo do problema. Paralelização ajuda, mas nem sempre é trivial de implementar dependendo da sua stack.

Código básico de referência
Aqui está a estrutura que eu uso como base. Não é elegante, mas funciona: População = inicializa aleatoriamente(tamanho, dimensão) Para cada geração:
Avalia fitness de cada indivíduo Aplica elitismo — preserva os N melhores Nova_população = []
Enquanto Nova_população menor que tamanho: pai1 = seleciona_torneio(população) pai2 = seleciona_torneio(população)
filho = crossover(pai1, pai2) muta(filho) adiciona filho a Nova_população
População = Nova_população Os hiperparâmetros que você vai precisar ajustar são: tamanho da população, taxa de crossover, taxa de mutação, tamanho do torneio e número de elitistas. Comece com os valores padrão, rode por pelo menos 500 gerações e observe a curva de convergência. Se estabilizar cedo demais, aumente a taxa de mutação. Se não convergir em 1000 gerações, seu espaço de busca provavelmente precisa de uma reformulação ou de operadores específicos para o domínio.
Recursos para aprofundar
O livro Genetic Algorithms in Search, Optimization and Machine Learning do David Goldberg é a referência clássica. Para implementação prática com código, a biblioteca DEAP para Python cobre a maioria dos casos. Se o seu problema tem restrições, vale a pena estudar técnicas de punição ou codificação específica paraViolações de restrição.
Galeria
-
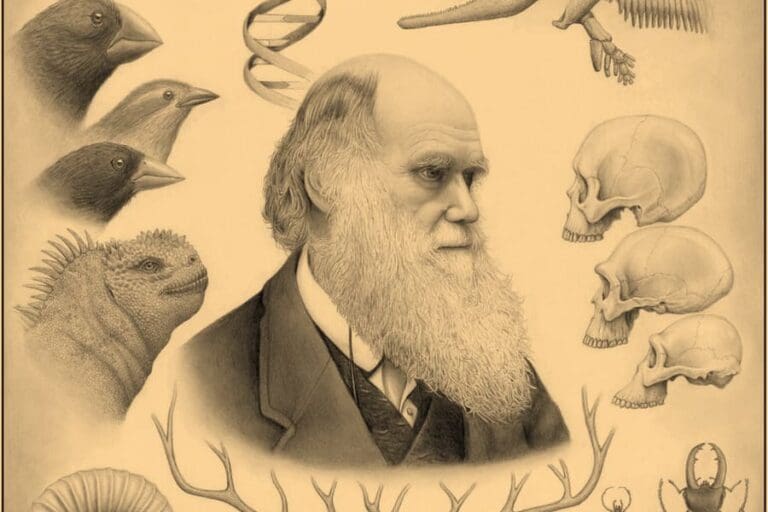
Charles Darwin: o criador da teoria da evolução e seleção natural
