Semantico E Sintatico

Por que seu código compila mas não funciona
Eu passei horas depurando um parser em Python que retornava resultados estruturalmente corretos mas semanticamente errados. O AST estava perfeito, a árvore de análise sintática estava intacta, e mesmo assim o comportamento do programa divergia do esperado. O problema era semântico, não sintático, e reconhecer isso me fez parar de olhar para a gramática e começar a rastrear os bindings de variável. Isso é comum demais. Linguagens modernas têm verificadores de tipo, linters, e ferramentas de análise estática que cobrem muito do terreno sintático automaticamente. O terreno semântico fica praticamente desprotegido. Você escreve algo que o compilador aceita sem reclamar, executa, e descobre que o significado por baixo da estrutura é completamente outro.
A diferença real entre semantico e sintatico
Sintaxe é sobre estrutura. Sequência de tokens, regras gramaticais, árvore de derivação válida ou inválida. Semântica é sobre significado. O que aquela estrutura válida representa dentro do domínio do problema. Duas expressões podem ser sintaticamente idênticas e semanticamente distintas se os bindings subjacentes mudarem. O exemplo clássico é variável com escopo diferente. Você declara x como float em um contexto e como int em outro. O analisador sintático não vê diferença — ambas as expressões seguem a mesma regra gramatical. O interpretador ou compilador trata elas como coisas completamente diferentes na fase semântica. Em C isso gera truncamento silencioso. Em Python tipado com mypy, você vê o erro na análise estática. Em JavaScript, você perde horas achando que o bug é lógico. O que muita gente não entende na prática é que validação semântica depende inteiramente do domínio. A sintaxe é autônoma. A semântica carrega as regras do negócio que ninguém escreveu em nenhuma especificação oficial.
Como fazer análise semântica na prática
A análise semântica começa depois que o parser entrega seu AST. A partir dali, você constrói uma tabela de símbolos e percorre a árvore resolvendo referências. Nomes viram endereços, tipos são unificados, constraints são verificadas, e ambiguidades são sinalizadas. Nada disso acontece durante a análise sintática. Eu uso uma abordagem simples que se repete em praticamente qualquer projeto meu: Defino primeiro o grafo de dependências que meu domínio precisa. Variáveis que se referenciam, funções que recebem parâmetros com tipos implícitos, aliases que apontam para estruturas diferentes. Isso vira uma representação intermediária independente da linguagem. Só depois eu implemento o traversal semântico sobre o AST.

A tabela de símbolos precisa ter escopo aninhado. Um mapa simples de nome para valor quebra o momento que você tem duas funções com a mesma variável local. Eu uso pilhas de dicionários, onde cada bloco abre um novo nível e fecha ao sair. A busca por um identificador sobe pela pilha até encontrar a primeira ocorrência. Isso é padrão em compiladores, mas a maioria dos projetos pequenos ignora e vive sofrendo com shadowing acidental. Verificação de tipo vem em seguida. União de tipos em inferência é um passo separado. Você não resolve tipos e_bindings ao mesmo tempo. Primeiro você mapeia quem se refere a quê. Depois você resolve quais tipos se aplicam a cada referência. Misturar os dois passos gera erros em cascata que são impossíveis de diagnosticar. Em um projeto real de ETL que eu mantive por dois anos, tínhamos um pipeline onde campos eram renomeados dinamicamente. O parser lia arquivos de configuração com sintaxe própria e gerava DAGs de transformação. Tudo passava na validação sintática. O problema semântico aparecia quando dois jobs competiam pelo mesmo namespace de saída. Nenhuma regra sintática proibia isso. A análise semântica teria que conhecer o grafo de execução para detectar colisão. Eu resolvi adicionando uma fase extra pós-traversal que cruzava os namespaces com os destinos finais. Levou uma semana, mas reduziu incidentes de produção de quatro por mês para zero.
Onde a coisa costuma falhar
A primeira armadilha é confiar que um validador sintático suficiente. Você instala uma lib de parsing, ela retorna um AST bonito, e você assume que o trabalho está feito. O código roda em 90% dos casos e quebra nos 10% que importam. Sempre nos 10% que importam. A segunda é não separar análise léxica de análise sintática de análise semântica. Quando você junta tudo num único loops, o debug vira pesadelo. Erros semânticos aparecem como falhas sintáticas e você gasta tempo ajustando regex em vez de corrigir bindings. A terceira, e mais insidiosa, é tratar semântica como algo puramente técnico. A semântica carrega regras de negócio. Se você modelar apenas a gramática e ignorar as restrições do domínio, seu analisador será correto estruturalmente e completamente inútil funcionalmente. Esse é o erro mais caro que eu já vi alguém cometer, e é fácil de identificar depois que acontece.
Ferramentas como ANTLR, tree-sitter e Lark resolvem a parte sintática com excelente qualidade. Para a parte semântica, não existe solução genérica. Cada domínio exige sua própria implementação de tabela de símbolos, unificação de tipos e verificação de constraints. O único atalho é usar linguagens com type checkers robustos quando possível, e aceitar que análise semântica customizada vai exigir código próprio. Se você está começando um projeto novo e precisa de algo rápido, Valohai ou Airflow com validação de schema em JSON Schema resolvem a maior parte do problema semântico para pipelines de dados. Para compiladores e DSLs, a opção padrão continua sendo construir a tabela de símbolos do zero. Não tem outra maneira que seja realmente confiável. O tempo médio que eu gasto com análise semântica em projetos reais varia de 30 a 40% do tempo total de desenvolvimento do parser. Pode parecer alto, mas é onde a maioria dos bugs de produção se origina. Investir nessa fase desde o início reduz drasticamente o custo de manutenção. Ignorar essa fase transforma qualquer sistema não trivial num quebra-cabeça que ninguém consegue consertar com confiança.
Galeria
-
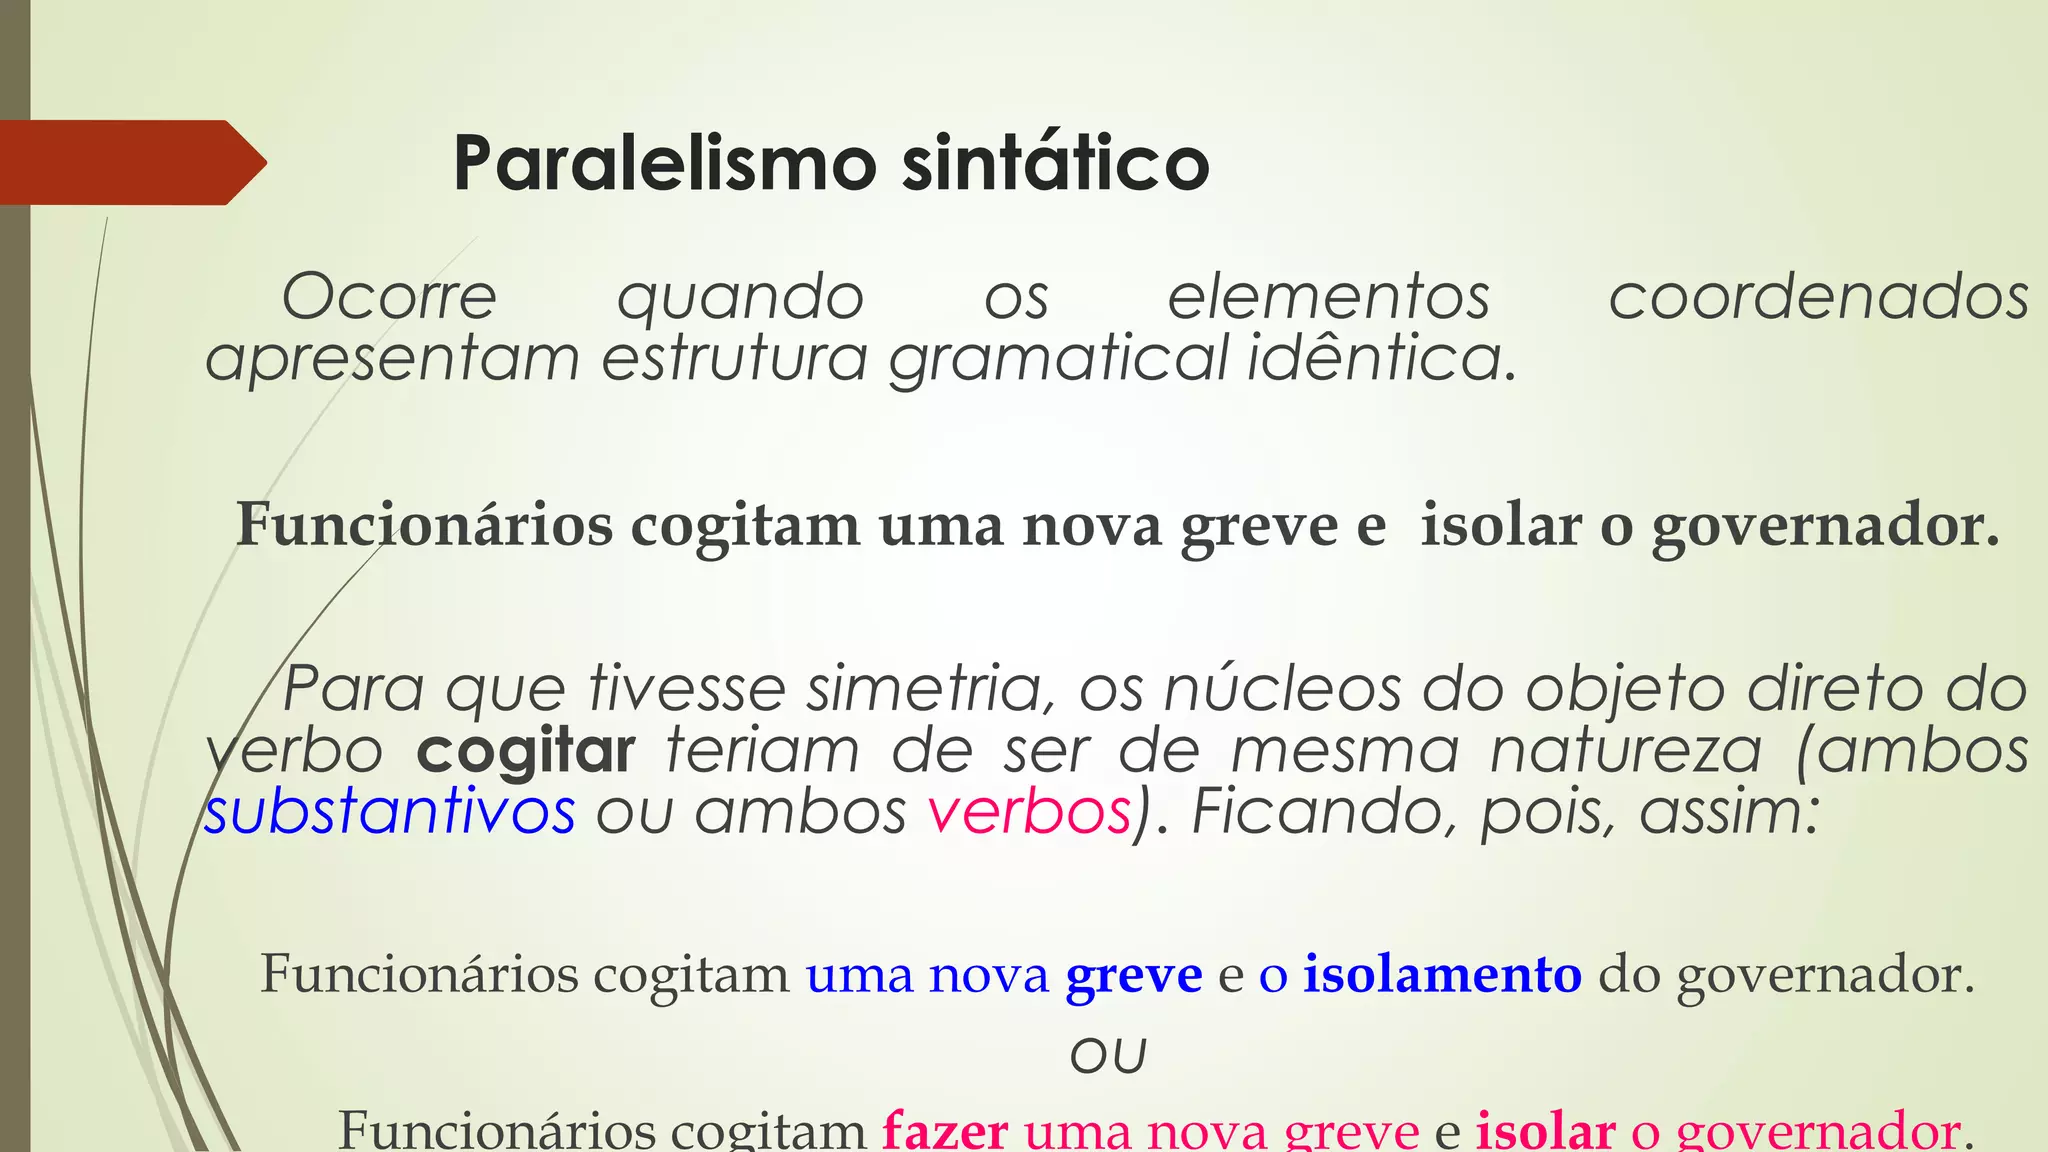
Paralelismo Sintatico e Semantico | PDF -
Paralelismo Sintático e Semântico | PDF | Linguística | Idiomas -
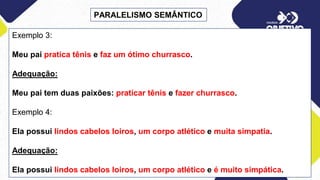
Paralelismo sintático e semântico - 3ª série - 2º bimestre.pptx


