Sensoriamento Remoto E Geoprocessamento
O que na prática é sensoriamento remoto e geoprocessamento
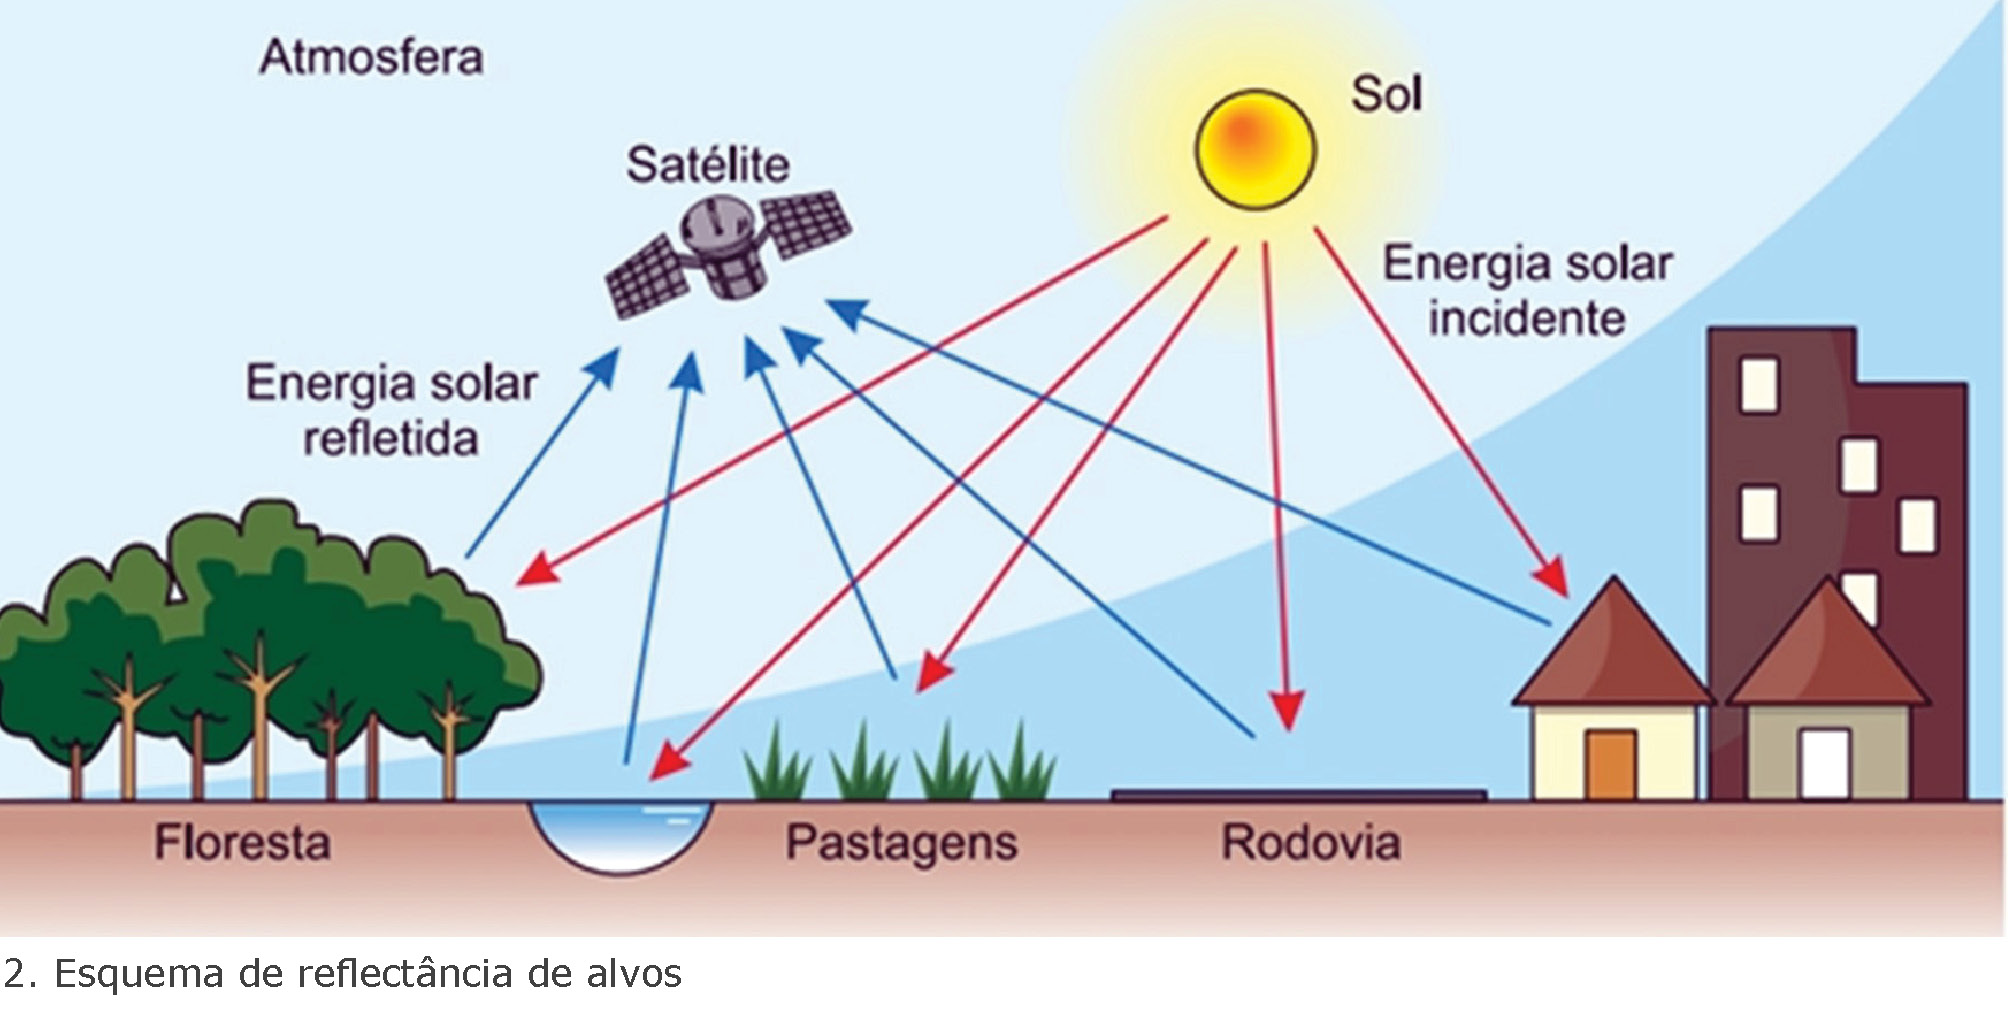
A primeira coisa que as pessoas confundem é achar que são a mesma coisa. Sensoriamento remoto é a captação de dados à distância, geralmente por satélites ou aeronaves. Geoprocessamento é o conjunto de técnicas que transforma esses dados em informação espacial útil. Um não funciona bem sem o outro, mas cada um tem seu próprio pesadelo. Se você já tentou processar uma imagem de satélite e terminar com algo que não tem a mínima cara do terreno, sabe do que estou falando. O problema quase nunca é o sensor. É o passo entre o arquivo bruto e o produto final.
Fluxo real de sensoriamento remoto e geoprocessamento
Eu trabalho com isso há bastante tempo e o fluxo que realmente uso no dia a dia é diferente do que aparece em livro didático. O método começa antes mesmo de abrir qualquer software. A primeira decisão é o que você quer fazer com a imagem. Isso define desde o sensor que você vai buscar até o método de correção que vai aplicar. Veja um fluxo prático que eu repito quando preciso entregar algo com qualidade: Passo 1 — Definir o objeto de estudo e a resolução necessária. Isso é mais importante do que a maioria das pessoas admite. Se você quer mapear cobertura urbana, uma imagem de 30 metros como o Landsat já resolve. Se o objetivo é identificar telhados ou faixas de cultivo estreitas, vai precisar de dados como os do Sentinel-2 (10 metros) ou de imagens comerciais como Planet e RapidEye. A escolha errada aqui destrói o resto do processo.
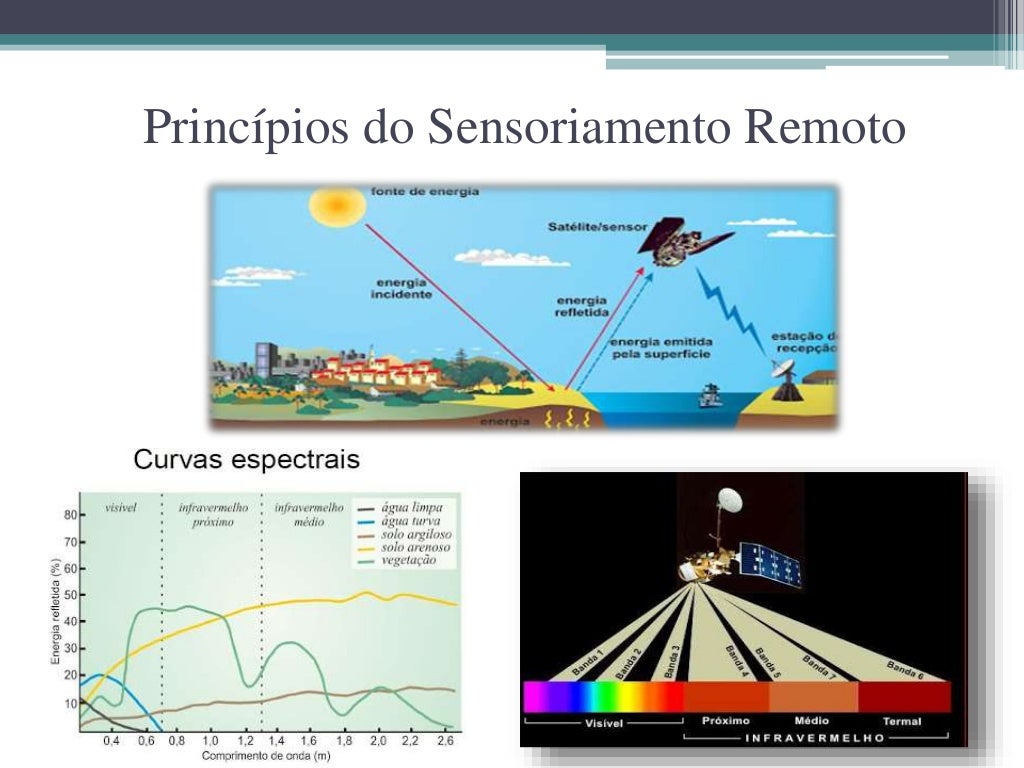
Passo 2 — Buscar e baixar os dados. Os dois principais portfólios gratuitos hoje são o Landsat, gerenciado pelo USGS, e o Sentinel, do programa Copernicus da União Europeia. O Landsat tem séries temporais a partir de 1984, o que é essencial para análise de mudança. O Sentinel-2 oferece revisitância de 5 dias na linha do equador e resolução espectral mais detalhada na faixa do visível. Para acesso direto, use o site Earth Explorer do USGS para Landsat e o Copernicus Browser ou o Terra View da INPE para Sentinel. Passo 3 — Correção atmosférica e geométrica. Aqui é onde o trabalho real começa. Imagens de satélite vêm com distorções atmosféricas que alteram os valores de reflectância. O método mais comum para dados ópticos é o DOS1 ou o modelo empírico de lineação, mas o mais robusto hoje em dia é usar o software ACOLITE ou o LaSRC, que está disponível direto no Google Earth Engine. A correção geométrica é automática na maioria dos produtos Sentinel, mas imagens Landsat históricas podem exigir ortorretificação com modelo digital de elevação, preferencialmente o SRTM ou o Copernicus DEM. Passo 4 — Classificação ou extração de informação. Se o objetivo é classificar uso e cobertura do solo, os métodos supervisionados com máxima verossimilhança ainda funcionam, mas o desempenho melhora muito se você usar Random Forest ou XGBoost. Eu costumo rodar classificação com Random Forest em plataformas como Google Earth Engine ou Manifold GIS porque o custo computacional fica mais previsível. Para extração de limites, como linhas de costa ou estradas, a segmentação multirresolução do eCognition ou o SNIC do R com sf e terra packages entrega resultados melhores do que simples.
Passo 5 — Validação. Isso é o que mais separa o amador do profissional. Acredite ou não, a maioria dos mapas que circulam na internet não passa de uma representação bonita sem acurácia mensurada. O padrão do setor é usar matriz de confusão com acurácia global e Kappa de Cohen. O valor mínimo que eu considero aceitável para um mapa de uso do solo é acurácia acima de 80% e Kappa acima de 0,75. Qualquer coisa abaixo disso você não deveria chamar de mapa, deveria chamar de rascunho. Aqui vai um problema específico que eu enfrentei e que demonstra como a teoria não segura a realidade. Eu estava processando imagens Sentinel-2 para mapear área alagada em uma região de cerrado no Mato Grosso do Sul. O índice NDWI funcionava perfeitamente nas áreas abertas, mas em trechos com vegetação ripária densa, a assinatura espectral da água subvetorial produzia valores semelhantes aos de solo úmido. O resultado era uma classe "água" inflada que ia muito além da manchas reais de alagamento. A solução foi combinar NDWI com o índice NDBI para remover falsos positivos de superfície construída e, principalmente, aplicar um filtro de textura baseado na matriz de co-ocorrência. Em vez de confiar apenas no espectro, usei a entropia da textura como variável adicional no classificador Random Forest. O ganho foi de 12 pontos percentuais na acurácia da classe água, saindo de 68% para 80%. Foi trabalho de uma tarde que resolveu um problema que persistia há semanas. Outra coisa que os manuais não destacam com a devida força: a diferença entre reflectância no topo da atmosfera e reflectância na superfície é enorme e muda completamente a interpretação. Dados como os do Sentinel-2 são frequentemente distribuídos já em nível 2A com correção atmosférica, mas muitos usuários continuam trabalhando com dados de nível 1C sem saber que estão interpretando ruído atmosférico como variação de superfície. Se você está usando dados Landsat, a menos que baixe especificamente o produto Collection 2 Level-2, estará lidando com TOA reflectance e precisará aplicar correção por conta própria.
Existe também um viés comum sobre resolução espacial que precisa ser desmontado. Resolução mais alta não significa resultado melhor automaticamente. Um estudo publicado em 2023 no journal Remote Sensing of Environment mostrou que para mapeamento de desmatamento em biomas abertos, a resolução de 10 metros do Sentinel-2 pode exceder em desempenho a resolução de 3 metros do WorldView, porque a maior resolução espectral do Sentinel permite discriminar espécies vegetais que o WorldView não captura. O ponto é que o sensor ideal depende da pergunta, não do tamanho do pixel. Quanto às ferramentas, o mercado se divide basicamente em três categorias. A primeira é o lado gratuito e de código aberto: QGIS com os plugins SAGA e GRASS, o pacote R com terra e stars, e o Google Earth Engine para processamento na nuvem. A segunda é o software comercial como ArcGIS Pro, ENVI e eCognition. A terceira é o ambiente de nuvem propiamente dito, como o Google Earth Engine, o AWS Earth onelake e o Microsoft Planetary Computer. Eu utilizo essencialmente QGIS para produção final e o Google Earth Engine para análise temporal e processamento de grandes volumes, e o R para tratamento estatístico dos resultados. Um gargalo que poucas pessoas mencionam é a gestão de dados intermediários. Processar imagens de sensoriamento remoto gera arquivos enormes com facilidade. Um único tile do Sentinel-2 em nível 2A ocupa cerca de 700 MB. Se você está processando uma série temporal de 5 anos com 24 imagens por ano para uma área grande, estão falando de mais de 100 GB só de dados brutos, sem contar os produtos derivados. Eu recomendo fortemente adotar um sistema de nomenclatura padronizado desde o início e usar formatos como COG (Cloud Optimized GeoTIFF) que permitem leitura eficiente sem precisar baixar o arquivo completo. Ferramentas como GDAL convertem arquivos com um comando simples de duas linhas.
Agora, um ponto onde essa área realmente falha e que precisa ser dito claramente: sensoriamento remoto óptico não vê através de nuvens. A Bolha das Nuvens no Brasil é um problema real que invalida boa parte dos ciclos de aquisição de dados. Durante a estação chuvosa, imagens livres de nuvens de áreas como a Amazônia podem levar semanas ou meses para ficar disponíveis. A solução prática é usar o Sentinel-1, que é radar de abertura sintética e opera independentemente das condições climáticas, ou trabalhar com composite de média temporal que aproxima a assinatura da superfície a partir de múltiplas aquisições. O trade-off é perda de resolução temporal, mas a alternativa é simplesmente não ter dado. Outra limitação séria diz respeito à disponibilidade de ground truth. Sem pontos de controle no terreno, toda classificação é um exercício de fé controlada. Eu já vi projetos inteiros serem descartados porque o mapeamento de campo revelou que a classe "floresta primária" do classificador incluía plantios de eucalipto com mais de 15 anos, que espectralmente se assemelham muito à floresta nativa em sensores ópticos de média resolução. A correção só foi possível com levantamentos de campo dirigidos e com o uso de dados LiDAR para capturar a estrutura vertical da vegetação. Se você está começando agora, o caminho mais direto é o seguinte. Baixe o QGIS. Instale o plugin Orfeo Toolbox e o SAGA GIS. Comece com um produto Sentinel-2 L2A na sua área de estudo. Aplique correção geométrica se necessário, calcule índices espectrais como NDVI e NDWI, e rode uma classificação por Random Forest com amostras de treinamento coletadas diretamente no mapa. Valide com matriz de confusão. Esse pipeline leva entre 3 e 5 horas na primeira vez, dependendo do tamanho da área, e depois que você domina os passos, o tempo cai para cerca de 45 minutos em processos posteriores.

O Google Earth Engine oferece um caminho alternativo mais escalável. A API do Python ou a interface de JavaScript permitem processar milhões de imagens sem precisar baixar nada. O custo é a dependência de conexão estável e a limitação de que você não consegue executar comandos personalizados fora das bibliotecas que a plataforma oferece. Para a maioria das análises regionais e nacionais, however, o GEE é suficiente e muito mais rápido do que qualquer configuração local. Há também uma questão ética que precisa ser considerada. Mapas gerados por sensoriamento remoto são frequentemente usados em políticas públicas, licenciamento ambiental e decisões judiciais. Um erro de classificação pode significar a demarcação incorreta de uma área protegida ou a negação indevida de um crédito rural. Por isso, a transparência metodológica não é opcional. Sempre registre os parâmetros de classificação, o número e a distribuição das amostras de validação e o período de aquisição das imagens. Isso é o que diferencia um produto confiável de uma ilustração agradável. O campo avança rápido. Modelos de deep learning como os U-Net adaptados para dados multiespectrais já produzem resultados que superam classifiers tradicionais em tarefas específicas, mas exigem centenas de amostras rotuladas e poder computacional que nem todos têm acesso. Enquanto isso, métodos clássicos de classificação com validação rigorosa continuam sendo o padrão ouro para a maioria das aplicações práticas. Não tente inovar na metodologia se a inovação não vai mudar o resultado final. Às vezes o trabalho bem feito com o que já existe vale mais do que o trabalho mal feito com o que é novo.
Para quem quer aprofundar, os recursos mais confiáveis são os manuais técnicos do USGS sobre Landsat, a documentação do programa Copernicus para Sentinel, e os artigos de revisão publicados nos journals Remote Sensing of Environment e ISPRS Journal of Photogrammetry and Remote Sensing. A comunidade brasileira também tem produção relevante pela INPE, pelo Laboratório de Sensoriamento Remoto da UFRJ e pelo grupo do Professor Luiz Eulálio B. N. Souza no CNPq. O sensoriamento remoto e geoprocessamento é uma área que mistura física, estatística e ciência da computação de uma forma que poucas outras fazem. A parte difícil não é aprender a ferramenta. A parte difícil é saber qual ferramenta usar, quando não usar, e o que fazer quando o dado não obedece ao modelo. Isso só se aprende com o tempo e com a quantidade certa de imagem errada já processada.
Galeria
-
Sensoriamento Remoto E Geoprocessamento - RETOEDU -

Sensoriamento remoto e geoprocessamento na agricultura -

Sensoriamento remoto e geoprocessamento na agricultura
