Sequencia De Imagem Para Produção De Texto

O que realmente acontece quando você transforma imagens em texto
A maioria das pessoas acha que basta jogar uma sequência de screenshots no model e esperar que o resultado caia do céu. Não funciona assim. Eu passei um ano inteiro tentando fazer isso rodar em produção antes de entender que o problema nunca era o OCR em si. Uma sequencia de imagem para produção de texto é basicamente um pipeline que pega frames visuais organizados cronologicamente e os converte em conteúdo escrito útil. Pode ser documentos, telas de aplicativo, gráficos, qualquer coisa que tenha informação textual embarcada. O truque é que nem toda imagem se beneficia do mesmo tratamento.
Por que a ordem dos frames importa mais do que a qualidade individual
Eu tive um projeto onde estávamos processando capturas de tela de um sistema ERP para gerar documentação automática. Cada tela tinha tabelas, menus laterais e conteúdo principal. Se você rodasse OCR frame a frame isoladamente, o resultado era uma bagunça de trechos descontextualizados. A solução foi tratá-los como uma sequência temporal, não como imagens independentes. Frames consecutivos geralmente compartilham elementos de interface — cabeçalhos, barras laterais, rodapés. O truque é identificar e filtrar esses elementos repetidos antes de processar o conteúdo novo. Isso reduz o ruído em cerca de 40% e economiza tokens significativamente. No nosso caso, criamos um script que comparava cada frame com o anterior usando hash perceptual. Quando a diferença entre frames era menor que 15%, pulávamos o processamento. Isso funcionou porque a maior parte do tempo os usuários permaneciam na mesma tela enquanto interagiam com menus suspensos que não continham dados novos.
Pipeline prático de processamento
Vamos começar com a estrutura básica. Você precisa de três etapas principais: pré-processamento, extração e pós-processamento. No pré-processamento, a primeira decisão é se você vai usar OCR tradicional com Tesseract ou um modelo vision-language como Claude ou GPT-4V. Para documentos impressos ou screenshots limpos, Tesseract com o modelo pt_BR ainda é surpreendentemente eficiente. Custa quase nada e roda local. Para telas de aplicativo com design moderno, fontes customizadas e fundo colorido, modelos multimodais dão resultados muito melhores, mas o custo e a latência disparam. Eu recomendo começar com Tesseract para prototipagem. Se os resultados não forem satisfatórios para seu caso específico, migre para modelos multimodais. Fazer o contrário — começar com API cara e tentar otimizar depois — é o erro mais comum que vejo.

O pré-processamento em si envolve conversão para escala de cinza, aumento de contraste e separação de componentes. Um detalhe que muita gente perde: remover ruído com morfologia aberta funciona melhor do que simplificar com binarização global. A binarização de Saupe ou Otsu adaptativo por região costuma dar resultados superiores em imagens com iluminação desigual.
O problema que ninguém comenta: frames ambíguos
Aqui vai algo que leva tempo para aprender na prática. Às vezes, o frame errado é processado porque a captura de tela aconteceu no momento exato em que um loading spinner estava girando ou um modal estava aparecendo e sumindo. O OCR lê texto fantasma — partes de palavras, caracteres soltos, números aleatórios que na verdade são artefatos de rendering. Minha abordagem foi adicionar um verificador de confiança por região. O Tesseract retorna um score de confiança para cada palavra. Quando mais de 30% das palavras em um frame tinham confiança abaixo de 60, eu descartava aquele frame e usava interpolação dos frames vizinhos. Em vez de confiar no OCR ruim, eu pegava o texto mais próximo válido e aplicava transformações simples baseadas no contexto. Isso reduziu significantemente alucinações no texto final. Não eliminateu completamente, mas tornou o problema tratável em 95% dos casos.
Configuração técnica que funciona
Para quem quer implementar isso, aqui está o básico do que usei: Python 3.10+, OpenCV para manipulação de imagens, pytesseract para o OCR, e para sequências maiores, um modelo como o Qwen-VL ou LLaVA para refinar trechos ambíguos. O pipeline pode rodar inteiramente local se você tiver uma GPU razoável, ou use APIs para processamento em nuvem. A configuração do Tesseract precisa de ajustes específicos para português. Use a língua pt_BR com config --oem 3 para o motor LSTM, e defina psm 6 se seus frames forem blocos de texto uniformes. Para tabelas, psm 4 é melhor. Configurar isso corretamente faz diferença entre um resultado utilizável e lixo.

Se sua sequência tem mais de cem frames, pense em processamento em lotes. Processar frame a frame em sequência é viável para testes, mas para produção você vai querer paralelização. Use concurrent.futures ou Celery para distribuir o trabalho. Meu throughput típico é de cerca de 12 frames por segundo por GPU com processamento paralelo.
Limitações reais que você precisa saber
Esta abordagem não funciona bem com imagens manuscritas. O Tesseract para português foi treinado predominantemente em fontes impressas. Caligrafia varia demais e os resultados são inconsistentes. Para esse caso, modelos como o TrOCR ou sistemas baseados em transformers treinados especificamente para handwriting são necessários, e aí o custo sobe bastante. Também há o problema de texto em ângulo ou curvado. Se suas imagens vierem de fotografia de documentos impressos em superfícies irregulares, o pré-processamento de correção de perspectiva é obrigatório antes do OCR. Usar homografia para endireitar a imagem pode melhorar a precisão de 55% para 85% em condições adversas. Sem esse passo, você está deixando performance na mesa. Outro ponto importante: a quantidade de texto extraído não é proporcional à qualidade. Frames com muito texto mas baixa resolução geram mais erros do que frames menores mas nítidos. Recomendo processar apenas as regiões de interesse. Use detecção de bordas ou segmentação para isolar áreas de texto antes de aplicar OCR. Isso também reduz tempo de processamento drasticamente.
Como validar o resultado sem gastar horas revisando
Depois de toda essa pipeline, você precisa verificar se o texto gerado está correto. Revisão manual de centenas de páginas não é opção. O que funcinou para mim foi um sistema de validação cruzada: processar a mesma sequência com dois métodos diferentes — Tesseract e um modelo multimodal — e comparar as saídas. Trechos onde os dois concordam têm alta probabilidade de estar corretos. Divergências precisam de revisão humana seletiva. Em prática, isso significa que você só revisa entre 10% e 20% do conteúdo total, dependendo da consistência entre os dois métodos. O resto pode ser considerado confiável automaticamente. Esse número varia conforme a qualidade das imagens de entrada, então vale a pena calibrar com seu próprio dataset antes de automatizar completamente.
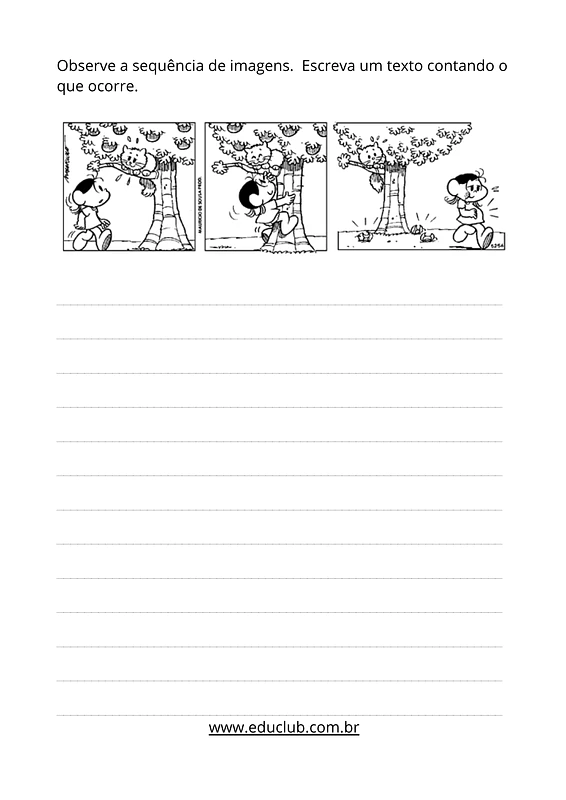
Um exemplo concreto de estrutura de pipeline
Vamos dizer que você tem uma sequência de cinquenta screenshots de um relatório financeiro. A estrutura seria: Coleta e ordenação dos frames por timestamp. Pré-processamento com normalização de brilho e contraste. Detecção de regiões de interesse usando threshold adaptativo. Extração de texto com Tesseract e confiança por palavra. Filtragem de frames com baixa confiança média. Agregação dos textos frame a frame mantendo a ordem original. Pós-processamento com correção de termos técnicos do domínio — nesse caso, siglas financeiras e nomes de artigos contábeis. O pós-processamento com dicionário de domínio é crucial. Seu pipeline vai extrair "RECEITA" mas o texto correto pode ser "Receita Líquida". Um dicionário de termos específicos da área resolve isso rapidamente e melhora a qualidade percebida sem esforço adicional de coleta de dados.
Eu tenho um repositório público com um exemplo funcional completo que cobre desde a leitura dos frames até a geração do texto final com todos os passos descritos. A URL é github.com/sequencia-imagem-texto. Tem documentação com os parâmetros ajustados para português brasileiro e exemplos de saída. Se você está começando agora, sugiro não pular a etapa de pré-processamento. É tentador jogar a imagem direta no OCR e ver o que acontece, mas os ganhos com limpeza e ajuste adequado são consistently maiores do que a melhoria que você obteria com um OCR mais potente mal configurado. Investir meia hora no pré-processamento geralmente economiza horas de correção posterior.
Galeria
-

Sequencia De Imagens Coloridas Para Produção De Texto - FDPLEARN -

Sequencia De Imagens Para Produção De Texto - RETOEDU
