Simbolos Caracteres

Trabalhando com símbolos e caracteres especiais no dia a dia
Precisei resolver um problema chato semana passada com um arquivo CSV que tinha acentos estranhos vindos de um sistema legado. O Excel abria tudo como quadrados e pontinhos. Não eraação UTF-8, era ISO-8859-1 disfarçado. Perdi cerca de vinte minutos só para perceber que o cabeçalho do arquivo vinha com um BOM incorreto. A solução foi abrir no Notepad++, ir em Codificação Transcodificar para UTF-8, salvar, e aí sim importar corretamente. Esse tipo de situação acontece o tempo todo quando se mexe com simbolos caracteres em arquivos que trafegam entre sistemas diferentes. O universo de caracteres que podemos usar num computador vai muito além do alfabeto latino. Temos os símbolos matemáticos — mais, menos, igual, infinito — que todo mundo conhece. Temos os caracteres técnicos como o parágrafo (§), o degree (°), a copyright (©). Temos emoji, que tecnicamente são caracteres Unicode também. E temos os que a gente nem nota que existem, como o space invisível (U+00A0) ou o zero-width joiner, que fazem coisas específicas em processamento de texto.
Entendendo a diferença entre símbolos e caracteres
Muita gente usa essas palavras como sinônimos, mas fazem coisas diferentes. Um caractere é a unidade mínima de escrita. A letra "A", o número "5", o cifrão "$" — cada um é um caractere. Um símbolo é um tipo específico de caractere que representa uma ideia abstrata, não necessariamente uma letra ou número. O & é um símbolo. O é um símbolo. O também é. O que complica as coisas é que o mesmo glifo pode ser classificado de formas diferentes dependendo do contexto. O número romano "" é um caractere Unicode (U+2163), mas muita gente digita "IV" normal e acha que é a mesma coisa. Não é. Em processamento de texto, essa distinção importa porque o "" tem uma codificação fixa, enquanto "IV" depende da fonte e do contexto. Quando falo de simbolos caracteres, estou me referindo basicamente a todo esse repertório que usamos em documentos, planilhas, códigos e interfaces. O conjunto completo no Unicode atual tem mais de cento e cinquenta mil caracteres registrados. Desses, uns cinquenta mil são usados regularmente na prática. O resto são históricos, técnicos ou de línguas específicas.
Como inserir e manipular esses caracteres
No Windows, o jeito mais rápido é apertar Win + Ponto (ou Win + Ponto e Vírgula). Abre um painel direto onde você digita o nome ou vê os grupos. Se você precisa de algo como ™, € ou ™, esse painel resolve em segundos. Antes disso, usávamos o charmap.exe, que ainda funciona mas é mais lento e visualmente pior. No macOS, é Control + Command + Espaço. Abre o mesmo tipo de painel, mas integrado ao sistema. No Linux, depende da distribuição, mas quase todo mundo usa oibus ou o fcitx, que têm painéis próprios. Em navegadores web, você pode copiar e colar símbolos diretamente de sites como utf8-icons.com ou unicode-table.com. Funciona bem, mas tem uma pegadinha: alguns caracteres que parecem iguais visualmente têm codepoints diferentes. O ' (apóstrofo, U+0027) parece idêntico ao ' (aspas simples esquerda, U+2018) na maioria das fontes. Mas em processamento de texto, eles são coisas completamente distintas. Já vi banco de dados inteiro quebrar por causa disso.

Para desenvolvedores que trabalham com código, a forma mais confiável de inserir um caractere especial é usando a notação de escape. Em JavaScript, "\u00A9" é o copyright. Em Python, "\u2022" é o bullet. Em CSS, "\\00A9" funciona dentro de strings. Se estiver num arquivo HTML, você pode usar o entity name (©) ou o entity number (©). Todas essas formas produzem o mesmo resultado visual, mas representam o caractere de maneiras diferentes internamente. Uma situação que quase ninguém considera: a ordem dos bytes importa mais do que parece. O UTF-16 usa little-endian ou big-endian, e isso define se um caractere como o ç (U+00E7) vai ser armazenado como "E7 00" ou "00 E7". Se você ler um arquivo UTF-16 com a ordem errada, todos os caracteres aparecem invertidos. Já recebi um log de erro inteiro com caracteres que pareciam aleatórios. A solução foi detectar o BOM (Byte Order Mark) no início do arquivo e tratar de acordo.
Pitfalls comuns que todo mundo encontra
O primeiro problema que aparece é a comparação de strings. "São Paulo" com acento normal e "São Paulo" com o acento formando por um combining character (U+0301 em cima do o) parecem idênticos visualmente, mas são byte sequences diferentes. Uma comparação direta de igualdade vai falhar. A solução é normalizar a string usando NFC ou NFD antes de comparar. No Python, usa-se unicodedata.normalize(). No JavaScript, tem o .normalize(). O segundo problema é a length de strings. "Olá" tem cinco caracteres visuais, mas em UTF-8 ocupa seis bytes. O "é" é um character só, mas ocupa dois bytes. Se você contar bytes achando que são caracteres, vai perder dados. Já vi aplicações que truncavam textos no meio de um caractere multibyte e geravam erro na tela. O correto é sempre trabalhar com codepoints, não bytes, quando o assunto é exibição. O terceiro problema é a ordenação. Em português, "São" vem depois de "Sam" tradicionalmente, mas num sort simples por codepoint UTF-8, a ordem pode ser diferente. Isso acontece porque o Unicode não leva em conta regras de ordenação de línguas específicas. Se você precisa ordenar corretamente em português, tem que usar o collator do ICU ou a função localeCompare do JavaScript passando o locale "pt-BR". Sem isso, a ordenação fica errada e isso passa despercebido até alguém reclamar.
Outro problema clássico é a questão do espaço não-break. O caracter U+00A0 parece um espaço normal, mas impede quebra de linha. Muita gente usa pra evitar que o "R$ 1.000" seja partido entre duas linhas. Funciona, mas tem um custo: ferramentas de busca e alguns processadores de texto não tratam esse espaço da mesma forma que o espaço comum (U+0020). Se você tá indexando conteúdo pra busca, o espaço não-break pode fazer com que palavras adjacentes não sejam encontradas juntas. Aqui vai uma situação real que encontrei: um sistema de envio de SMS que suporta caracteres gregos e cirílicos usa o codificador GSM-7 com expansão. Quando o texto contém certos caracteres especiais, como o © ou o §, o codificador muda de 7-bit padrão para 8-bit, o que dobra o tamanho da mensagem e afeta a contagem de chars por SMS. Eu descobri isso quando um cliente reclamou que a mensagem estava sendo cobrada como duas SMS em vez de uma. A solução foi limitar o uso desses símbolos na mensagem ou avisar o usuário sobre o custo adicional.

Alternativas quando o Unicode não resolve
Às vezes, o problema não é inserir o caractere certo, mas sim exibi-lo de forma consistente. Se você precisa mostrar um símbolo que não existe no sistema do usuário, a alternativa mais comum é usar uma imagem SVG no lugar. É o que fazem os sites de icones como FontAwesome — eles transformam caracteres em paths vetoriais. Outra alternativa é usar ligaduras ou glyphs substitutos. Fontes como Noto ou Source Han proporcionam cobertura bastante ampla, mas ainda assim não cobrem tudo. Para caracteres raros de línguas indígenas ou scripts históricos, você pode precisar de uma fonte específica ou simplesmente aceitar que o usuário vai ver um quadrado ou ponto de interrogação. Se o problema é armazenamento em banco de dados, a resposta certa depende do SGBD. MySQL com collation utf8mb4_general_ci suporta quase tudo. PostgreSQL com SQL_ASCII também, mas é mais permissivo e pode aceitar dados inválidos sem reclamar. Oracle tem a opção AL32UTF8. O importante é garantir que o cliente (seja app web, desktop ou mobile) esteja usando a mesma codificação na conexão.
Downloads e fontes úteis
Para quem precisa brincar com simbolos caracteres de forma mais prática, algumas ferramentas são essenciais. O Unicode Character Database (UCD) está disponível gratuitamente no site unicode.org e tem tabelas completas de todos os codepoints. O charset.sql do MySQL mostra os mapeamentos de caracteres suportados pelo banco. Para testar rapidamente a codificação de um arquivo, o comando `file -bi` no Linux ou o `Get-Content` com o parâmetro -Encoding no PowerShell do Windows ajudam a identificar problemas sem precisar abrir nada visualmente. O enc2utf8 é uma ferramenta de linha de comando que faz a conversão em lote de arquivos inteiros. Se você trabalha com documentos que precisam manter formatação especial, o LibreOffice Writer tem uma funcionalidade útil: seleciona o texto, vai em Formatar Caractere Mais, e escolhe a font específica que suporta os símbolos que você precisa. Isso evita que o texto vire quadrados quando exportado para PDF ou enviado para outro sistema.
O limite prático é que nenhuma ferramenta resolve tudo. Se você precisa suportar caracteres de línguas que a maioria dos sistemas nunca viu, tenha paciência e prepare fallbacks. O melhor cenário que já vi foi um sistema que usava uma abordagem híbrida: caracteres comuns via Unicode normal, símbolos técnicos via SVG inline, e casos extremos com uma lista de substituía gerenciada pelo usuário final. Demorou para configurar, mas funcionou sem dor de cabeça por anos.

Galeria
-
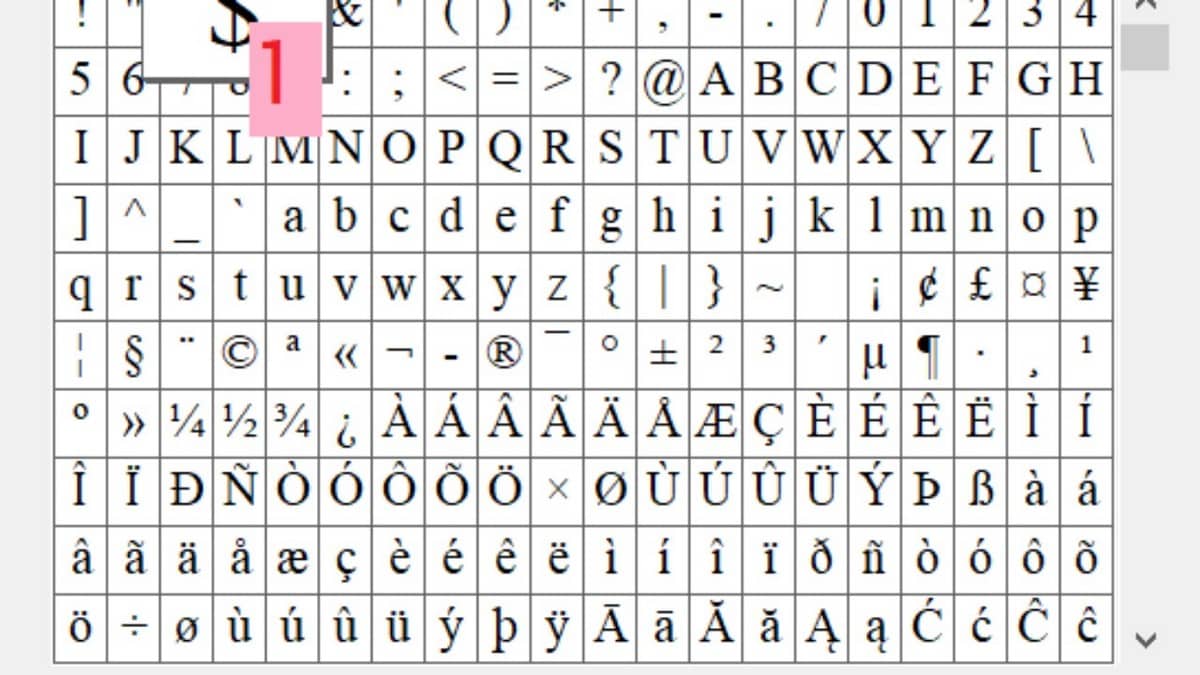
Como Fazer Símbolos E Caracteres Especiais Utilizando O Teclado. – WDIB -

?⭐ ️Guía de signos y símbolos del teclado para caracteres especiales
