Tabela De Codigo Genetico

Como usar a tabela de código genético na prática
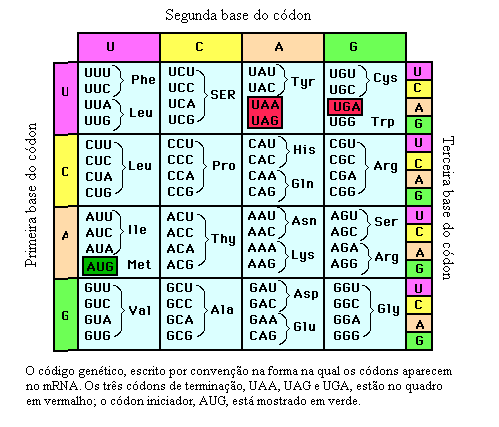
Uma tabela de código genético é basicamente uma lista de todos os códons possíveis e os aminoácidos que cada um codifica. Existem 64 combinações de tríades de nucleotídeos, e a maioria mapeia para um dos 20 aminoácidos padrão. Três são códons de parada. O que muita gente não leva em conta na hora de olhar essa tabela é que o código genético padrão tem variações em organelas e em certos organismos, então usar a versão "padrão" cegamente pode gerar resultados errados dependendo do contexto experimental. Cada linha da tabela contém um códon de RNA mensageiro, escrito na orientação 5' para 3'. Os códons são formados por adenina, uracila, guanina e citosina. Por exemplo, AUG é o códon de iniciação e codifica metionina. UAA, UAG e UGA são os três códons stop. A tabela em si é simétrica na maioria das versões impressas: os dois primeiros nucleotídeos definem a coluna e a linha, enquanto o terceiro nucleotídeo fica à direita, refletindo o que chamamos de efeito wobble no pareamento com o anticódon do tRNA. Eu já perdi tempo num projeto de clonagem porque assumi que a tabela padrão valia pro mitocondrial de uma levedura que estávamos usando. O códon CUA, que na tabela padrão codifica leucina, no mitocondrial daquele organismo pode ser lido como outra coisa. A correção foi simples: substituir a tabela na hora de desenhar os primers e traduzir a sequência in silico, mas o erro já tinha custado uma rodada de teste. Sempre verifique qual variante do código genético se aplica ao seu organismo de interesse antes de confiar cegamente na tradução automática.
Como traduzir uma sequência usando a tabela
Primeiro você precisa ter a sequência de RNA ou DNA codificante na direção correta. Se estiver em DNA, substitua timina por uracila para usar a tabela diretamente, ou use uma ferramenta que faça essa conversão internamente. Depois, leia a sequência em grupos de três nucleotídeos, começando do códon de início mais próximo se estiver tratando de uma sequência codificante completa, ou simplesmente do primeiro nucleotídeo se for uma tradução direta de leitura livre. Um detalhe prático que todo mundo esquece: a tabela de código genético opera em RNA, não em DNA. Se você pegar uma sequência genômica bruta e tentar traduzir sem antes identificar a fita codificante correta, vai obter uma proteína completamente errada ou uma cadeia cheia de códons stop prematuros. A fita molde e a fita codificante são complementares, e só uma delas gera o mRNA que a tabela traduz. Isso é especialmente importante quando se trabalha com sequências virais ou organelas, onde a orientação das fitas nem sempre segue o padrão que textbooks mostram. Na prática, eu uso um script Python rápido que lê a sequência, faz a transcrição se necessário, verifica se há um start codon viável e traduz até encontrar o primeiro stop. O tempo de tradução de uma sequência de alguns kilobases leva menos de um segundo. O problema real não é a velocidade, é a validação da sequência de entrada e a escolha da tabela certa. Eu mantenho uma versão local das tabelas NCBI para os códigos 1 (padrão), 2 (viral), 3 (mitochondrial), 4 (platyhelminth) e 11 (bacterial), porque já me arrependi de depender de tradutores online que usam apenas a versão padrão por padrão.
Pegadinhas comuns e como evitar erros
A primeira pegadinha é a ambiguidade do códon de início. AUG quase sempre começa com metionina, mas em procariotas o aminoácido inicial é formilmetionina, e a tabela padrão não marca essa diferença. Se você estiver expressando uma proteína bacteriana e precisar processá-la corretamente, precisa saber disso de antemão. Outro ponto é que códons sinônimos não são neutros em todos os contextos. A frequência de uso de cada códon varia entre organismos, e isso afeta a eficiência de tradução. Se você for fazer expressão heteróloga, otimizar os códons para o hospedeiro escolhido pode fazer diferença real no rendimento. Uma segunda pegadinha que eu vejo sempre é gente traduzir sequências que contêm íntrons ou regiões não traduzidas sem filtrar antes. A tabela de código genético não sabe onde termina um éxon ou onde começa um UTR. Ela apenas traduz trinca por trinca. Se a sequência tiver um frame shift por inserção ou deleção que não seja múltiplo de três, a proteína resultante vai mudar completamente a partir desse ponto. Eu tenho um hábito de verificar o frame de leitura antes de confiar na tradução, especialmente quando trabalho com dados de sequencing que podem ter indels. O efeito wobble também merece atenção. O terceiro nucleotídeo do códon tem uma flexibilidade maior no pareamento com o anticódon, o que significa que alguns tRNAs conseguem reconhecer mais de um códon. Isso é parcialmente refletido na tabela, mas quem está desenhando oligonucleotídeos para mutagênese ou sonda precisa entender que mudanças no terceiro posição às vezes são silentes e às vezes não, dependendo do organismo e do tRNA disponível. Não há regra universal aqui, e testar empiricamente é mais seguro do que assumir.
Quando a tabela padrão não serve
O código genético varia. Em alguns casos essa variação é sutil, em outros é drástica. O mitocondrial de vertebrados, por exemplo, usa AUA para isoleucina em vez de metionina, e AGA e AGG como códons stop em vez de arginina. Protozoários como o Tetrahymena usam UAA e UAG para glutamina, não para parada. Se você está trabalhando com qualquer organismo que não seja o modelo padrão de laboratório, consulte a tabela específica para aquele organismo. A NCBI mantém essas variações em seus resources, e o custo de perder tempo tentando entender por que uma tradução não faz sentido é muito maior do que o tempo que se leva para ajustar a tabela de entrada. Outro cenário onde a tabela falha é na presença de modificações pós-transcricionais raras ou em sistemas sintéticos com aminoácidos não canônicos. A tabela de código genético convencional só cobre os 20 aminoácidos padrão e os três stops. Se você estiver usando expandindo o código genético com aminoácidos artificiais, precisa de uma tabela personalizada que inclua esses elementos. Ferramentas como o Genetic Code Calculator do IDT permitem carregar tabelas personalizadas, mas isso exige que você defina explicitamente cada códon e seu mapeamento.
Recursos úteis
A tabela mais confiável que eu uso é a da NCBI, disponível no site deles na seção de Genetic Code. Ela lista todas as variantes com os respectivos códigos numéricos, e você pode baixá-la ou consultar online. Para uso local, eu recomendo manter uma cópia em formato CSV ou JSON, porque ferramentas de análise de sequência muitas vezes não permitem selecionar a variante do código genético e assumem a padrão. Se você trabalha com bioinformática rotineiramente, ter essa tabela local evita surpresas. Uma alternativa prática para quem não quer montar seu próprio pipeline é usar o Translate Tool do ExPASy ou o EMBOSS transeq, ambos allowing selection of the genetic code table from a dropdown. O EMBOSS é open-source e roda localmente, o que é bom para dados sensíveis ou workflows automatizados. Eu prefiro o EMBOSS porque consigo embutir a escolha da tabela em scripts, garantindo que a tradução seja consistente em todas as rodadas de análise. Se o seu foco é didático ou você precisa de uma referência rápida, uma versão simplificada da tabela de codigo genetico pode ser encontrada em materiais introdutórios de biologia molecular, mas eu sempre cruzo com a fonte primária antes de usar para qualquer coisa que tenha consequências experimentais. A tabela é simples na superfície, mas as implicações práticas dela são onde os erros acontecem, e é aí que a experiência de campo mostra a diferença entre usar a tabela corretamente e confundi-la com uma fórmula que funciona em qualquer situação.
Galeria
-

Tabela De Codigo Genetico -

Tabela De Codigo Genetico - ZULEDU -
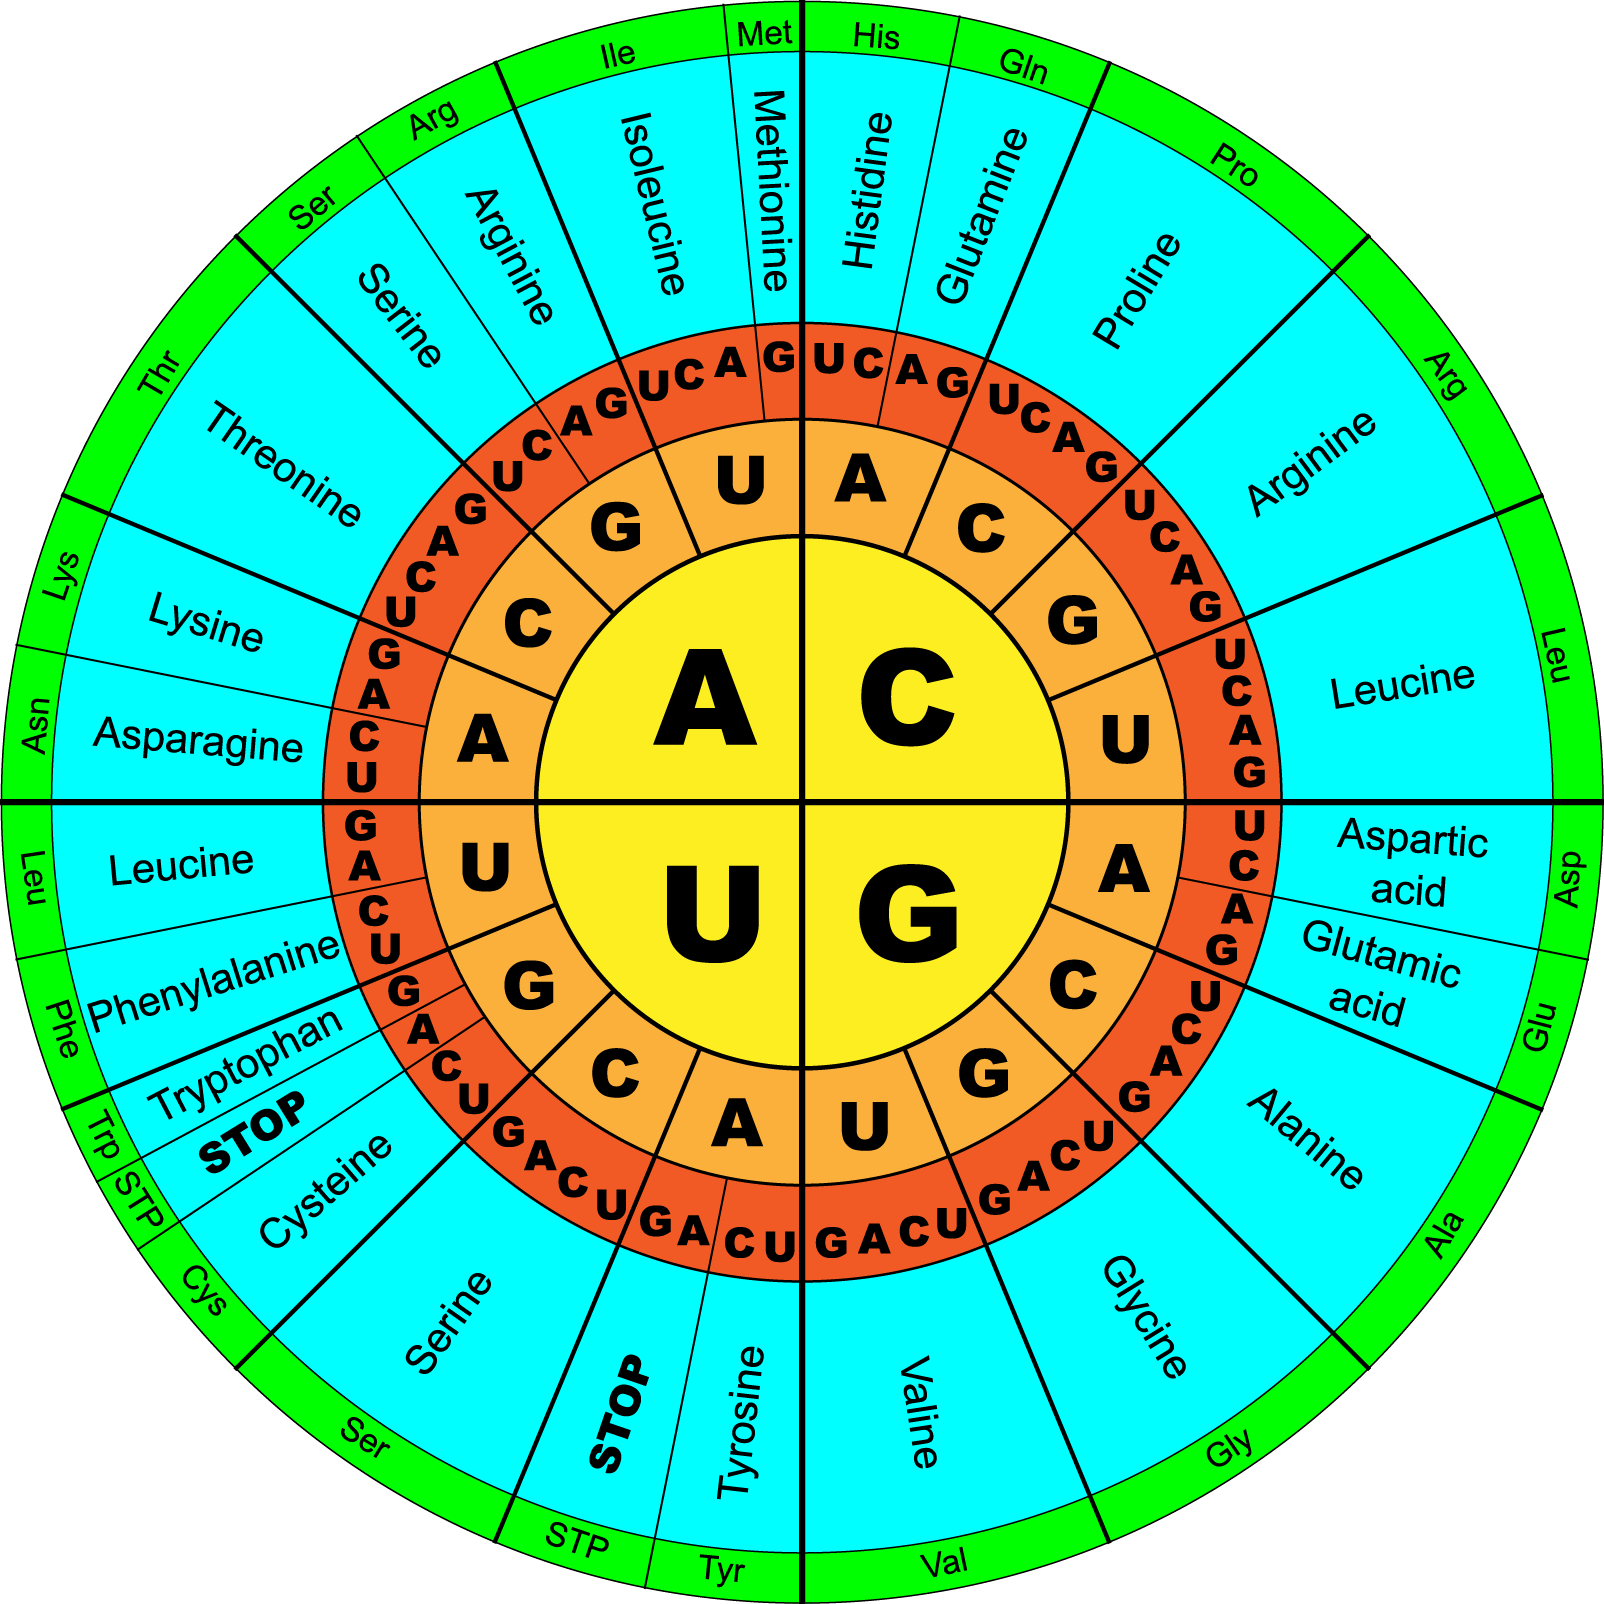
Tabela De Codigo Genetico -

AIO | A Tabela Apresenta O Codigo Genetico Com Os Codons E
