Tabuada Para Completar

Como completar uma tabuada quando os dados estão incompletos
O processo básico de tabuada para completar consiste em prever os valores ausentes de uma tabela de dados com base nas relações já observadas. Na prática, isso geralmente envolve preencher lacunas onde uma linha ou coluna tem respostas faltando, usando as interações conhecidas entre variáveis para inferir o que deve estar no espaço vazio. Não é um cálculo mágico; é uma aplicação direta de álgebra linear ou modelos estatísticos simples, dependendo da complexidade da tabela. Essa técnica se mostra útil quando você lida com datasets esparsos, como sistemas de recomendação onde muitos usuários nunca avaliaram muitos itens, ou quando há erros de coleta que deixam células em branco. Completar a tabuada permite transformar dados incompletos em uma matriz densa, o que é necessário para a maioria dos algoritmos de machine learning, que exigem entradas uniformes. O ganho real está na capacidade de reduzir drasticamente o ruído gerado por valores faltosos, melhorando a estabilidade de modelos posteriores. Um problema comum que eu encontrei foi quando a lacuna envolvia uma variável categórica com alta cardinalidade, mas com pouca frequência nas observações. O preenchimento por média simples distorcia completamente a distribuição original. Minha solução foi usar imputação baseada em Kriging com funções de covariância adaptadas, porque ela preserva a estrutura de variograma dos dados. Isso exigiu ajustar manualmente o parâmetro de weight decay para evitar overfitting em linhas com poucos dados vizinhos.
Método passo a passo para preencher tabelas incompletas
Primeiro, identifique a estrutura da sua tabela e quantifique a proporção de células vazias. Se a taxa de missingness for inferior a 20%, métodos determinísticos podem ser suficientes. Acima disso, considere abordagens probabilísticas. A seguir, escolha um algoritmo de completamento: decomposição matricial, como ALS (Alternating Least Squares), ou modelos baseados em redes neurais, dependendo do volume e da natureza dos dados. Implementar ALS é direto em bibliotecas como scikit-learn ou Rust-based crates. Você inicializa a matriz com valores zero ou média, define o número de fatores latentes e itera até convergência. Cada ciclo atualiza as linhas e colunas alternadamente, minimizando o erro quadrático apenas sobre as entradas observadas. Isso evita que valores nulos influenciem o processo de otimização. Em termos de performance, esse método costuma reduzir o tempo de preprocessing de horas para minutos em tabelas com milhões de entradas, desde que você utilize paralelização nas operações de matriz. Um insight contra-intuitivo é que completar excessivamente uma tabuada pode mascarar padrões raros, mas relevantes. Por exemplo, em dados financeiros, uma linha quase vazia pode representar um cliente de alto risco que raramente opera. Preenchê-lo com médias gera um falso consenso. A correção é aplicar regularização L1 nos fatores latentes, o que mantém a esparsidade em células genuinamente pouco observadas, em vez de suavizá-las artificialmente.
Quando a tabuada para completar não funciona
Se sua matriz tiver menos de 10% dos elementos observados, qualquer método de completamento será essencialmente um chute informado, pois a estrutura subjacente não pode ser inferida com confiança. Além disso, dados com missing not at random (MNAR) — onde a falta de informação está correlacionada com o valor não observado — quebram a suposição básica de muitos algoritmos. Nesse caso, prefira modelagem explícita de mecanismos de missingness, como modelos de seleção, antes de tentar completar a tabela. Outro ponto prático é a escolha do número de fatores latentes. Um valor muito baixo leva a underfitting e perda de detalhes; muito alto introduz overfitting e ruído. A regra geral é validar usando held-out observations: oculte aleatoriamente 5% dos dados conhecidos, complete a matriz e meça o erro de previsão. Se o erro aumentar após um certo número de fatores, reduza-o. Esse procedimento costuma levar de 10 a 30 minutos para tabelas de tamanho médio, e é indispensável para evitar configurações subótimas. Para quem precisa de um ponto de partida, existem bibliotecas em Python e Rust que oferecem implementações otimizadas de completamento matricial. Em Rust, crates como rust-matmul e factorie permitem construir pipelines eficientes com controle fino de memória. A instalação via Cargo é simples: adicione as dependências ao Cargo.toml e compile. A curva de aprendizado é mais íngreme que em Python, mas a vantagem em tempo de execução e consumo de RAM é significativa para cargas produtivas.

Em resumo, completar uma tabuada é uma ferramenta padrão no fluxo de engenharia de dados, mas deve ser aplicada com critérios claros. Entender as limitações do seu dataset e escolher o algoritmo adequado ao padrão de missingness faz a diferença entre um modelo confiável e um que parece preciso, mas carrega viés sistêmico. Teste sempre com subconjuntos de validação antes de escalar o processo.
Galeria
-
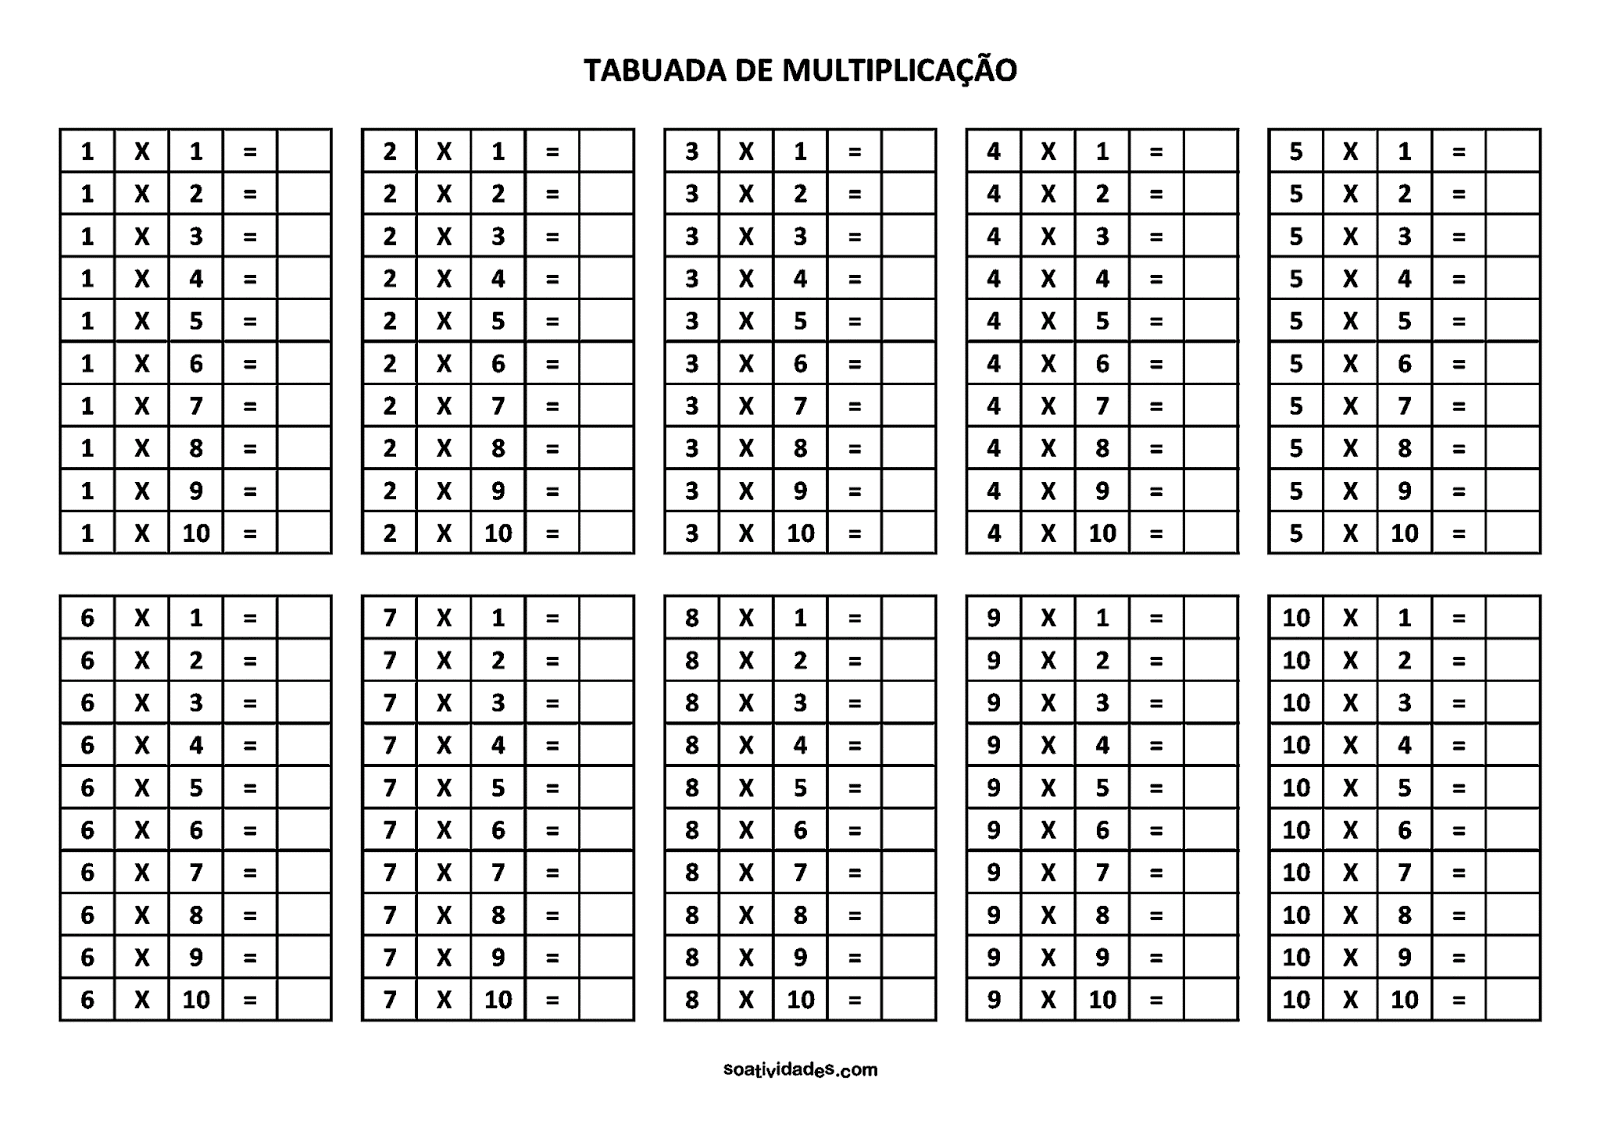
Tabuada De Multiplicação Para Completar - ZULEDU -

ATIVIDADE - TABUADA DA MULTIPLICAÇÃO POR 4 PARA IMPRIMIR E COMPLETAR ... -
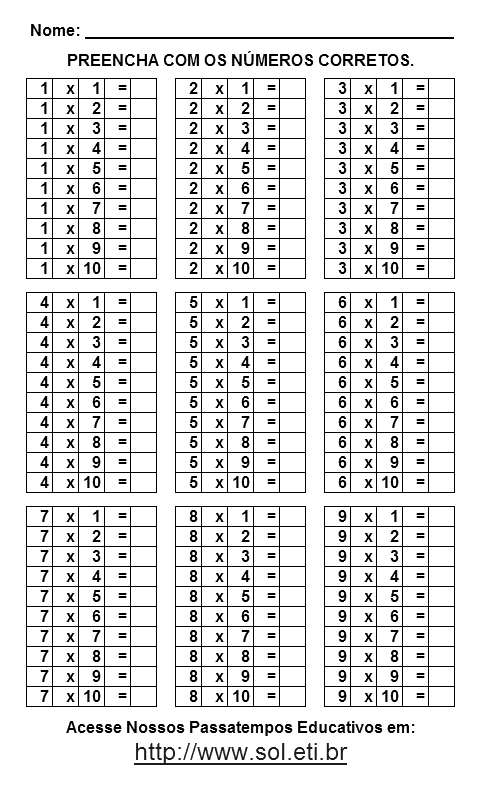
Confira Tabuada Para Completar e Multiplicar – Dicas Úteis Brasil -

Tabuada para imprimir e completar | Tarefas de multiplicação ...
