Tcp Ip Transmission Control Protocol Internet Protocol

Por que a sua aplicação não consegue se conectar (e como consertar)
TCP/IP é o conjunto básico de regras que permite que computadores se comuniquem entre si em uma rede. Transmission Control Protocol cuida da entrega confiável dos dados, dividindo informações em pacotes, numerando-os e solicitando retransmissões quando algo se perde. Internet Protocol é o sistema de endereçamento e roteamento que garante que cada pacote chegue ao destino certo. Sem isso, nada no universo das redes modernas funciona. É simples na teoria, mas na prática gera uma quantidade imensa de dor de cabeça. Eu configurei um servidor de banco de dados em uma VLAN separada há uns três anos e passei duas semanas tentando diagnosticar por que as conexões cairiam aleatoriamente a cada 47 segundos. O problema não era o banco, nem a rede, nem o firewall. Era o MTU. A interface de rede do servidor tinha MTU 1500, mas o túnel VPN entre os data centers usava 1400. Pacotes maiores que isso eram fragmentados de forma inconsistente, e o TCP entrava em um loop de retransmissão silenciosa que nenhum log mostrava. A solução foi rodar um tcpdump com a flag -XX e comparar o tamanho dos pacotes SYN com o que efetivamente trafegava pelo túnel. Defini o MTU da interface virtual para 1360 e o problema sumiu. Nunca mais voltou.
Entendendo tcp ip transmission control protocol internet protocol na prática
O modelo TCP/IP não é uma pilha rígida como o modelo OSI que muitos cursos ensinam. Ele opera em quatro camadas funcionais: link, internet, transporte e aplicação. Cada camada tem responsabilidade específica, mas na hora que algo quebra, é fácil confundir qual delas é a culpada. No nível de transporte, o TCP faz controle de fluxo com a janela deslizante e controle de congestão com algoritmos como Reno, Cubic ou BBR. O UDP, por outro lado, não tem nenhuma dessas garantias. Ele simplesmente joga os dados e torce. Isso não é um defeito — é uma escolha de projeto. Aplicações como DNS, VoIP e streaming usam UDP porque latência importa mais que confiabilidade absoluta. O IP opera no nível de internet e é completamente stateless. Cada pacote é tratado de forma independente. Não existe sessão mantida pelo IP. Se dois pacotes de uma mesma transmissão seguem caminhos diferentes, podem chegar em ordens diferentes, com latências diferentes, ou nem chegar. Caberá ao TCP na outra ponta reorganizar tudo.
Um detalhe que poucos mencionam: o handshake de três vias do TCP (SYN, SYN-ACK, ACK) não é apenas uma formalidade. Ele é onde negociamos o ISN inicial, o tamanho da janela de recepção e as opções de otimização como SACK e window scaling. Se algum firewall intermediário estiver inspecionando pacotes de forma agressiva, pode corromper essas opções sem avisar, e você fica com uma conexão que parece estabelecida mas performa muito abaixo do possível. Já vi isso acontecer com algumas Appliances de firewall legado que modificavam headers TCP sem atualizar os checksums corretamente. A conexão permanecia ativa por horas, mas a throughput caía para quase zero. Desliguei a inspeção profunda daquele firewall e o problema resolveu em minutos.

Como configurar e diagnosticar conexões TCP/IP
A primeira coisa que você precisa saber é que quase qualquer problema de conectividade pode ser isolado em uma das camadas. Não tente adivinhar. Teste de forma sistemática. Comece com o básico. Verifique se o endereço IP está configurado corretamente na interface, se a máscara de sub-rede faz sentido, e se o gateway padrão aponta para o equipamento certo. Um erro comum em ambientes com múltiplas NICs é ter mais de um gateway padrão definido. O sistema escolhe um deles de forma imprevisível, e as conexões parecem funcionar às vezes e falhar outras. Isso acontece especialmente em servidores com duas interfaces de rede em redes diferentes. Use o comando ping com tamanho de pacote variável para testar a conectividade e detectar problemas de MTU. Pingar com pacotes de 1500 bytes e ir reduzindo até encontrar o tamanho máximo que não gera fragmentação pode economizar horas de troubleshooting. Em Linux, use a flag -M do ping para forçar o bit Do Not Fragment e identificar o path MTU exato.
Para verificar o estado das conexões TCP, o netstat e o ss são ferramentas padrão. O ss é mais rápido e mostra informações mais detalhadas sobre o estado de cada conexão. Fiquem de olho nos estados CLOSE-WAIT e TIME-WAIT. Muitas conexões CLOSE-WAIT acumuladas indicam que a aplicação não está fechando sockets adequadamente. Isso consome memória do sistema e pode impedir novas conexões. O TIME-WAIT normal é esperado — indica que a conexão foi encerrada mas o socket ainda está retido pelo tempo de dois MSL (Maximum Segment Lifetime), que geralmente é 60 segundos. É proteção contra pacotes atrasados que poderiam confundir uma nova conexão com o mesmo par de endereços. Quando precisar ver o tráfego em tempo real, o tcpdump é insubstituível. Filtros como tcp[tcpflags] & tcp-syn != 0 isolam apenas pacotes SYN, útil para detectar scanners ou tentativas de conexão que estão sendo descartadas. Se você estiver investigando uma conexão lenta, monitore os retransmits com tcpdump -i any tcp[tcpflags] & tcp-ack != 0 && tcp[tcpflags] & tcp-psh != 0. Pacotes com ACK e PSH setados que se repetem com os mesmos números de sequência indicam retransmissão.
Erros comuns que estragam suas conexões
O primeiro erro que vejo todo dia é configuração incorreta de DNS. O TCP/IP resolve nomes usando DNS, e se o servidor DNS estiver lento ou inacessível, cada conexão nova vai ter um delay de 1 a 3 segundos antes de estabelecer. Isso é particularmente problemático em aplicativos que abrem muitas conexões curtas. A solução óbvia é usarDNS locais como dnsmasq ou ajustar o resolv.conf com servidores confiáveis e próximos geograficamente. Outro problema frequente é a conflito de endereços IP. Dois dispositivos com o mesmo IP na mesma subnet causam comportamento errático que é quase impossível de diagnosticar olhando apenas os logs. Um dispositivo responde às requisições, o outro não. O TCP entra em looping de timeout e retransmissão porque os ACKs chegam de endereços MAC diferentes. Use ARP monitor ou ferramentas como arp-scan para detectar conflitos rapidamente. O bufferbloat é um fenômeno que poucas pessoas conhecem mas que impacta diretamente a performance percebida das conexões TCP. Quando os buffers de roteadores e switches ficam muito grandes, os pacotes aguardam fila em vez de serem perdidos precocemente. O TCP interpreta a fila cheia como congestão e reduz agressivamente a taxa de transmissão, mesmo quando a largura de banda disponível é suficiente. Isso causa latência alta e throughput instável. A correção envolve configurar fq_codel ou PIE nos buffers de rede, o que mantém as filas curtas e responde rapidamente a picos de congestão.

Firewalls que fazem stateful inspection mal configurados também são uma fonte constante de problemas. Regras que permitem conexões de saída mas bloqueiam os pacotes retornados de estados estabelecidos quebram o TCP silenciosamente. O resultado é uma conexão que inicia mas nunca transferencia dados úteis. Sempre verifique a ordem das regras e o estado esperado do tráfego retornado.
O que o TCP/IP não resolve
É importante ser honesto sobre as limitações. O TCP/IP foi projetado para confiabilidade e roteamento, não para segurança. A autenticação de origem, a integridade dos dados e a confidencialidade não fazem parte do protocolo original. Se você está transmitindo credenciais, dados sensíveis ou qualquer coisa que não deve ser lida por terceiros, precisa de uma camada extra como TLS. TCP puro envia tudo em texto claro. O TCP também não é ideal para comunicação em tempo real. A garantia de entrega e a reordenação de pacotes introduzem latência variável que torna o protocolo inadequado para vídeo conferência, jogos online e transmissão ao vivo. Nessas situações, UDP com protocolos de aplicação customizados oferece muito melhor performance, mesmo com perda ocasional de pacotes. Endereçamento IPv4 está praticamente esgotado globalmente. A migração para IPv6 é inevitável mas ainda incompleta. Muitos ambientes operam com dual-stack, o que adiciona complexidade de configuração e possibilidades de falha onde o sistema escolhe incorretamente entre IPv4 e IPv6. Teste sempre ambas as pilhas quando estiver configurando novos serviços.
Se o seu cenário exige comunicação lightweight com baixo overhead e você não precisa da Garantia de entrega, considere soluções como MQTT sobre TCP ou até mesmo WebSocket com fallback para UDP via WebRTC Data Channels. Para transferência de arquivos em larga escala entre data centers, o SCP e o rsync sobre SSH são mais apropriados do que tentar otimizar a camada de transporte manualmente.

Recursos para aprofundar
A documentação oficial do RFC 793 descreve a especificação completa do TCP. É densa mas direta. ParaIPv4 e IPv6, os RFCs 791 e 2460 respectivamente cobrem o protocolo de internet. O livro "TCP/IP Illustrated, Volume 1" de Kevin Stevens é referência clássica que combina teoria com exemplos práticos de implementação, algo raro em documentação técnica. Para diagnóstico no dia a dia, domine o tcpdump, o ss, o iproute2 e o ethtool. Esses quatro conjuntos de ferramentas cobrem 95% dos problemas que aparecem em ambientes de produção. Aprenda a ler a saída do ethtool -S para estatísticas de erro de interface, e use o ip -s link para verificar contadores de pacotes descartados ou com erro em tempo real. Em ambientes corporativos, manter um baseline de métricas de rede — latência entre pontos críticos, taxa de retransmissão TCP média, utilization das links — faz diferença enorme quando algo dá errado. Sem baseline, você não sabe se um problema é anormal ou apenas o comportamento esperado da sua infraestrutura.
Galeria
-
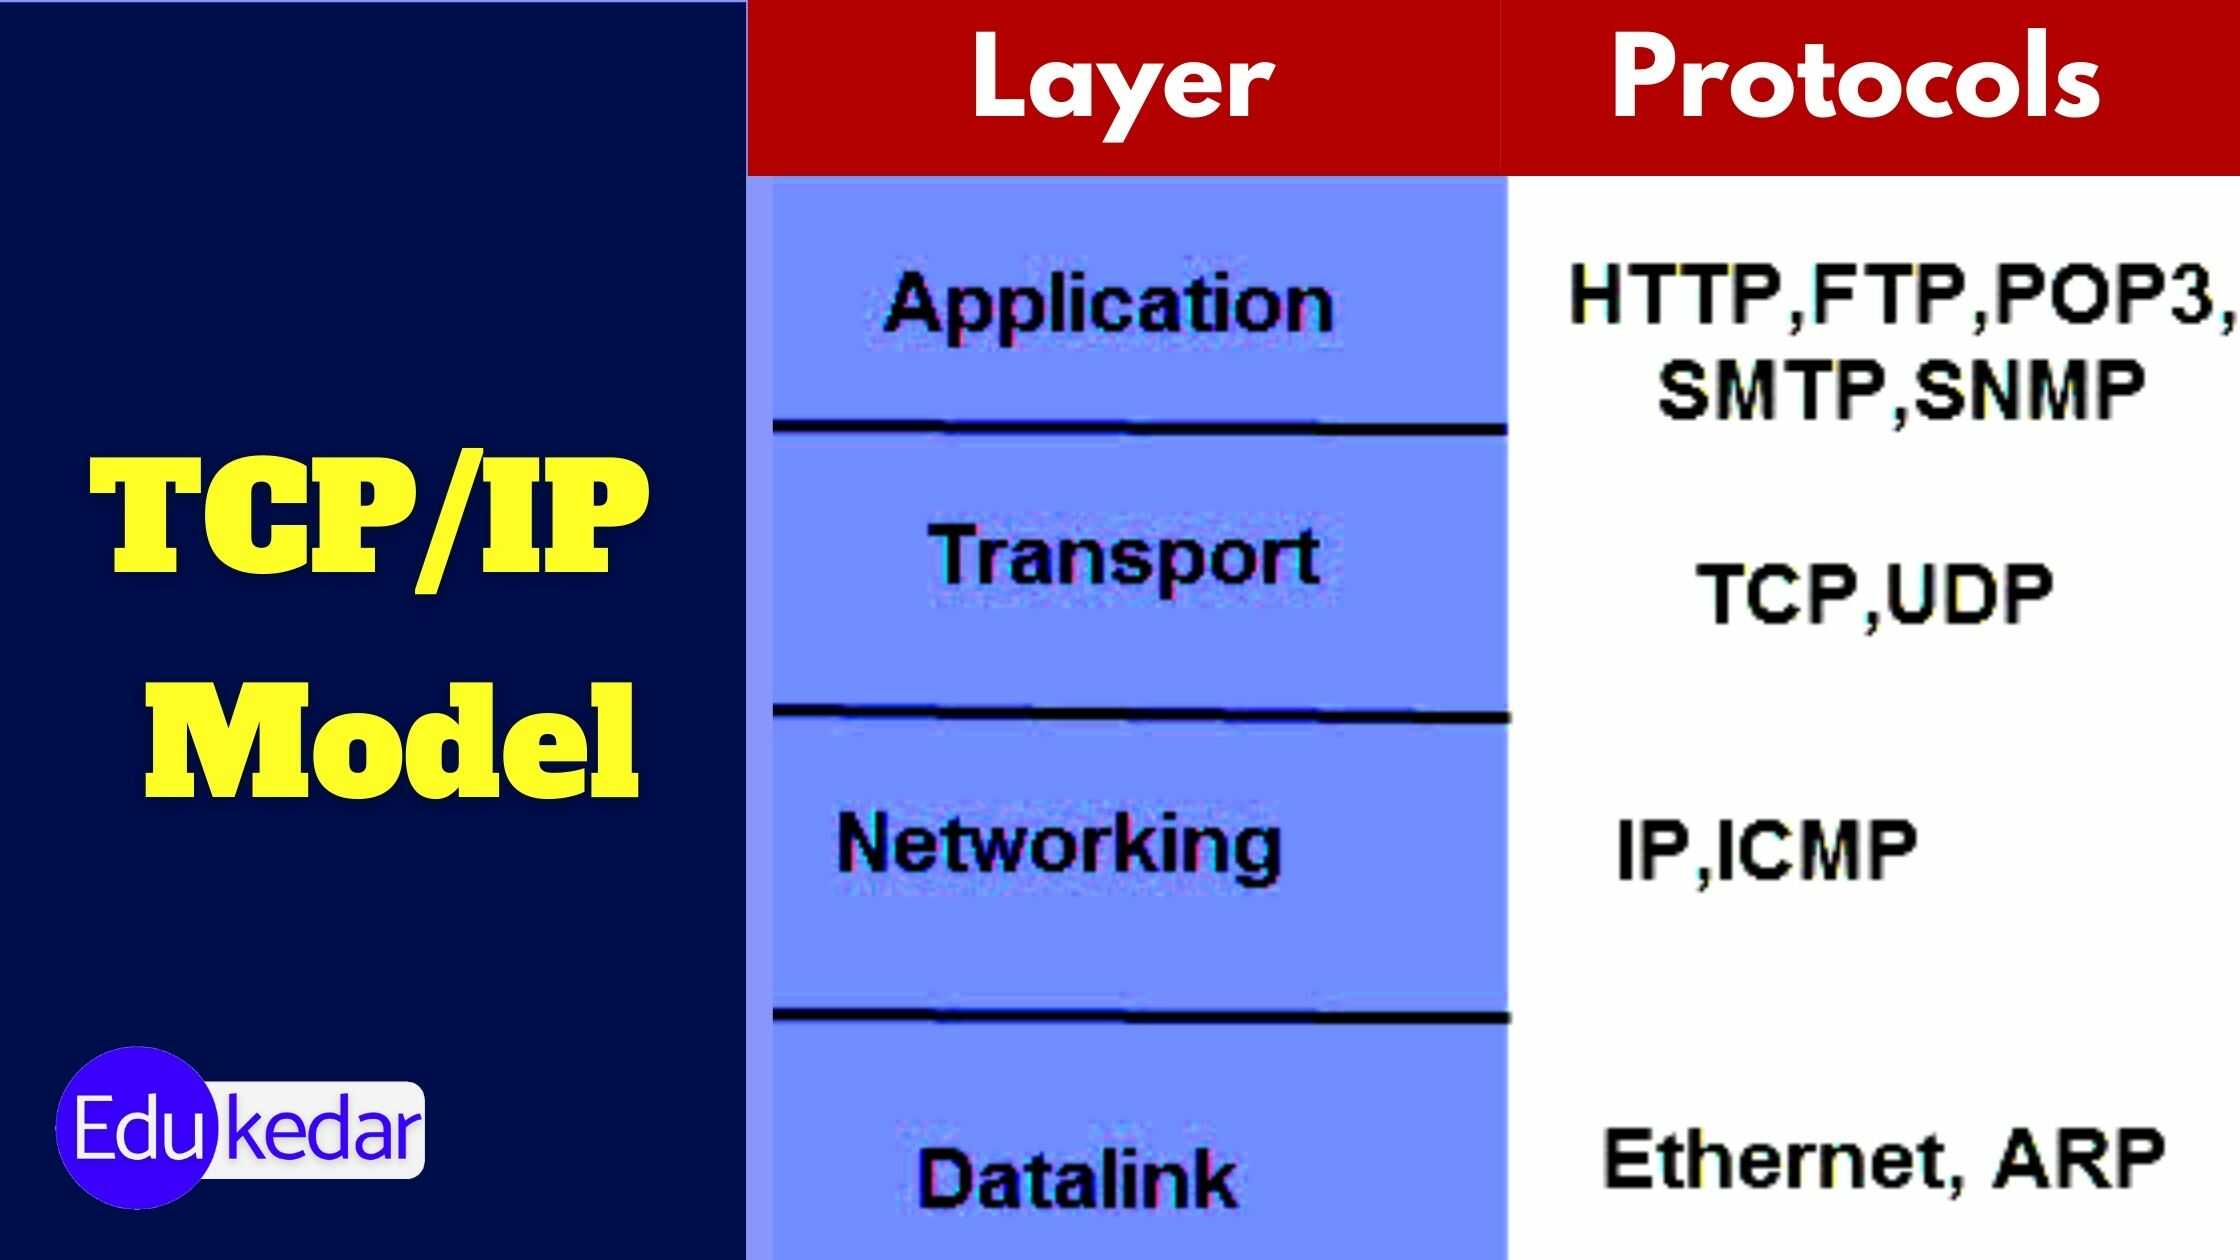
Ultimate Guide To Tcp/Ip Transmission Control Protocol – WPFQTM -

Ultimate Guide To Tcp/Ip Transmission Control Protocol – WPFQTM
