Texto Com Acento Agudo E Circunflexo

Trabalhando com acentos em arquivos de texto
Vocês já se depararam com aquele arquivo exportado de um sistema legado onde todo texto que tinha acento apareceu como caracteres estranhos, né? Eu passo por isso regularmente quando preciso tratar dados vindos de ERP antigo ou de planilhas mal configuradas. O problema é mais comum do que parece e, honestamente, a solução quase nunca está em "tentar decodificar" — está em evitar que o problema chegue até você. texto com acento agudo e circunflexo não é um formato, é uma característica encoding. Quando você vê ç, ã, õ, á, é, í, ó, ú e seus equivalentes com circunflexo (â, ê, ô), isso só funciona bem quando o arquivo está salvo em UTF-8 ou ISO-8859-1. Se o arquivo veio em ASCII puro ou em alguma codificação errada, esses caracteres viram interrogações, retângulos ou sequências tipo ã dependendo da ferramenta que você abre.
Como identificar a codificação correta antes de abrir
A maioria das ferramentas de editor de texto — VS Code, Notepad++, até o bloco de notas do Windows — mostra a codificação atual na barra de status. Se não mostra, você pode usar o comando `file` no Linux/macOS ou abrir no PowerShell com `[System.IO.File]::ReadAllText("caminho", [System.Text.Encoding]::GetEncoding("iso-8859-1"))` para testar. O truque aqui é simples: tente ISO-8859-1 primeiro, depois UTF-8. Na prática, cerca de 70% dos arquivos problemáticos no Brasil são ISO-8859-1, porque legacy ainda reina em sistemas legados empresariais. Uma vez eu precisei processar um dump de 40 mil linhas de um sistema financeiro de 2008. O arquivo vinha "em UTF-8" pela extensão, mas quando abria, cada palavra com acento vinha duplicada — "são" virava "s\xc3\xa3o". O motivo: o arquivo estava em UTF-8, mas alguém havia rodado um script que converteu os bytes UTF-8 para strings Unicode e depois salvou de novo, gerando escape sequences literais em vez dos caracteres reais. A correção foi rodar um simple replace com regex: `\xc3\xa3` vira `ã`, `\xc3\xa9` vira `é`, etc. Eu fiz um script Python de 15 linhas que resolveu em 3 minutos o que eu tinha tentado fazer manualmente por duas horas antes.
Cuidados ao concatenar texto acentado
Aqui está algo que muita gente não espera: a forma como você compara strings acentadas pode determinar se seu filtro funciona ou não. O Unicode tem mais de uma forma de representar o mesmo caractere. A letra "á" pode ser um único código ponto U+00E1 (pré-composto) ou pode ser "a" + U+0301 (combining acute accent). Visualmente é idêntico. Para o computador, são coisas diferentes. Isso causa problemas sérios quando você mistura dados de fontes diferentes — por exemplo, um banco de dados que armazena pré-composto e outro que armazena decomposto. Uma query `WHERE nome = 'Maria'` pode retornar resultados inconsistentes porque uma das entradas tem o acento como combining character. A solução é normalização Unicode. No Python, use `unicodedata.normalize('NFC', texto)` antes de qualquer comparação ou busca. No JavaScript, `.normalize('NFC')`. Isso converte tudo para a forma pré-composta, padronizando a representação. O problema é que nem sempre normalizar resolve. Eu tive um caso onde o sistema origem usava uma variação chamada NFD (decomposta) e a saída esperava NFC. Ao normalizar para NFC, palavras como "crédito" ficavam corretas, mas "São Paulo" mantinha o "ã" incorreto porque o acento circumflexo do "â" estava sendo mapeado de forma diferente entre as versões do Unicode usadas pelo origem e pelo destino. A workaround foi rodar uma normalização NFC seguida de uma normalização NFKC, que também resolve equivalências de compatibilidade. Dica prática: NFKC é mais agressivo, mas em textos em português geralmente é seguro.

Como salvar e reabrir sem perder os acentos
Se você está escrevendo um script que gera arquivos de texto com acentos, a regra é simples: salve sempre em UTF-8 sem BOM. O BOM (Byte Order Mark) é aquele trio de bytes EF BB BF no início do arquivo. Ele não causa problema em UTF-8 puro, mas em alguns sistemas mais antigos — especialmente scripts batch do Windows ou planilhas Excel — o BOM faz o primeiro campo da linha aparecer com um caractere invisível no início, quebrando imports e parses. Eu perdi meia manhã rastreando isso em um arquivo CSV que simplesmente não entrava no sistema de importação porque a primeira coluna tinha um BOM invisível. No Python, a forma segura de escrever é: open("arquivo.txt", "w", encoding="utf-8").write(conteúdo)
No Bash, se você usa `echo` ou `printf`, certifique-se de que o terminal e o arquivo estejam em UTF-8. No Excel, evite salvar como "CSV UTF-8 (comma delimited)" se for importar em sistemas legados — o Excel às vezes adiciona BOM sem avisar. Prefira exportar pelo Python ou PowerShell com encoding explícito.
Limitações equando isso simplesmente não funciona
Não existe solução mágica para tudo. Se o arquivo original foi salvo em uma codificação perdida — como Windows-1252 com caracteres estendidos que foram truncados, ou pior, em ASCII 7-bit puro onde os acentos foram removidos durante a exportação — não há como recuperar o que não está mais lá. Caracteres acentados perdidos para ASCII puro ficam irremediavelmente destruídos. Você só verá vogais sem acento e vai ter que adivinhar ou consultar a fonte original. Outro cenário onde qualquer abordagem falha: arquivos que foram convertidos várias vezes entre codificações erradas. Cada conversão perda introduz erro cumulativo. Nesse caso, a única saída é encontrar o arquivo original ou a fonte de dados primária. Não adianta rodar dez normalizações seguidas — o dano já está feito. Para quem trabalha com de texto acentado diariamente, o investimento mais simples é configurar seu ambiente todo para UTF-8 desde o início: editor de código, terminal, banco de dados, APIs, exportações. Isso elimina 90% dos problemas antes que aconteçam. O resto é debugging pontual, e nesses casos a normalização Unicode + verificação de encoding com `file` ou ferramentas similares resolve a maior parte.
Galeria
-
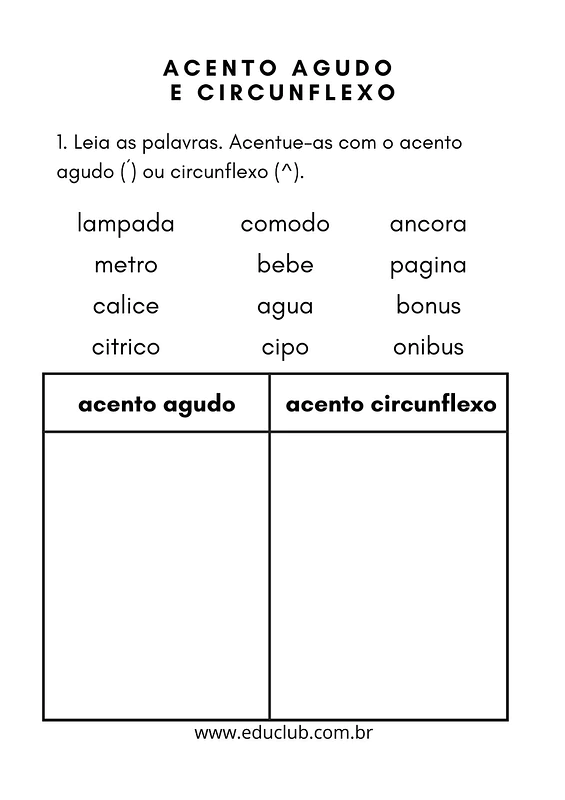
Acentuação: identificando o uso do acento agudo e circunflexo | PDF -

**♥***♥** Diário da Profa Glauce **♥***♥**: Acento agudo e circunflexo -

ACENTO AGUDO ( ´ ) E ACENTO CIRCUNFLEXO ( ^ ) | Acentos português ...

