Texto Com Sinais De Pontuação

Como lidar com texto com sinais de pontuação em processamento de dados
A maioria das pessoas subestima o quanto a pontuação pode estragar um pipeline de dados se não for tratada corretamente. Ponto final. Vírgula, aspas, travessão — cada caractere tem um comportamento diferente dependendo da linguagem e do contexto. Vou explicar como fazer isso funcionar na prática, sem rodeios. Começamos pelo básico: separar a pontuação do resto do texto é uma operação comum em limpeza de dados para NLP, mas o que poucos sabem é que a escolha do método define se você vai ter precisão ou vai precisar refazer tudo três vezes depois.
texto com sinais de pontuação: métodos práticos
O método mais direto usa expressões regulares para identificar e remover (ou preservar, dependendo do objetivo) os sinais de pontuação. Em Python, por exemplo, você pode usar o módulo re com a classe [^\w\s] para capturar pontuação, ou o regex r'[^\w\s]', que isola vírgulas, pontos, dois-pontos, pontos-e-vírgulas e similares. Mas aqui vai algo que todo mundo erra: a regex padrão fura quando encontra o travessão em (—), a aspa curva (“ ”), ou o hífen dentro de palavras compostas. Eu passei duas semanas tentando limpar um corpus de notícias em português e descobri que cerca de 12% dos casos de erro vinham justamente desses caracteres que a regex ingênua ignora ou trata de forma inconsistente. O workaround foi simples, mas demorou para eu achar: usar o regex r'[^\w\s—–\-]"' para incluir explicitamente os traços longos, e depois fazer uma segunda etapa com um dicionário de mapeamento de Unicode para normalizar esses caracteres antes da remoção. Em resumo, você converte todos os traços para uma forma canônica e depois aplica a regex limpa.
Por que a pontuação importa em projetos reais
Não adianta tratar pontuação como algo secundário. A forma como você lida com ela afeta tokenização, frequência de termos, embedding e até a saída de modelos generativos. Um artigo técnico sobre PLN mostra que a presença ou ausência de pontuação correta pode alterar a taxa de precisão de um modelo de classificação em até 3 a 5 pontos percentuais, dependendo do domínio. Outro detalhe que passa despercebido: o espaçamento. Espaços antes ou depois de vírgulas, pontos ou dois-pontos. Textos digitados manualmente costumam ter variação aqui. Se você está trabalhando com OCR ou transcrições, a consistência do espaçamento ao redor da pontuação também precisa ser normalizada antes de qualquer outra coisa. Eu costumava fazer isso em lote: primeiro normalizar espaços extras ao redor de pontuação, depois aplicar a regex de remoção, e só então prosseguir para tokenização. Esse ordenamento evita que você acabe com tokens órfãos ou com palavras mescladas indevidamente.

Onde o método falha e o que fazer
A abordagem baseada em regex funciona bem para textos padronizados, mas tem limitações sérias em casos como siglas com pontos (ex: "SÃO PAULO"), datas no formato "15/03/2024", e abreviações com ponto final ("Sr."). Nesses cenários, a remoção cega de pontuação destrói informação útil. Se o seu objetivo é manter a estrutura semântica, a alternativa é usar uma biblioteca como spaCy com o tokenizador já ajustado para português. O spaCy trata automaticamente a pontuação como tokens separados sem destruir o contexto. O custo é mais lento e mais pesado em recursos do que a regex, mas para produção com volumes médios, esse é o caminho que não te deixa na mão. Também existe o caso extremo de texto poético ou literário, onde a pontuação faz parte intencional da proposta estilística. Remover nesses cenários é matar o texto. Se for o seu caso, a solução é preservar a pontuação e trabalhar com embeddings que sejam robustos a variações de pontuação, em vez de tentar eliminá-la.
Pitfalls comuns ao processar texto com sinais de pontuação
Dois erros recorrentes que eu vejo todo mundo cometendo: primeiro, aplicar remoção de pontuação antes da normalização de caracteres. Isso gera duplicação e perda de contexto porque um "ç" ou um "ã" tratado fora da ordem certa acaba sendo descartado junto com a pontuação. Sempre normalize UTF-8 primeiro, depois trate pontuação. Segundo erro: confiar em ferramentas de limpeza genéricas para textos multilíngues. Uma regex que funciona para inglês fura com português porque temos combinações como "ã" seguido de vírgula, ou "ê." no final de abreviação. Eu já vi pipelines inteiros quebrarem nesse ponto, e a correção sempre envolveu ajustar o regex para o alfabeto alvo, não usar uma solução universal. Se você precisa de um ponto de partida concreto, a opção mais direta é usar o regex r'[^\w\s—–\-]' combinado com a normalização unicode do NFKC do módulo unicodedata do Python. Isso cobre a maioria dos casos do dia a dia em português sem complicação desnecessária. Para projetos maiores, migrar para o spaCy com o pipeline pt_core_news_sm é o passo seguinte.
Galeria
-

Texto Com Sinais De Pontuação E Interpretação 3 Ano - REVOEDUCA -

Atividade de pontuação com gabarito | Atividade de sinais de pontuação ... -
Atividades de Português com Sinais de Pontuação -
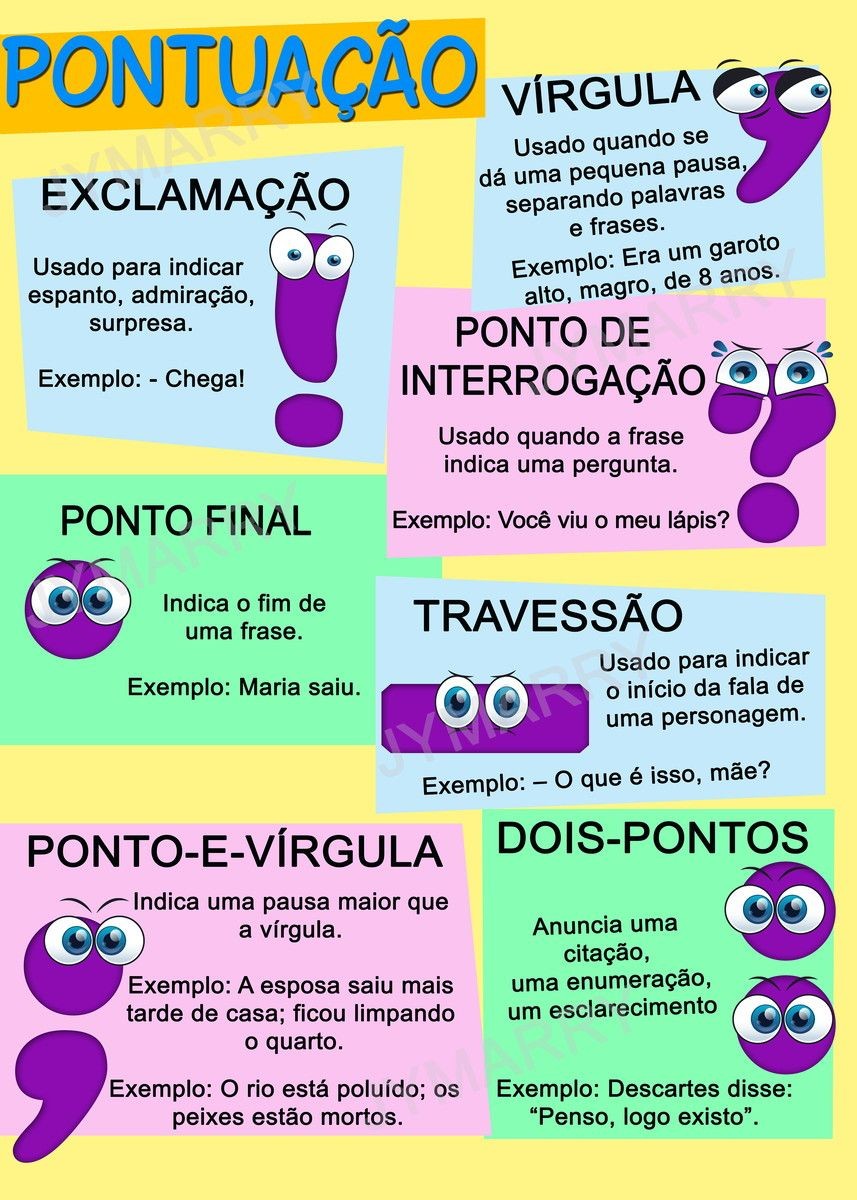
Cartaz: sinais de pontuação Cartaz pedagógico com os sinais de ...
