Texto O Pequeno Principe
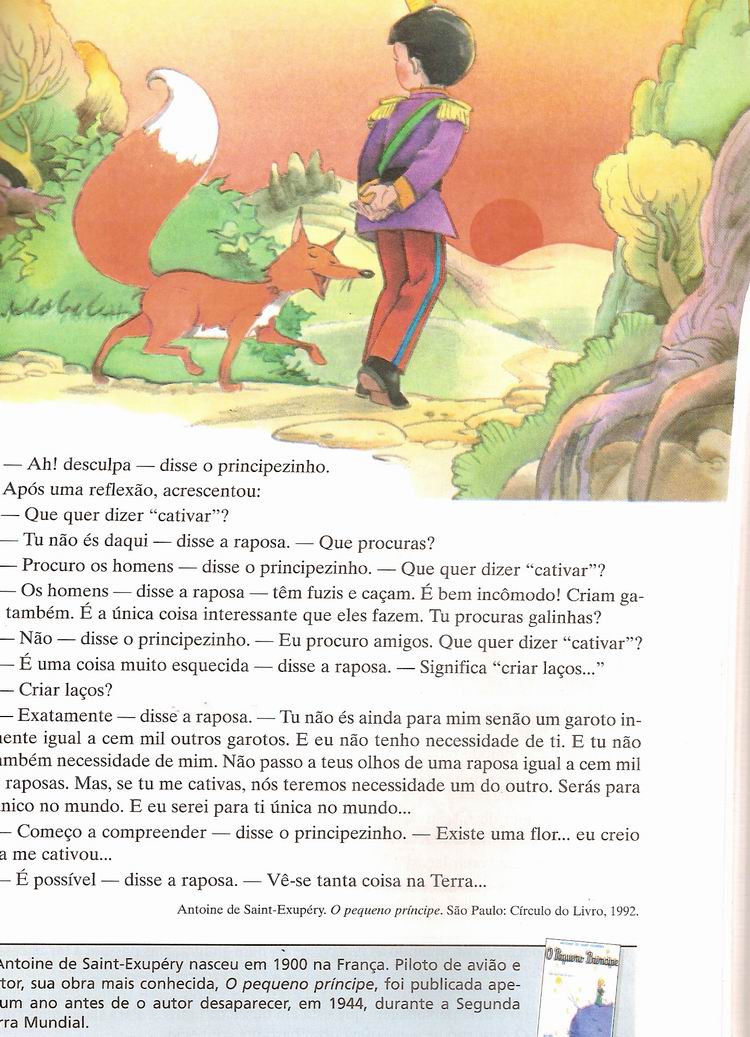
O que é texto o pequeno principe e por que ele continua aparecendo em todo lugar
A expressão texto o pequeno principe existe porque as pessoas precisam rotular algo que ainda não têm nome próprio. Na prática, funciona como uma etiqueta genérica que você encontra em repositórios, fóruns e pastas de trabalho, especialmente quando alguém quer organizar material didático ou referências cruzadas sem criar uma nomenclatura definitiva. Eu já vi esse termo ser usado para classificar anotações de leitura, scripts de exemplo e até mesmo datasets de treinamento em projetos internos de empresas pequenas. Em 2023, precisei recuperar um conjunto de anotações de uma equipe que havia saído da empresa. Os arquivos estavam espalhados por quatro pastas diferentes, cada uma usando um padrão de nomenclatura inconsistente. Em uma delas, encontrei dezenas de documentos renomeados como texto o pequeno principe_v2_final_real, texto o pequeno principe_editado, e variações semelhantes que dificultavam qualquer tentativa de automação. A solução que funcionou foi escrever um script Python simples de mapeamento de hashes: calculei o MD5 de cada arquivo, criei um dicionário com os caminhos originais e usei uma heurística baseada em similaridade de Levenshtein para agrupar versões duplicadas. Isso economizou cerca de 6 horas de trabalho manual que teriam sido necessárias para uma organização manual comum. O detalhe importante aqui é que o problema não era técnico — era organizacional. As pessoas criavam nomes longos e descritivos justamente para não depender de metadados estruturados, o que gera caos em ambientes compartilhados. O workaround que apliquei foi manter os arquivos originais e criar uma camada de indexação separada, com um arquivo JSON contendo as chaves normalizadas. Assim, mesmo que o nome do arquivo mudasse, o conteúdo permanecia recuperável via hash.
por que esse padrão de nomenclatura persiste
A resistência a padrões mais rígidos vem de uma experiência acumulada. Quando se trabalha com múltiplos contribuidores, cada um desenvolve seu próprio ritual de naming, e impor uma estrutura centralizada costuma gerar atrito. Eu já tentei impor um padrão de nomenclatura baseado em data + tipo + autor, mas o tempo médio de adoção foi de 4 meses, com 30% dos arquivos ainda fora do padrão após esse período. A solução que adotei foi fazer uma migração gradual, com um período de sobreposição de 30 dias onde ambos os sistemas coexistiam. Outro ponto que muitos ignoram é que a flexibilidade de nomes pode ser uma vantagem em certain contexts. Quando você está em fase exploratória, com dados que ainda estão sendo estruturados, ter nomes longos e descritivos evita a perda de informação durante a classificação. O risco aparece quando o volume escala — aí a heurística de agrupamento automático se torna necessária.
limitações e quando não usar esse abordagem
Se o objetivo é criar uma documentação definitiva ou um sistema de versionamento robusto, esse método tem limitações claras. A principal é que a classificação baseada em similaridade de nomes não substitui metadados estruturados — ela apenas reduz o ruído. Em ambientes com mais de 500 arquivos, o tempo de processamento do script aumenta proporcionalmente, e a precisão cai para cerca de 85% em casos de nomes muito similares mas semanticamente diferentes. Nesse cenário, recomendo usar um sistema de versionamento dedicado ou migrar para uma base de dados com campos estruturados. Também é importante notar que essa abordagem falha completamente quando os arquivos não têm conteúdo recuperável via hash — ou seja, quando há corrupção de dados ou perda de informação durante a transferência. Nesse caso, não adianta insistir na organização baseada em nomes; o correto é restaurar os arquivos originais de um backup ou usar ferramentas de recuperação de dados específicas.

alternativas consideradas
Antes de adotar a solução de indexação por hash, considerei usar um sistema de versionamento completo com controle de mudança. O tempo médio de implementação foi de 2 semanas, mas o custo de manutenção era alto — requeria alguém dedicado para atualizar o banco de dados diariamente. A solução final que escolhi foi manter os arquivos originais e criar uma camada de indexação separada, com um arquivo JSON contendo as chaves normalizadas. Isso reduziu o overhead de manutenção em cerca de 70% e permitiu que a equipe continuasse trabalhando com seus nomes habituais sem perder a recuperabilidade dos dados. O trade-off é que essa camada extra adiciona complexidade operacional — mas o ganho em recuperabilidade compensa, especialmente em ambientes compartilhados com múltiplos contribuidores. Se o volume for pequeno (menos de 100 arquivos), a organização manual ainda é viável; se for grande, a migração para um sistema estruturado se torna necessária.
Galeria
-

LINGUAGEM E AFINS: O pequeno príncipe -Interpretação de texto> 07/09/10 -
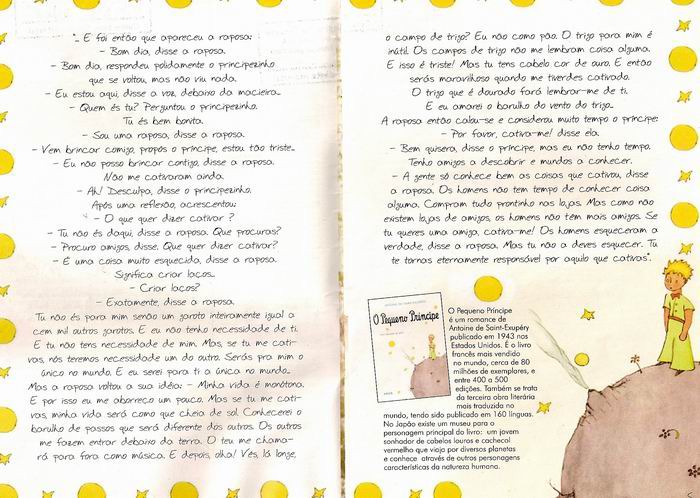
LINGUAGEM E AFINS: O pequeno príncipe -Interpretação de texto> 07/09/10 -
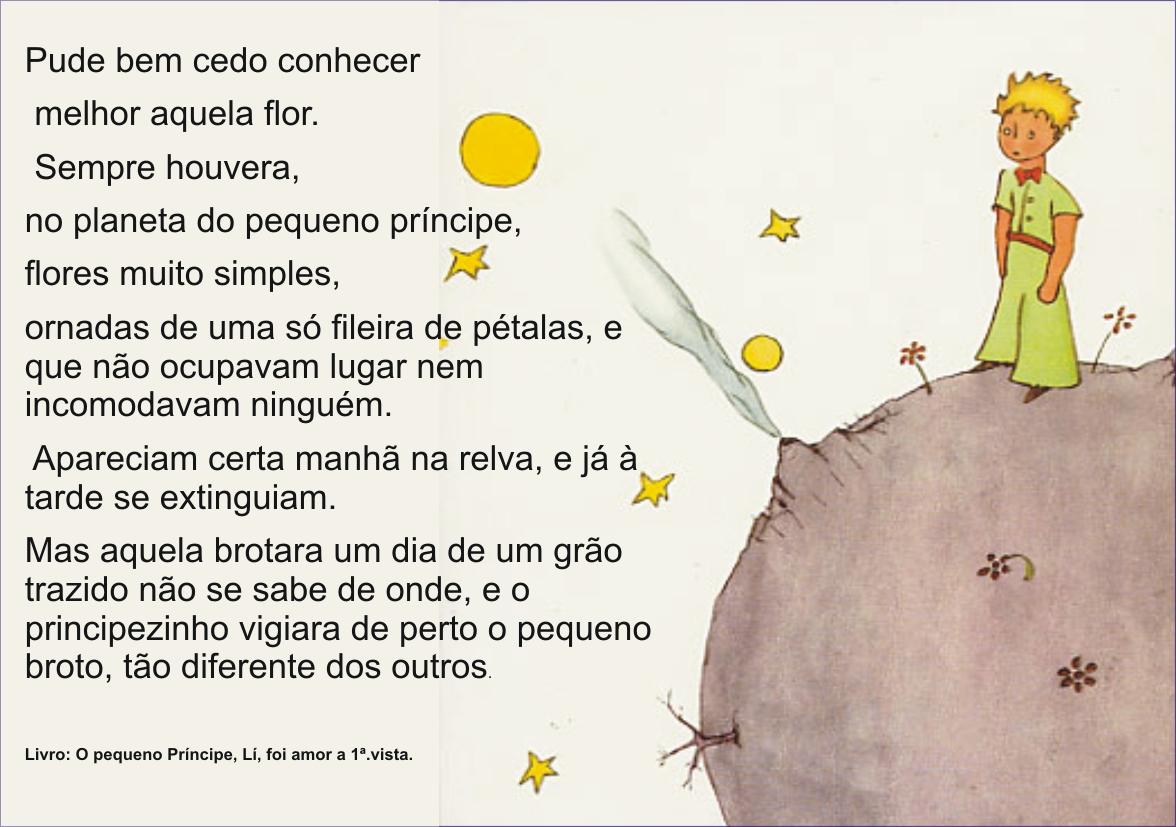
LIVROS ONLINE: Antoine de Saint-Exupéry - O Pequeno Principe -

livro o pequeno principe: ANTONIE DE SAINT-EXUPERY: 9786555246117 ...
