Tipos De Variaveis Na Estatistica

Como identificar tipos de variáveis na estatística na prática
Na maioria dos projetos que eu vejo, as pessoas começam com uma planilha e tentam aplicar testes estatísticos sem parar para classificar as variáveis primeiro. Isso geralmente funciona mal. A classificação errada leva a testes inadequados, gráficos confusos e conclusões que não sustentam nada. Os tipos de variáveis na estatistica se dividem em categorias que parecem simples à primeira vista, mas que escondem armadilhas sérias. Variáveis quantitativas e qualitativas são o ponto de partida, mas é dentro dessas duas grandes famílias que a coisa fica complicada de verdade.
O que todo mundo deveria saber sobre tipos de variaveis na estatistica
Variáveis qualitativas, também chamadas de categóricas, representam categorias sem ordem inerente. Sexo, cor dos olhos, tipo sanguíneo. Variáveis quantitativas medem algo numérico. Idade, peso, renda. Essa divisão básica é o que você encontra em qualquer livro, mas raramente é onde os problemas começam. O primeiro nível de complexidade aparece quando você olha para variáveis ordinais. Satisf do cliente, por exemplo. Muito satisfeito, satisfeito, neutro, insatisfeito, muito insatisfeito. Tem ordem, mas a distância entre cada patamar não é necessariamente igual. Tratar essa variável como quantitativa contínua em uma análise de regressão linear comum é um erro que eu vejo quase todo dia em revisões de artigos. Outra classificação importante que muita gente pula é a diferença entre variáveis discretas e contínuas dentro do universo quantitativo. Quantidade de filhos é discreta. Você não pode ter 2,5 filhos no sentido estrito da variável. Já tempo até uma falha é contínua, mesmo que sua medição seja arredondada para segundos ou milissegundos. A distinção importa porque alguns modelos assumem continuidade e outros assumem discretude.
Eu tive um caso específico recentemente com dados de sobrevivência de pacientes em um hospital. A variável resultado estava codificada como 0 para óbito e 1 para alta. Parecia binária e funcional. O problema era que tínhamos perdas de seguimento significativas e elas estavam sendo tratadas como Missing No como valores ausentes normais. Eu precisei recodificar criando uma terceira categoria para censura e depois reestruturar toda a modelagem para um modelo de risco proporcionais de Cox em vez de uma regressão logística simples. Isso mudou completamente as estimativas de hazard ratio. Variáveis dummy surgem quando você precisa transformar categóricas nominais em algo que um modelo numérico consiga processar. Cor da equipe, região geográfica, modalidade de ensino. Cada categoria vira uma coluna com zero e um. A pegadinha aqui é a armadilha da variável ausente: se você tem uma variável com cinco categorias e cria cinco dummies, o modelo entra em multicolinearidade perfeita. Sempre remova uma categoria de referência. Variáveis latentes são outro animal. Ninguém mede satisfação com a vida diretamente. Você faz perguntas proxy e usa fatoração ou modelos de equações estruturais para construir o construto. Essas variáveis nunca aparecem brutamente nos seus dados. Elas são derivadas.

Confundir variável de controle com variável de mediação é um erro clássico. Você ajusta por uma variável de confusão para isolar o efeito causal, mas se essa mesma variável estiver no caminho causal entre exposição e desfecho, você está controlando demais e eliminando parte do efeito que pretende medir. Esse é um dos pontos mais sutis e importantes. Para quem está começando, a regra prática é: antes de qualquer teste, monte uma tabela simples listando todas as variáveis do seu dataset e classifique cada uma. Escreva o tipo, a unidade de medida quando aplicável, e se há categorias ordinais. Leva talvez dez minutos num estudo pequeno e vinte em um médio. Esse tempo economiza horas de retrabalho. Há situações onde a classificação não é óbvia. Renda mensal pode ser quant continua, mas muitas vezes é mais robusto tratá-la como ordinal em categorias porque a distribuição é altamente enviesada. Escalas Likert de cinco pontos são tratadas como ordinais por puristas, mas na prática muitos pesquisadores usam como contínuas em análises de variância com resultados razoáveis, especialmente com tamanhos amostrais acima de cem por grupo.
O maior problema que eu encontro hoje em dia são datasets importados de plataformas digitais onde variáveis que parecem quantitativas na verdade são contagens de eventos com excesso de zeros ou truncamento. Clique, visualização, tempo na página. Tratar isso como normal quando a distribuição é claramente não-normal gera inferências distorcidas. Modelos de Poisson ou negativos binomiais costumam ser a saída adequada. Se você precisa de uma referência rápida, a classificação padrão de Stevens com escala nominal, ordinal, intervalo e razão ainda é útil como ponto de partida, mas o mundo atual exige mais cuidado. Variáveis mistas, sobrevivência, dados longitudinais e medidas repetidas introduzem camadas adicionais que a taxonomia clássica não cobre de forma prática. O que faz diferença no dia a dia é a disciplina de pensar nas variáveis antes de abrir o software. R, Python, SPSS, Stata. Qualquer que seja a ferramenta, o raciocínio sobre tipos de variáveis na estatistica é independente. Definir isso corretamente na fase de desenho do estudo ou na limpeza dos dados reduz drasticamente o risco de cometer erros metodológicos que comprometem toda a análise.
Galeria
-

Mapa mental - tipos de variáveis na probabilidade - Probabilidade e ... -

Arte, Cidadania, Comunicação: Estatística - Tipos de variáveis -
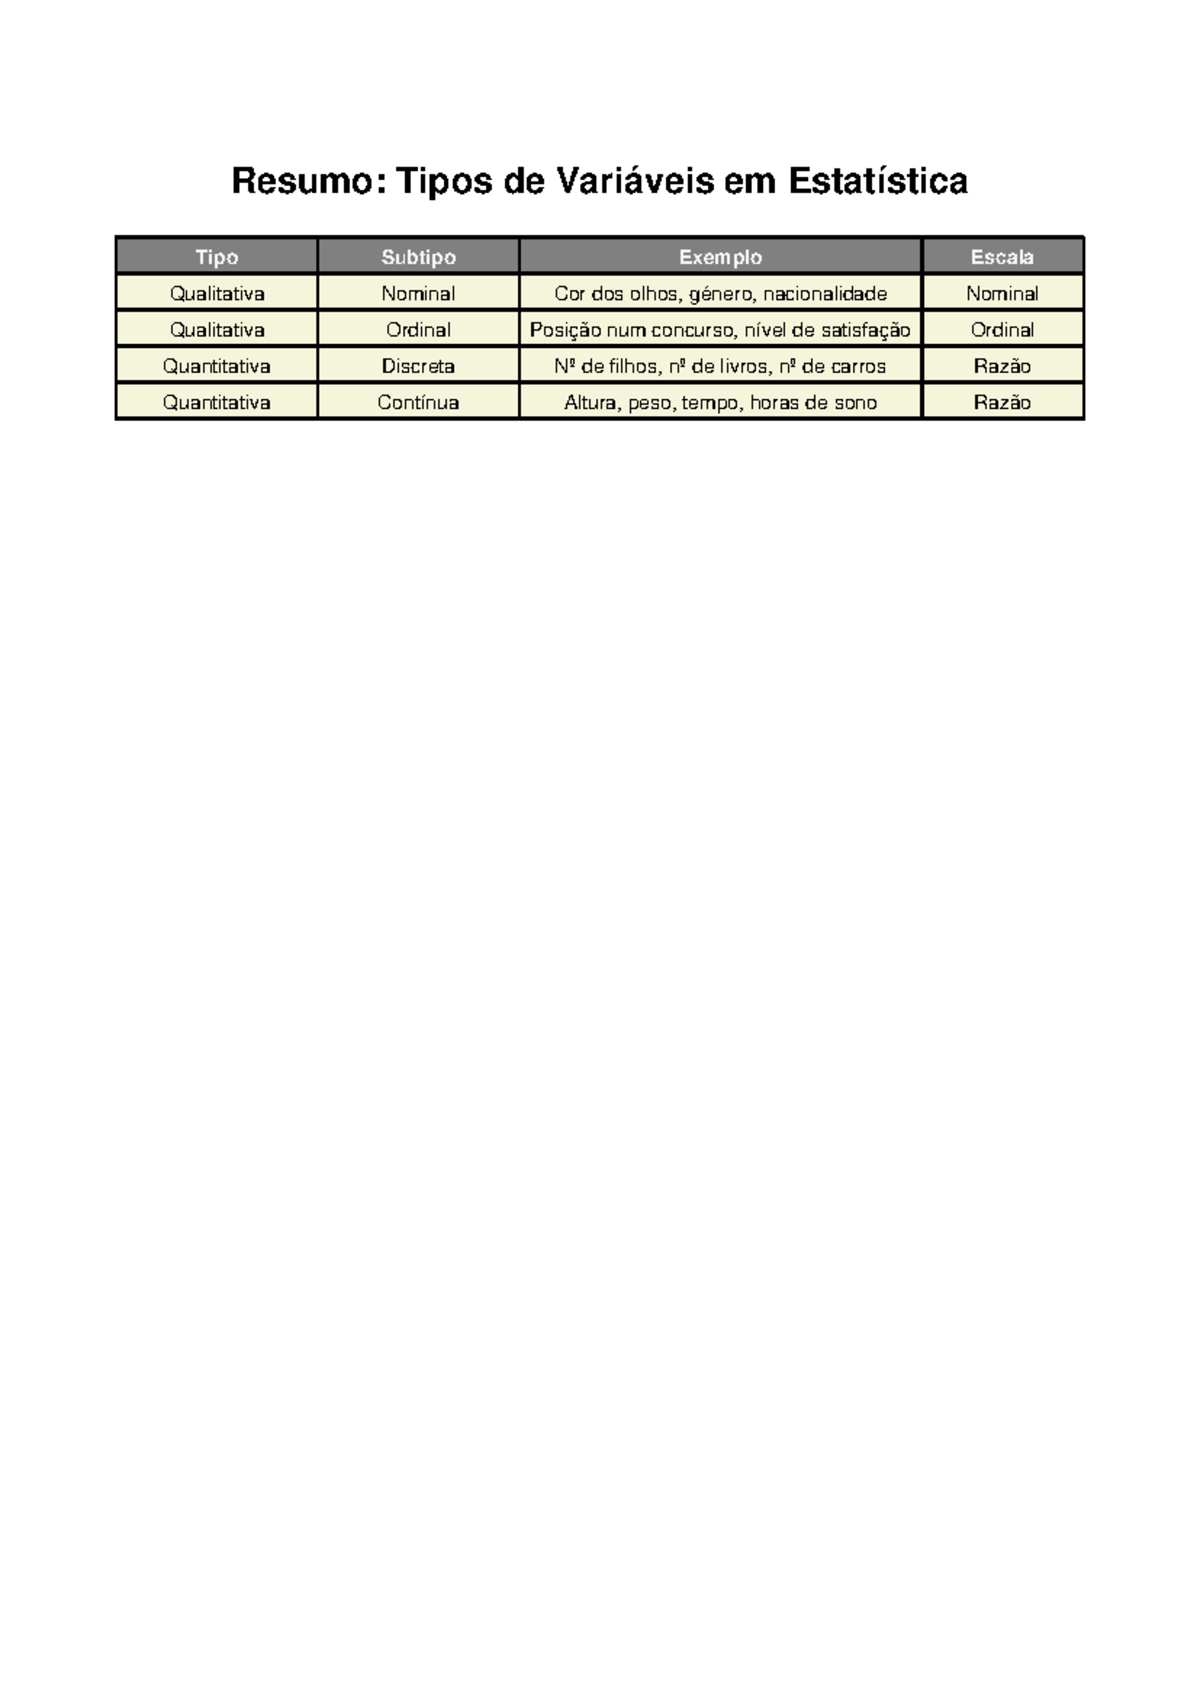
Tipos variaveis estatistica - Análise de Dados - Resumo: Tipos de ... -
A.1 Tipos de Variáveis | PDF | Variável categórica | Modo (Estatística)

