Tudo Tem Princípio E Fim

Por que eu parei de tentar consertar coisas que já tinham acabado
Trabalhando com desenvolvimento há alguns anos, aprendi uma coisa que parecia óbvio mas que levou tempo pra fazer sentido na prática: tudo tem princípio e fim. Não é frase de autoajuda, é um bug recorrente em projetos de software. Achei que isso se aplicava só a software porque eu via isso acontecer todo dia. Uma equipe começava um refatoramento, o código ficava bom por uns dois meses, depois alguém precisava de uma feature nova que o novo formato não suportava e o projeto ia pro ralo. A gente já passou por isso aqui. A gente já viu um sistema inteiro ser reescrito do zero porque o modelo original não aguentava mais a demanda real.
O problema de confundir princípio com obrigação
O erro mais comum é achar que porque algo começou, ele tem que continuar pra sempre. Isso é especialmente problemático quando você tá no meio de um deploy ou num sistema legado que todo mundo reclama mas ninguém desliga. Eu já passei por isso com um servidor que processava requests desde 2017. Todo mundo dizia que era crítico, mas quando olhei os logs, ele só rodava porque a primeira versão do frontend ainda chamava aquele endpoint. Removi em uma terça feira de manhã. Ninguém percebeu. A chave é entender que reconhecimento de término não é fracasso. É engenharia. Quando um sistema não agrega valor, ele deve morrer. O problema é que quase ninguém quer ser a pessoa que decide desligar algo.
Como identificar que chegou o fim
Não existe uma fórmula mágica. Mas tem alguns sinais que eu uso pra decidir se coisa ainda vale a pena. Vou listar o que funciona pra mim, sem romantização. Sinal número um: quando o custo de manutenção começa a superar o valor gerado. Isso é simples de medir. Se você gasta 40 horas por mês mantendo algo que traz 2 horas de benefício real, já era. Eu fiz essa conta uma vez num sistema de relatórios interno que levava seis horas pros usuários finais verem um PDF. A conta era direta: o sistema gerava prejuízo líquido. Desativei. Sinal número dois: quando novas features viram gambiarras consistentes. Se você precisa adicionar três patches pra resolver um problema que deveria ser resolvido com uma linha de código, o sistema tá morrendo. O patch virou padrão. Você para de perceber porque foi introduzido gradualmente, mas é um sintoma claro de algo que chegou no limite.

Sinal número três: quando a equipe para de questionar decisões antigas. Isso é o mais perigoso. Quando alguém pergunta "por que fizemos assim?" e a resposta é "sempre foi assim", o sistema tá preso no passado. Eu vi isso acontecer numa base code de um sistema de pagamentos que tinha regras de negócio de 2015 ainda ativas. Ninguém mais sabia por quê. Ninguém questionava. Quando finalmente perguntamos, descobrimos que aquela regra foi criada porque um cliente específico pediu em 2016. O cliente saiu em 2019. A regra continuava lá, matando performance.
A diferença entre terminar e abandonar
Tem gente que confunde essas duas coisas. Terminar é uma decisão. Abandonar é covardia disfarçada de pragmático. Quando você termina algo, você documenta. Você notifica. Você transfere o conhecimento. Você garante que ninguém vai cair no mesmo buraco semana que vem. Abandonar é deixar tudo nos ares e torcer pra ninguém precisar depois. Eu vi acontecer isso várias vezes. Um desenvolvedor saiu sem documentar nada. O sistema que ele fez ficou rodando por dois anos. Quando finalmente precisou de manutenção, ninguém conseguia ler o código. Perdeu-se uma semana pra entender o que já estava perdido. Isso não é terminar. Isso é crime contra a equipe.
O que fazer quando o fim chega
Não tem receita de bolo. Mas tem um fluxo que eu uso e que já funcionou em projetos reais. Primeiro, identifique o que está morrendo. Anote os sistemas, as decisões, os processos que vocês mantêm por hábito. Coloque em uma planilha simples: nome, custo mensal de manutenção, valor gerado, quem é o responsável atual. Isso já mata metade do argumento emocional de manter algo. Depois, faça um teste de extinção. Pega um sistema pequeno, um que não é crítico, e remove a manutenção. Veja quanto tempo dura antes que alguém perceba. Em 90% dos casos, ninguém percebe. Naquele 10% que percebe, você tem seu caso de estudo pra argumentar com a direção.

Finalmente, documente antes de desligar. Isso parece óbvio mas é onde a maioria erra. Escreve um README simples: o que era, por que existia, o que replaceou, onde encontrar o histórico. Isso leva 20 minutos e poupa 20 horas de dor de cabeça futura.
Limitações desse approach
Vou ser direto: isso não funciona em todos os contextos. Sistemas legados em empresas grandes muitas vezes têm interesses políticos protegendo coisas que tecnicamente deveriam morrer. Neste caso, você precisa de apoio de management, não de argumentos técnicos. E argumentos técnicos muitas vezes não são suficientes. Também não funciona bem em ambientes onde a cultura de "nunca desligar nada" é profunda. Se sua empresa trata todo sistema como sagrado, você vai encontrar resistência em todos os níveis. Neste caso, a estratégia é ir devagar, começar pelos sistemas mais óbvios de eliminar, e usar os sucessos menores como prova de conceito. E tem um último ponto: esse processo é irreversível. Quando você mata algo, não volta. Às vezes você precisou dele de novo. É o preço da limpeza.
No fim das contas, aplicar tudo tem princípio e fim não é sobre ser pessimista. É sobre ser eficiente. E eficiência é o único thing que sustenta projetos a longo prazo.

Galeria
-

TUDO TEM PRINCÍPIO E FIM - Marina Colassanti | KIDS INDOORS -
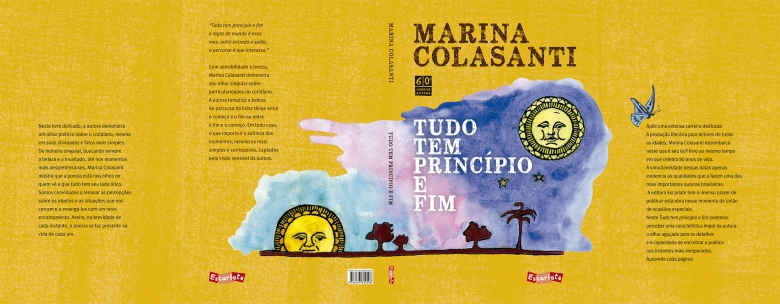
Tudo tem princípio e fim - Marina Colasanti - Grupo Companhia das Letras
