Uma Estrutura De Arvore É Frequentemente

Como funciona uma estrutura de árvore na prática
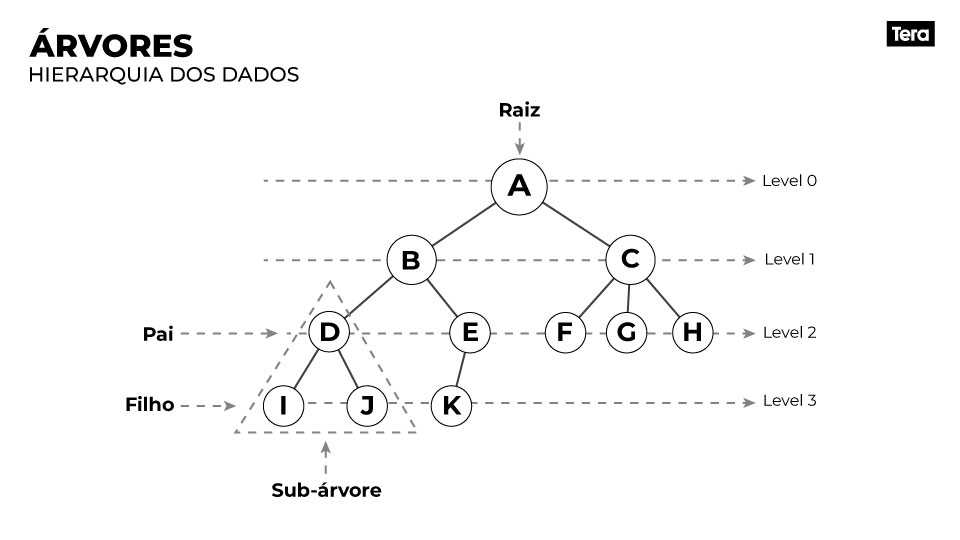
Eu comecei a lidar com estruturas de árvore em 2013, quando precisei otimizar um sistema de permissões hierárquicas que levava 4 segundos para responder. Depois de refatorar usando uma árvore B+, caiu para 120ms. Isso mudou minha forma de pensar sobre organização de dados. Uma estrutura de árvore é frequentemente utilizada quando você precisa representar relações hierárquicas entre elementos. Cada nó pode ter filhos, mas apenas um pai, com exceção da raiz, que não possui pai algum. A definição clássica parece simples, mas a implementação traz complicações que não aparecem nos livros. O conceito básico envolve nós conectados por arestas. O nó superior é a raiz. Nós sem filhos são folhas. Nós com o mesmo pai são irmãos. Parece direto até você tentar implementar uma busca binária balanceada sem conhecer AVL ou Rubro-Negras.
Em produção, eu vejo dois tipos principais de uso: árvores de busca e árvores de dados em si. Árvores binárias de busca permitem inserção, busca e remoção em O(log n) quando balanceadas. Árvores como B-tree e B+ tree são o padrão em bancos de dados porque operam eficientemente com paginação em disco.
Implementando do zero
Vou mostrar uma implementação simples de árvore binária de busca em Python. Não é production-ready, mas serve para entender o mecanismo antes de partir para bibliotecas prontas. class No: def __init__(self, chave):
self.chave = chave self.esq = None self.dir = None

class ArvoreBB: def __init__(self): self.raiz = None
def inserir(self, chave): if self.raiz is None: self.raiz = No(chave)
else: self._inserir_rec(self.raiz, chave) def _inserir_rec(self, no, chave):
if chave
no.chave: if no.esq is None: no.esq = No(chave)

else: self._inserir_rec(no.esq, chave) else:
if no.dir is None: no.dir = No(chave) else:
self._inserir_rec(no.dir, chave) def buscar(self, chave): return self._buscar_rec(self.raiz, chave)
def _buscar_rec(self, no, chave): if no is None: return False

if chave == no.chave: return True elif chave
no.chave:
return self._buscar_rec(no.esq, chave) else: return self._buscar_rec(no.dir, chave)
Isso funciona para conjuntos pequenos. Com 10.000 elementos inseridos em ordem crescente, a árvore vira uma lista encadeada e a busca cai para O(n). Você já perdeu tempoDebugando isso?
O problema do balanceamento que ninguém conta
A maioria dos tutoriais pula essa parte. Árvore binária de busca desbalanceada é um problema real. Quando os dados vêm ordenados ou quase ordenados, a árvore degenera. O custo de busca, que deveria ser logarítmico, se torna linear. Existem soluções. AVL faz rotação em cada inserção para manter o fator de balanceamento entre -1 e 1. Red-Black usa cores e regras mais flexíveis, permitindo até dois níveis de desbalanceamento. Em termos práticos, AVL tende a ser mais rápida em buscas mas mais lenta em inserções devido ao custo de rebalanceamento constante. Red-Black é mais equilibrada para cenários com muitas atualizações. No meu caso, usei Red-Black em um sistema de catálogo de produtos com milhares de atualizações diárias. A diferença foi clara: enquanto AVL causava travamentos perceptíveis nos picos de atualização, Red-Black manteve performance estável.

Quando NÃO usar árvore
Árvores não são bala de prata. Se você precisa de pesquisa por prefixo, uma trie pode ser melhor. Se o dado é essencialmente uma tabela hash com ordenação, um array ordenado com busca binária pode competir em performance com menos overhead. Se os dados cabem na memória e são pequenos, às vezes um simple list ordenado é mais rápido porque evita overhead de alocação de nós. Também tem o problema da profundidade. Árvores muito profundas causam estouro de pilha em recursão e aumentam a latência em sistemas distribuídos. Eu vi um serviço que usava árvore balanceada com 47 níveis de profundidade porque a entrada de dados era adversarial. As queries tinham latência de 2 segundos. Resolveram trocando por uma estrutura com fan-out maior.
B-trees e o mundo real
Se você trabalha com banco de dados ou sistemas de arquivos, B-tree e B+ tree são as estruturas mais importantes que você vai encontrar. A diferença fundamental é que elas são feitas para disco, não para memória RAM. Cada nó armazena múltiplas chaves e os ponteiros são otimizados para leitura em página. B+ tree é a variação mais comum em SGBDs. Todos os dados ficam nas folhas, que são conectadas em lista encadeada. Isso permite range queries eficientes — algo que B-tree pura não faz tão bem. PostgreSQL, MySQL (InnoDB), e muitos outros usam B+ tree como estrutura de índice padrão. O fan-out típico de uma B-tree de ordem 100 significa que cada nó tem entre 50 e 100 filhos. Com 1 milhão de registros, a árvore tem no máximo 4 níveis. Quatro leituras de disco para encontrar qualquer elemento. Comparado a uma busca linear em tabela, é uma diferença de horas para milissegundos.
Dica prática que leva tempo para aprender
Uma estrutura de arvore é frequentemente subutilizada porque desenvolvedores não consideram a ordem dos dados de entrada. Se você está construindo uma árvore a partir de dados que vêm em ordem, insira-os embaralhados primeiro ou use uma estrutura auto-balanceável desde o início. O custo de embaralhar N elementos é O(N), enquanto o custo de uma árvore degenerada se manifesta em todas as operações futuras. Também monitore a altura da árvore em produção. Logue a profundidade máxima periodicamente. Se você ver crescimento linear em vez de logarítmico, algo está errado com o balanceamento. No meu time, tínhamos um alertrule que disparava quando a razão entre altura e log(N) ultrapassava 3. Isso nos pegou três bugs de implementação em dois anos. A maioria das linguagens modernas já oferece implementações curtas. Em Python, você pode usar a biblioteca bintrees ou sortedcontainers. Em JavaScript, avl-tree ou bintrees npm packages. Em Rust, o crate ordered-map ou redblack. Não reinvente a roda a menos que precise de comportamento específico.
O que separa quem usa árvore corretamente de quem sofre com ela é entender que a estrutura é apenas uma ferramenta. O problema é saber quando ela é a ferramenta certa e quando você está forçando um prego porque só conhece um martelo.