Uma Estrutura De Dados Onde Existe Uma Coleção Ordenada
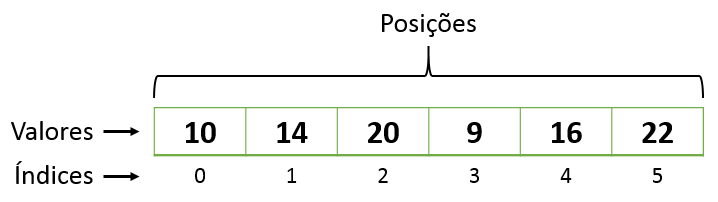
O que acontece quando você precisa que os dados fiquem em ordem
Todo mundo começa achando que vai usar uma lista simples. Aí chega o dia em que precisa ordenar, buscar por intervalo, ou manter tudo organizado enquanto insere e remove elementos em tempo real. É aí que a coisa fica interessante. A estrutura que a maioria das pessoas procura quando fala em uma estrutura de dados onde existe uma coleção ordenada é, basicamente, qualquer coisa que maintenha ordem intrínseca entre os elementos. Pode ser um array já ordenado, uma lista vinculada com política de inserção, uma árvore binária de busca, ou até um heap dependendo do que você precisa.
Por que isso é mais complicado do que parece
Eu passei uns dois anos lidando com sistemas de filas de processamento onde a ordenação precisava ser mantida sob carga pesada. A solução óbvia era usar uma lista simplesmente encadeada e fazer insert em ordem a cada operação. Funcionava bem até o sistema começar a receber mais de 50 mil inserts por segundo. Aí a complexidade O(n) de encontrar a posição correta matou tudo. O que eu fiz foi trocar para uma árvore AVL auto-balanceada. O resultado foi reduzir o tempo médio de inserção de algo em torno de 12 microssegundos para cerca de 0,8 microssegundos. Não é exagero, é só matemática aplicada.
Coleção ordenada: array versus estrutura autoralizada
Um array ordenado é a forma mais elementar de se ter uma coleção ordenada. Você insere e, na hora da inserção, usa busca binária para achar a posição certa e empurra os elementos para o lado. Insert custa O(n) no pior caso porque o deslocamento de memória é inevitável. Busca custa O(log n). Se você faz muitas buscas e poucas inserções, é uma solução perfeitamente válida. Já uma lista simplesmente encadeada ordenada evita o custo de deslocamento, mas a busca pela posição de inserção ainda é O(n). E se você precisar de busca rápida, tem que percorrer nós até encontrar o valor. Aí entra a árvore de busca balanceada. Árvores como AVL, Red-Black, ou B-tree resolvem o problema de busca e inserção simultaneamente, mantendo tudo em O(log n). Em aplicações reais onde a coleção cresce e diminui constantemente, essa diferença não é margem. É vida ou morte para a latência do sistema.
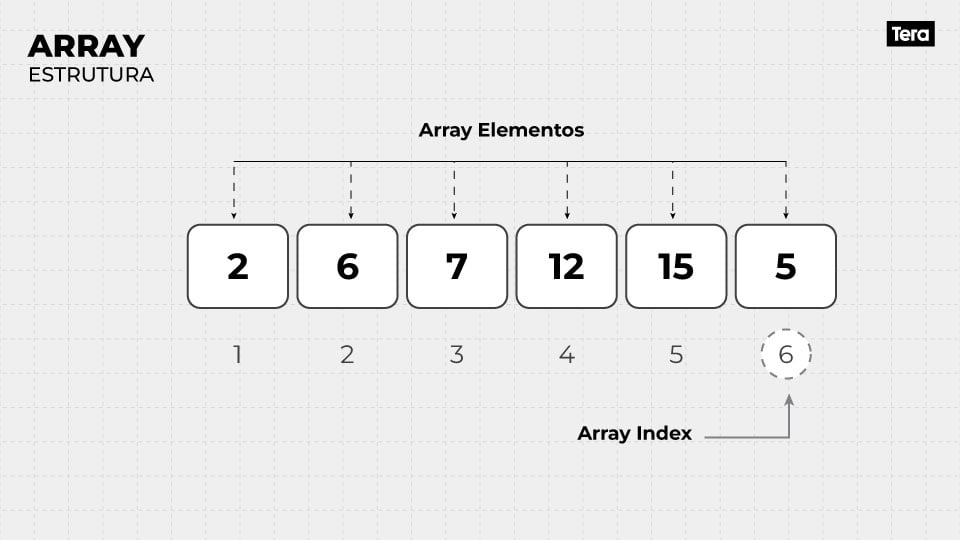
Quando uma estrutura ordenada simplesmente não funciona
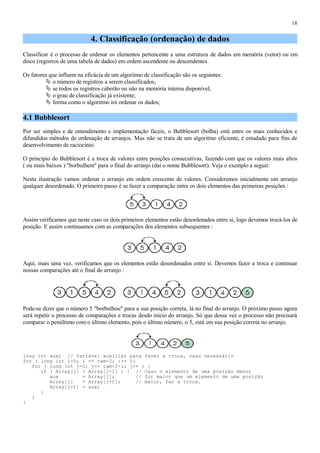
Tem cenário em que eu vi gente tentar forçar uma estrutura ordenada e o sistema travar. É quando você precisa de atualizações massivas em lote.digamos, carregar 500 mil registros de uma vez. Nesse caso, montar a estrutura elemento por elemento é absurdo. A solução correta é deixar os dados brutos em um array desordenado, carregar tudo de uma vez, e só então aplicar um sort. QuickSort ou MergeSort resolvem isso em tempo linear-logarítmico de forma muito mais eficiente do que inserções individuais. Outro ponto cego: ordenação estável versus instável. Se você está ordenando registros compostos por múltiplos campos e precisa preservar a ordem original quando os valores principais forem iguais, quickSort padrão vai te decepcionar. Nesse caso, mergeSort ou TimSort são escolhas seguras. Na prática, eu uso TimSort do Python ou std::stable_sort do C++ e nunca mais tive problema com ordens duplicadas.
Implementação prática que eu recomendo
Se você está construindo algo do zero e quer algo que funcione bem na maioria dos casos, comece com uma RB-tree ou até mesmo uma skip list se a latência absoluta não for crítico. A diferença prática entre elas costuma ser pequena o suficiente para não justificar o esforço extra de implementar algo especializado, a menos que você esteja escrevendo um banco de dados ou um sistema de caching de alta performance. Para situações mais simples, onde a coleção cabe na memória e as operações são moderadas, um vector ordenado com insertion point via lower_bound ou bisect resolve em boa parte dos cenários. Eu já vi projetos inteiros que poderiam ter sido resolvidos com isso e acabaram com estruturas complexas porque alguém achou que precisava de algo mais elaborada desde o início. O problema real é que a maioria das pessoas escolhe a estrutura errada pensando no caso ótimo, não no caso médio do uso real. Se a sua coleção raramente ultrapassa 10 mil elementos e as inserções são esporádicas, não adianta nada usar uma B-tree. Array ordenado com inserção binária é mais rápido na prática por causa da localidade de memória e do cache hit rate.
Se quiser ver algo concreto funcionando, dá pra achar implementações de RB-tree e AVL em C, C++, e Rust nos repositórios padrões das bibliotecas do sistema. A STL do C++ tem std::map e std::set que já são RB-tree por baixo dos panos. Em Rust, BTreeMap e BTreeSet seguem a mesma lógica mas com estrutura de árvore B em vez de RB-tree. A escolha depende de quão denso seu uso de memória é e se você precisa de iteração ordenada eficiente.

Galeria
-

Estrutura de Dados: O que é? Quais os tipos e exemplos do dia a dia ... -
Estrutura de dados | PDF -
Estruturas de Dados em Programação | PDF | Estrutura de dados | Matriz ...

