Uma Situação Bastante Comum No Desenvolvimento De Software

Por que seu serviço às vezes processa o mesmo evento duas vezes
O sistema de pagamento começou a duplicar saques numa sexta à tarde. Nada de alarme nos dashboards, só uma fila crescente de transações pendentes que ninguém tinha pedido. O log mostrava que cada mensagem do Kafka chegava exatamente uma vez ao tópico, mas dois consumers estavam processando o mesmo offset como se fossem mensagens diferentes. Isso não é um bug de lógica de negócio. É uma situação bastante comum no desenvolvimento de software e geralmente aparece quando você começa a escalar e percebe que seu sistema de fila não funciona mais como você imaginou. A duplicação acontece porque a separação entre consumo e confirmacao (acknowledgment) não é atômica. No Kafka, por exemplo, o consumer lê uma mensagem, processa, e só depois marca o offset como confirmado. Se o processo cair entre o recebimento e a confirmação, o broker reprova aquela mensagem. No SQS padrão, o problema é similar: a mensagem fica invisível por um período configurado, mas se o tempo expirar antes da confirmação, ela volta para a fila. No RabbitMQ, existe o cenário do prebasic.consume sem basic.ack, que é ainda pior porque o channel pode quebrar silenciosamente. O que a maioria dos tutoriais não menciona é que o problema raramente é apenas na fila em si. Aparece quando você tem múltiplos workers competindo pelo mesmo recurso compartilhado — um estoque que dois consumidores verificam e decrementam sem sincronização, um registro de banco que dois processos leem e escrevem simultaneamente, ou uma API externa que recebe duas requisições idênticas de um serviço que não implementou idempotência no nível da aplicação.
O mecanismo real por trás da duplicação
Todo sistema de mensageria comercial promete pelo menos uma entrega. O at-least-once é o padrão. Isso significa que a garantia contratual permite duplicação. A responsabilidade de lidar com isso fica inteiramente sobre você. Não existe configuração mágica que resolva isso pelo broker. O exactly-once semantics existe no Kafka para transações dentro do próprio cluster, mas quando sua mensagem sai para o mundo real — um banco de dados, uma API de terceiros, um arquivo no S3 — a garantia some. Meu primeiro encontro sério com isso foi em 2019, num sistema de processamento de pedidos. Tinhamos dois consumers de um tópico com autocommit desativado. Cada consumidor era um container Docker escalado horizontalmente. Quando um consumer caía após processar uma mensagem mas antes de fazer o commit manual do offset, o broker reprova a mensagem. O segundo consumer, que estava rodando no mesmo grupo, recebia a mensagem duplicada. O problema é que nosso processador não tinha nenhuma verificação de duplicidade. O saldo do cliente era descontado duas vezes. Identificamos isso porque um usuário relatou que o dinheiro havia sido cobrado duas vezes e só conseguiu resolver abrindo um chamado de suporte. A solução que implementamos foi baseada em chave de idempotência. Cada mensagem carregava um UUID gerado pelo produtor, que era usado como chave única no banco de dados. Antes de processar, fazíamos uma INSERT ... ON CONFLICT DO NOTHING com uma constraint unic na chave. Se a inserção falhasse por violação de restrição, sabíamos que aquela mensagem já havia sido processada e simplesmente descartávamos. Isso reduziu as reclamações relacionadas a duplicação de zero para praticamente zero em produção.
Como detectar antes que chegue em produção
O problema é que duplicação em filas é, por natureza, difícil de detectar em testes unitários. Ninguém programa testes que simulam crashes de consumer propositalmente. O jeito mais confiável é testar o comportamento de ponta a ponta com um cenário deliberado de falha. Você cria um consumer que lança uma exceção após receber uma mensagem mas antes de confirmar. Reinicia o consumer. Verifica se a mensagem foi processada duas vezes. Se for, seu código não é idempotente e precisa de proteção. Outro ponto que as pessoas ignoram: a visibilidade da mensagem. No SQS, o visibility timeout padrão é 30 segundos. Se seu processamento leva 45 segundos, a mensagem vai voltar para a fila antes mesmo de terminar. Isso causa duplicação sem crash algum. A correção é simples — aumentar o timeout para um valor maior que o tempo máximo de processamento — mas o sintoma é o mesmo e muita gente gasta horas debugando algo que é apenas uma configuração errada.
Limitações que ninguém comenta
A abordagem de chave de idempotência funciona bem na maioria dos casos, mas tem custos. Você precisa de uma tabela ou coleção com constraint unic para armazenar os IDs já processados. Isso significa escrita extra no banco para cada mensagem. Em sistemas com volume alto de mensagens, isso vira um gargalo. No nosso caso, processávamos cerca de 2.000 mensagens por segundo e a tabela de idempotência cresceu para 40 milhões de linhas em seis meses. Precisamos implementar uma política de retenção com DELETE periódico baseado em timestamp, senão a consulta ficaria cada vez mais lenta. Existe também o problema da janela de tempo. Se você usa apenas uma chave de idempotência sem expiração, nunca vai conseguir descartar dados antigos sem risco de um replay tardio de mensagem. A alternativa é usar uma janela de 24 a 72 horas, o que cobre a maioria dos cenários de replay mas deixa uma pequena lacuna para sistemas com latência extrema. Ninguém considera isso até receber um ticket de um operador de sistema legado que ancora mensagens há dias. Uma limitação mais sutil é que a idempotência resolve a duplicação, mas não resolve a ordem. Se duas mensagens chegam duplicadas e há uma terceira mensagem dependente da primeira, garantir a ordem correta exige estratégia adicional, como sequenciamento com ou processamento sequencial por chave de partição. Em sistemas distribuídos, isso consome mais tempo do que qualquer outra coisa em arquitetura de mensagens.
O que fazer quando idempotência não basta
Se o custo de manter uma tabela de idempotência é proibitivo ou se seu sistema processa milhões de eventos por segundo, existem alternativas. Uma é usar um deduplicator stateless baseado em hash, como um Bloom filter ou um segment cache com TTL, antes que a mensagem chegue ao consumer. Outra é repensar o modelo: em vez de processar cada mensagem individualmente, usar agregação em batch com INSERT IGNORE em massa. Isso reduz drasticamente o número de escritas únicas no banco. O ponto mais importante é que você precisa decidir onde a garantia de unicidade vive. No broker? No consumer? No banco? Na API externa? Cada escolha tem um custo diferente e nenhum é gratuito. Minha recomendação prática é começar com a chave de idempotência no banco, medir o impacto, e só migrar para estratégias mais complexas se o volume realmente exigir. Na maior parte dos casos, o volume nunca exige migração porque o sistema nem chega perto do limite que você imagina.
Galeria
-

Etapas De Desenvolvimento De Software – MDYWI -
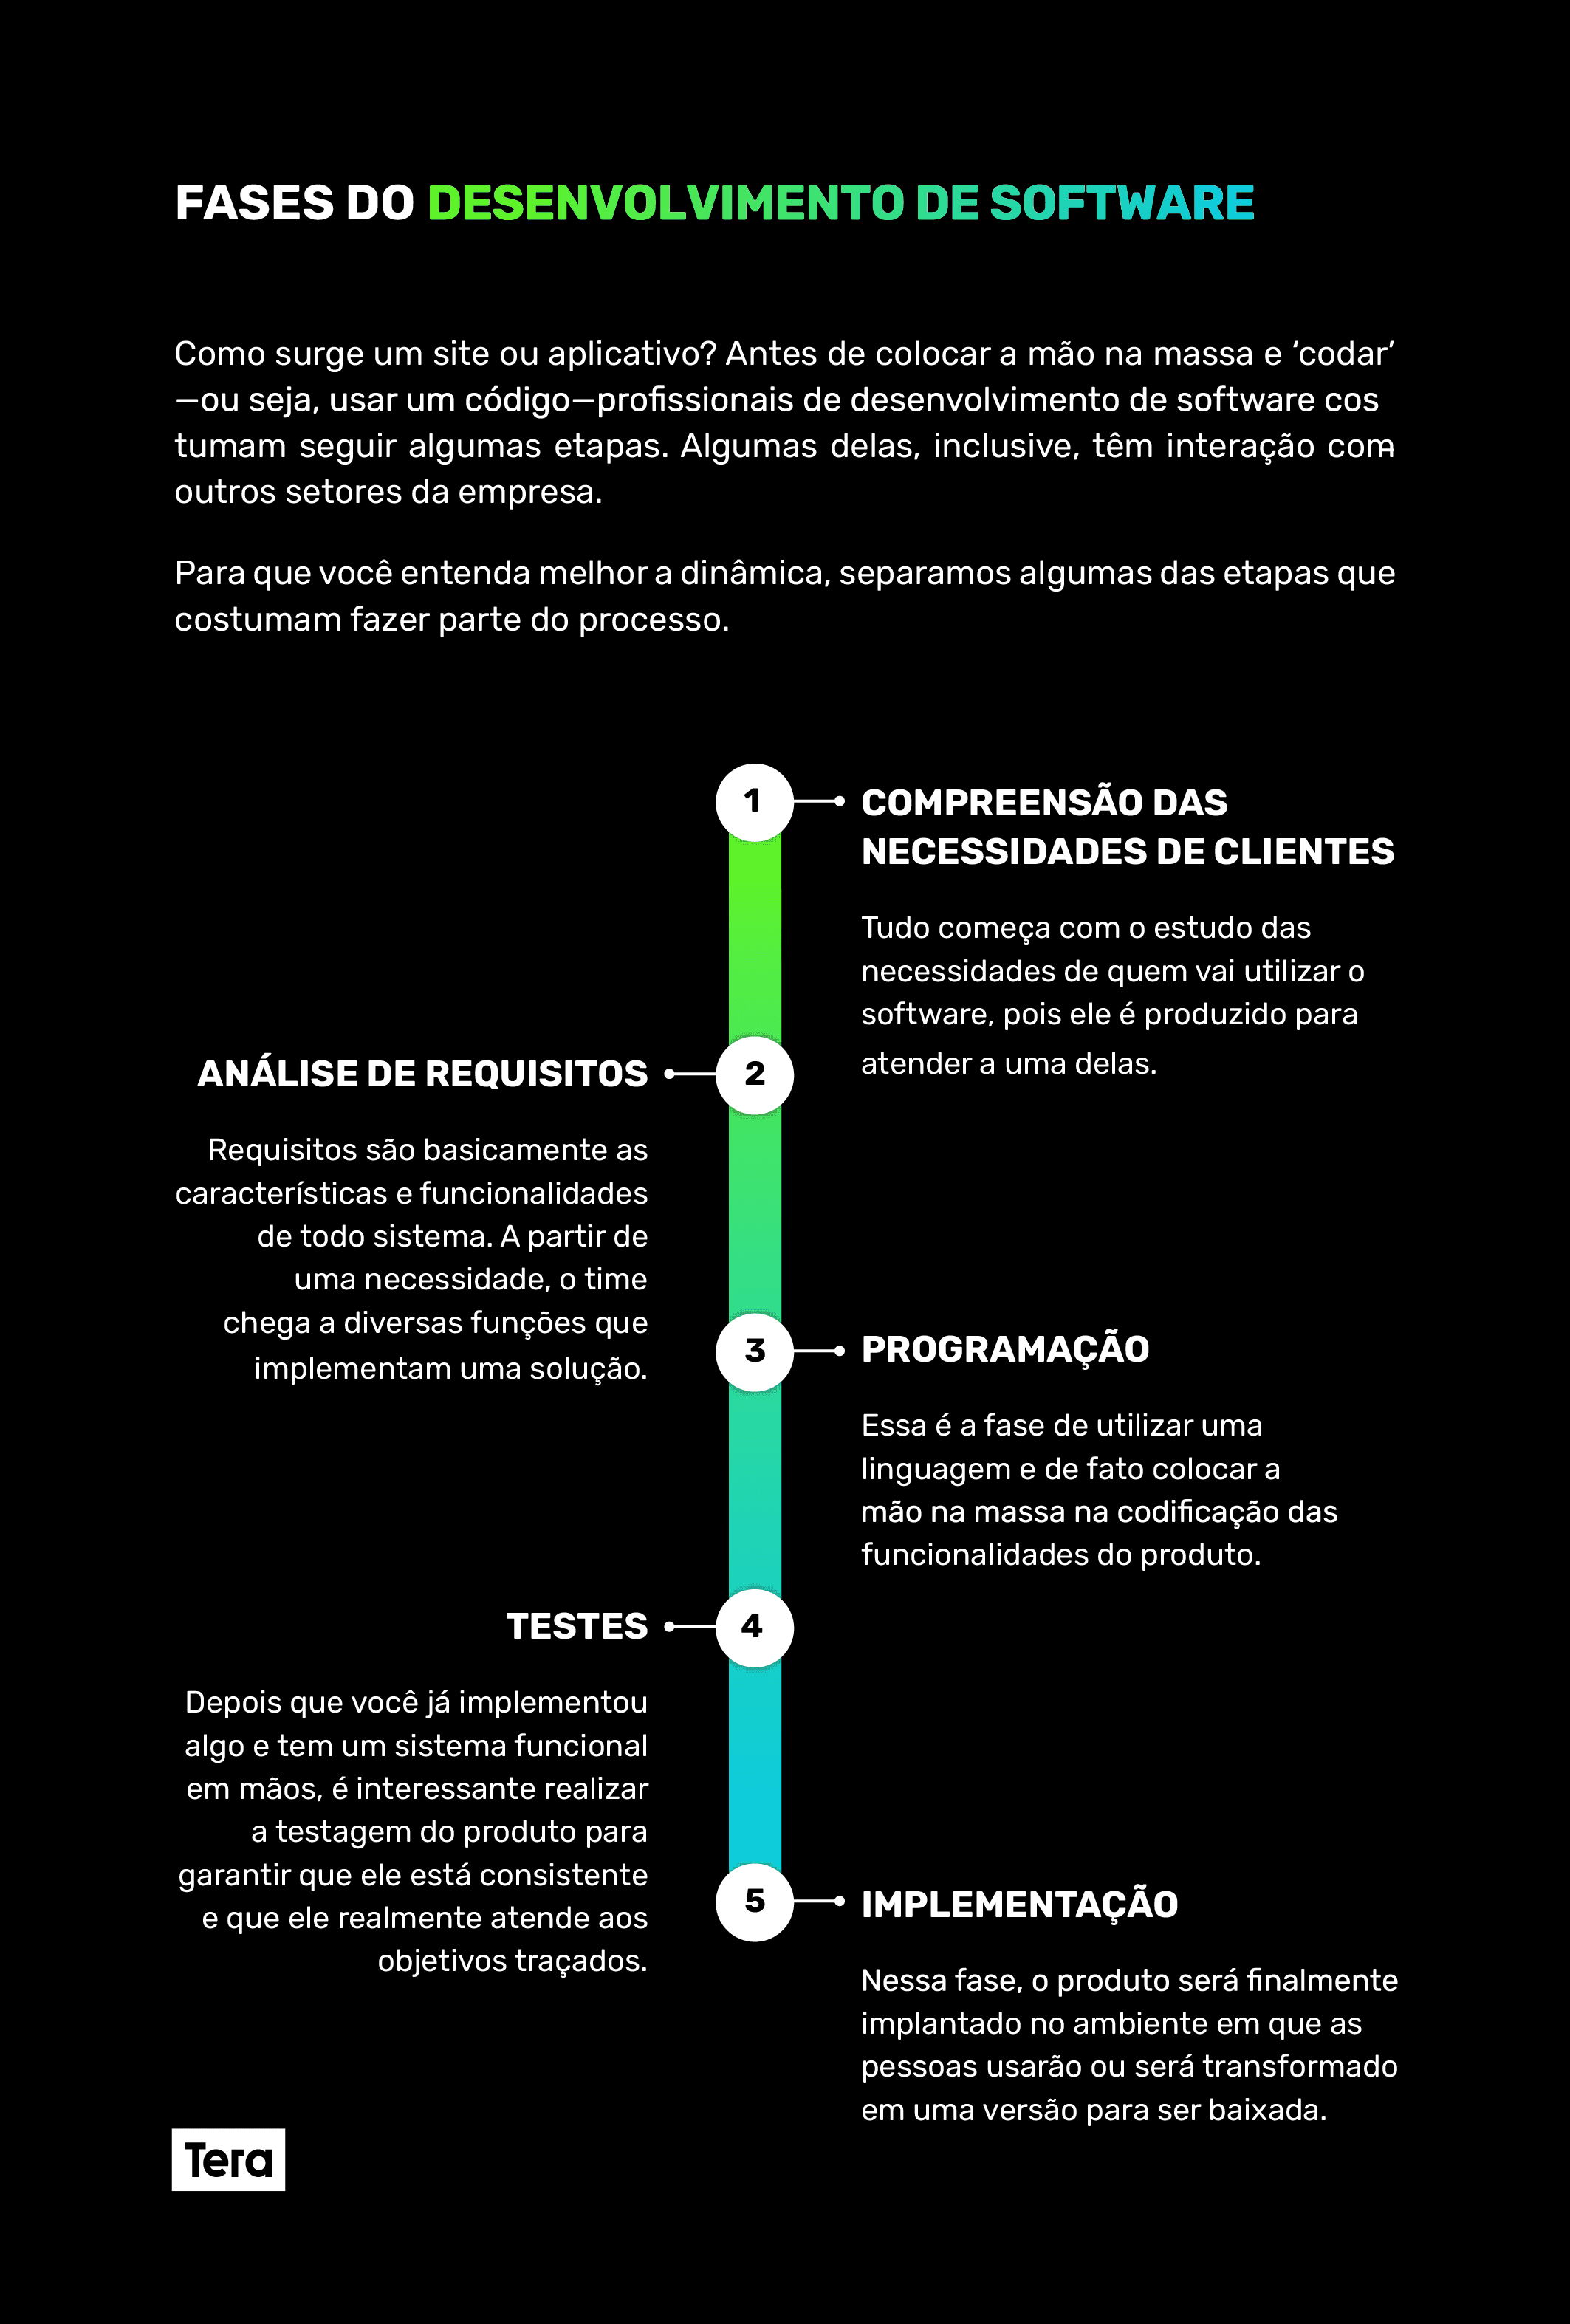
Entenda o que é desenvolvimento de software e como funciona o processo ... -

Diagrama De Implantao Processos De Desenvolvimento De Software -

Os 10 principais modelos de roteiro de desenvolvimento de software com ...
