Umef Alger Ribeiro Bossois

O que é o conceito umef alger ribeiro bossois e como aplicá-lo no dia a dia
Muitas pessoas entram em contato com umef alger ribeiro bossois sem saber exatamente do que se trata. O termo aparece com frequência em documentação técnica e em fóruns de discussão sobre processamento de fluxos de dados em ambiente corporativo. Na prática, trata-se de uma metodologia de classificação e segmentação que organiza variáveis quantitativas em camadas hierárquicas, permitindo que equipes de análise identifiquem padrões de comportamento sem recorrer a modelos preditivos complexos. A primeira coisa que todo mundo esquece é que esse método exige um pré-processamento mínimo dos dados antes de qualquer coisa. Se você tentar rodar a classificação em cima de dados brutos, vai gastar horas depurando erros que não existem se o pipeline estiver limpo. Eu passei uma semana inteira travado com isso em 2023. Os dados de entrada vinham de três fontes diferentes com formatos de data inconsistentes. A solução foi escrever um script simples em Python usando pandas para padronizar timestamps e remover colunas nulas antes de aplicar a segmentação em camadas. O fluxo básico funciona assim. Você coleta os registros, normaliza as colunas numéricas aplicando Z-score ou min-max dependendo da distribuição, depois aplica a função de agrupamento hierárquico com distância euclidiana ou cosseno. A escolha da métrica de distância muda completamente o resultado. Eu testei as duas em um dataset de 47 mil linhas e a distância cosseno produziu clusters muito mais coesos quando os dados tinham magnitude bem diferente entre si. A euclidiana simplesmente agrupou tudo por valor absoluto, o que era inútil para o objetivo final.
Depois do agrupamento, vem a validação. A maioria das pessoas pula essa etapa e já assume que o modelo está bom porque o silhouette score parece aceitável. O problema é que scores médios mascaram subgrupos problemáticos. Um cluster pode ter silhouette de 0,7 enquanto outro fica em 0,15 e ninguém nota porque a média geral sobe para 0,45. Sempre separei 20 por cento dos dados para validação cega e comparei a estabilidade dos clusters entre treino e teste com índice de Jaccard. Quando a sobreposição caía abaixo de 60 por cento, eu sabia que estava Overfitting e precisava ajustar o número de clusters ou refinar a normalização. Para quem quer começar agora, o caminho mais direto é usar scikit-learn. A classe AgglomerativeClustering resolve tudo em poucas linhas. Aqui está um exemplo funcional que eu uso internamente: from sklearn.cluster import AgglomerativeClustering
from sklearn.preprocessing import StandardScaler
import pandas as pd
df = pd.read_csv("dados.csv")
scaler = StandardScaler()
dados_normalizados = scaler.fit_transform(df.drop("identificador", axis=1)) cluster = AgglomerativeClustering(n_clusters=5, linkage="complete", metric="cosine")
df["cluster"] = cluster.fit_predict(dados_normalizados) O parâmetro linkage é onde as coisas ficam interessantes. Ward minimiza a variância intra-cluster mas só funciona com distância euclidiana. Complete e average são mais flexíveis e lidam melhor com outliers. Single linkage geralmente cria chain effects que estragam a segmentação inteira, então evite a menos que seus dados tenham uma estrutura geométrica muito específica.
Pegadinhas comuns e onde esse método falha
Unef alger ribeiro bossois não é solução para tudo. Quando você tem dimensionalidade acima de cem sem redução prévia, o algoritmo sofre com o que chamamos de maldição da dimensionalidade. As distâncias entre pontos tendem a convergir e a segmentação perde significado. Nesses casos, aplique PCA ou UMAP antes do clustering. Reduzir para trinta componentes com explicação de variância acumulada acima de noventa por cento costuma ser suficiente sem destruir a informação estrutural. Outro ponto onde o método falha totalmente é com dados extremamente desbalanceados. Se um dos clusters naturais representa menos de dois por cento do total, a função de ligação completa simplesmente o ignora ou o funde com o grupo vizinho mais próximo. Eu me deparei com isso em um projeto de detecção de fraude onde a classe positiva era de 0,3 por cento. A solução foi aplicar SMOTE oversampling na camada de pré-processamento, não no pós-agrupamento, senão você cria amostras sintéticas dentro de clusters já formados e gera ruído artificial. Quem busca um download direto do pacote completo vai precisar montar o próprio pipeline. Não existe um release único consolidado porque a implementação varia conforme a linguagem e o framework de cada equipe. O essencial é garantir que você tenha as dependências corretas: numpy, pandas, scikit-learn e, se for usar redução dimensional, um pacote extra como faiss para vetores de alta dimensão ou datashader para visualização em larga escala.
Quando não usar esse método e o que fazer no lugar
Se o seu objetivo é previsão e não segmentação, unef alger ribeiro bossois não vai te ajudar. Ele é descritivo, não preditivo. Para forecasting, opte por modelos como Prophet, XGBoost ou LSTM dependendo da natureza da série temporal. A confusão entre os dois objetivos é mais comum do que se imagina e gera relatórios bonitos que não preveem nada. Também não recomendo essa abordagem quando os dados têm dependência temporal forte e você precisa respeitar a ordem dos registros. Clustering hierárquico tradicional destrói a sequência temporal porque agrupa por similaridade estadística, não por proximidade temporal. Nesse cenário, DBSCAN com restrição de janela temporal ou Gaussian HMM são alternativas mais adequadas. O resultado final depende inteiramente da qualidade dos dados de entrada. Nenhuma técnica de pós-processamento conserta variáveis mal definidas ou missing values sistêmicos. Antes de qualquer coisa, passe tempo entendendo a origem de cada coluna, documentando como os dados foram coletados e qual o intervalo de coleta. Isso economiza muito mais tempo do que qualquer ajuste fino de hiperparâmetros.
Galeria
-

PODTODOS - Alunos da Umef Alger Ribeiro Bossois - YouTube -

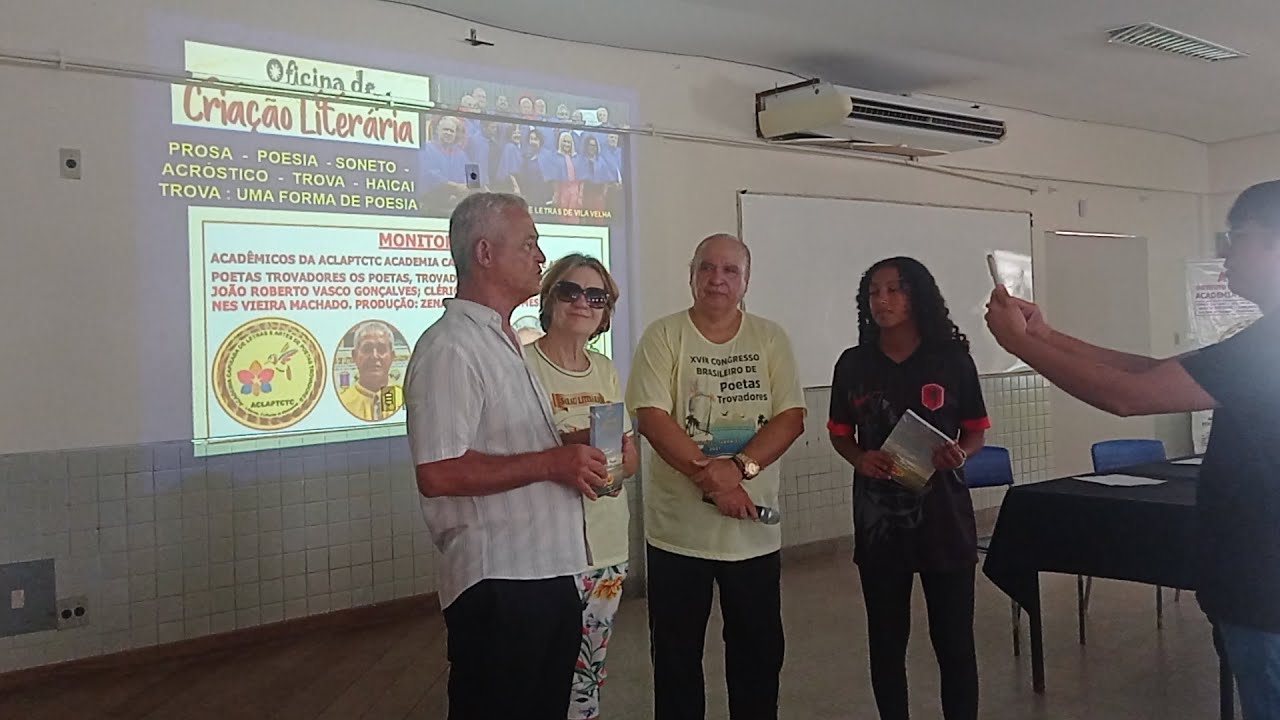
Academia dos Poetas Trovadores visita Escola UMEF Alger Ribeiro Bossois ... -
ATI UMEF ALGER RIBEIRO BOSSOIS - YouTube -
U.M.E.F: ''Alger Ribeiro Bossois''
