Uniao E Intersecção

União e intersecção na prática
Todo mundo aprende isso na escola: união é juntar os elementos de dois conjuntos, intersecção é ficar só com o que aparece nos dois. A teoria é simples, mas o que as pessoas não dizem é como isso vira dor de cabeça quando você tenta aplicar em dados reais. No dia a dia, você raramente trabalha com conjuntos desenhados num quadro negro. Você trabalha com listas, planilhas, tabelas de banco de dados, logs de servidor. E aí a coisa muda de figura rapidamente.
Uniões e interseções podem te salvar ou destruir um relatório
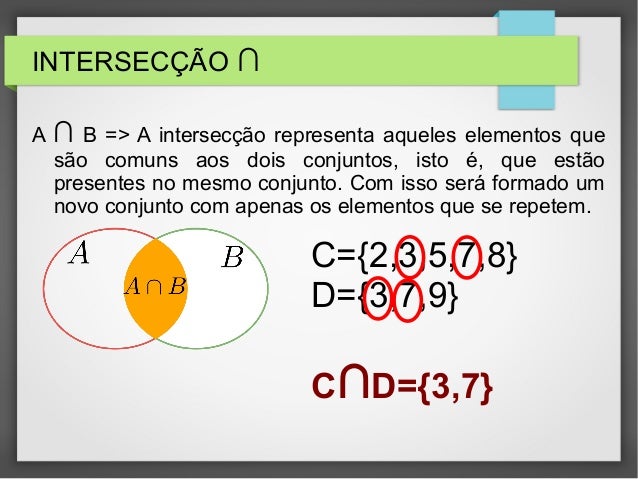
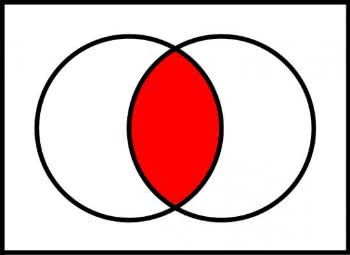
A união de dois conjuntos A e B, representada por A B, pega todo elemento que está em A, em B, ou em ambos. Sem repetição. A intersecção, A B, pega apenas o que é comum aos dois. Em SQL, isso se traduz em UNION e INTERSECT. Em Python com sets, operator | e &. Em Excel, dependendo da versão, você briga com fórmulas matriciais ou vai para o Power Query. O problema é que a teoria assume conjuntos bem comportados. Dados reais não são.
Eu lembro de uma vez que precisei fazer a intersecção de duas listas de clientes para validar um mapeamento de chaves estrangeiras. Uma lista vinha do sistema legado, outra do CRM novo. O conjunto A tinha cerca de 40 mil registros, o conjunto B cerca de 35 mil. A intersecção deveria retornar os clientes que existiam nos dois sistemas. O resultado veio com 2.847 registros. Eu conferi manualmente e percebi que 12 deles estavam errados. O motivo: um campo de CPF estava formatado de forma diferente em cada sistema. No legado, vinha com pontos e traço. No CRM, vinha só os números. A intersecção via strings diferentes e descartava como não correspondentes. Eu resolveu normalizando tudo com uma função que removesse caracteres não numéricos antes de comparar. Ajuste trivial, mas que quase estragava a análise inteira. Isso acontece o tempo todo. Tipos diferentes, espaçamentos, acentos, maiúsculas e minúsculas. A intersecção não sabe que "Maria Silva" e "maria silva" são a mesma pessoa. Ela só vê strings.

Como fazer sem perder tempo
A abordagem mais direta é limpar os dados antes de qualquer operação. Remova espaços em branco nas pontas, padronize caixa, normalize acentos se o contexto pedir, e trate valores nulos explicitamente. Em Python: limpo = {s.strip().lower() for s in lista if s}
Isso já elimina uma grande parte dos falsos negativos que aparecem em interseções mal feitas. Para união, o cuidado maior é com duplicatas. Union em SQL remove duplicatas por padrão, o que é bom para integridade mas ruim para performance em conjuntos grandes. Se você está unindo tabelas com milhões de linhas, o DISTINCT pode transformar uma operação de segundos em uma de horas, porque o banco precisa ordenar tudo antes de remover os repetidos. Nesse caso, o UNION ALL é mais rápido porque não faz a deduplicação. Você decide depois, se necessário, o que fazer com os duplicados. Na minha experiência, o UNION ALL resolve a maioria dos casos práticos porque as duplicatas realmente problemáticas são raras quando os dados vêm de fontes distintas.
Um ponto que poucos mencionam: a ordem dos elementos em um set não é garantida. Se você precisa de resultados ordenados para comparação visual ou para exportar para alguém que espera algo específico, precisa ordernar explicitamente depois da operação. Caso contrário, você vai receber os dados bagunçados e alguém vai achar que houve bug. Outra armadilha comum é confundir a diferença simétrica com a intersecção. A diferença simétrica (A B) pega o que está em A ou em B, mas não em ambos. É o oposto da intersecção em certo sentido. Às vezes as pessoas pedem intersecção quando na verdade querem a diferença simétrica, ou vice-versa. O erro é sutil e o resultado pode levar a conclusões completamente erradas em análises de dados. Para operações em larga escala, considere usar estruturas otimizadas como bitsets quando os universos forem finitos e conhecidos. Em vez de armazenar os elementos propriamente ditos, você armazena bits indicando presença. A intersecção vira uma operação bitwise AND, que é absurdamente rápida. Isso é usado em índices de banco de dados, em sistemas de recomendação, e em ferramentas de segurança para representar grupos de permissão.
Se os seus conjuntos forem muito grandes e esparsos, um Bloom filter pode dar uma resposta aproximada de intersecção com uso de memória muito menor. A desvantagem é que ele pode dar falsos positivos. Você nunca saberá com certeza se um elemento está no conjunto, apenas que provavelmente está. Depende do seu caso decidir se essa margem de erro é aceitável. Na hora de montar um relatório ou script que use esses conceitos, anote quais pré-processamentos você fez antes da operação. Tipagem, limpeza, normalização. Quem receber o resultado precisa saber se os dados já passaram por aquele filtro ou se precisa refazê-lo. Sem essa informação, a próxima pessoa vai confiar num resultado que pode estar errado por causa de um detalhe que você deu como óbvio. O resto é prática. Você vai errar uns quantos casos de borda, vai descobrir que dois sistemas tratam datas de jeitos diferentes, e vai aprender a desconfiar de qualquer intersecção que retorne exatamente zero ou exatamente o tamanho do menor conjunto sem que haja uma razão lógica para isso. Zero é raro. O tamanho exato do menor também. Quando acontece, olhe duas vezes antes de celebrar.
Galeria
-

Operação de conjunto de intersecção de união diferente subconjunto ... -
Operações com Conjuntos: união, intersecção e diferença - Toda Matéria -

.: Intersecção e união de conjuntos
