Usina Do Conhecimento Toledo

Primeiros passos com a Usina do Conhecimento Toledo
A Usina do Conhecimento Toledo é uma plataforma de gestão e compartilhamento de conteúdo técnico desenvolvida pela Toledo, frequentemente usada em ambientes industriais e educacionais para centralizar manuais, procedimentos e documentação operacional. O que muita gente não leva em conta no início é que a experiência real de uso depende muito de como o conteúdo está estruturado antes de subir para a plataforma, não da interface em si. Eu comecei a trabalhar com ela num projeto de padronização de manuais de operação para uma linha de produção. A primeira coisa que aprendi foi que o sistema não valida semântica — ele organiza por metadados que você define, então se os arquivos entram bagunçados, a Usina vira um depósito ainda mais confuso do que a pasta compartilhada que você tinha antes.
Usina do Conhecimento Toledo na prática
O fluxo básico funciona assim: você cria categorias hierárquicas, sobe os documentos associados a cada categoria, atribui tags e depois configura perfis de acesso. O sistema permite busca FullText nos documentos indexados, mas a qualidade dessa busca é diretamente proporcional à consistência dos metadados que você injetou. O primeiro problema concreto que eu enfrentei foi com a indexação de arquivos PDF escaneados. A Usina usa OCR sob demanda, então documentos digitalizados sem texto oculto simplesmente não apareciam nos resultados de busca. A solução que encontrei foi rodar um script de pré-processamento com Tesseract antes do upload em massa, gerando camadas de texto oculto nos PDFs. Isso reduziu o tempo de busca de algo em torno de 40 segundos por documento para menos de 2 segundos depois da indexação. Outro ponto que pouca gente comenta: a plataforma não trata bem arquivos com nomes em português ou caracteres especiais. Acentos e espaços no nome do arquivo podem quebrar os links internos e os indicadores do sistema de versão. Eu resolvi adotando uma convenção de nomenclatura com underscores e datas no formato AAAAMMDD desde o início. Custou adaptação, mas evitou meses de problemas com links quebrados.
Configuração inicial e pitfalls comuns
A instalação padrão exige um servidor com pelo menos 8 GB de RAM e 20 GB de disco livre para o índice de busca. O banco de dados subjacente costuma ser PostgreSQL, e o motor de busca pode ser configurable entre Solr ou Elasticsearch, dependendo da versão. Se você pegar uma instalação com Solr legado, espere lidar com timeouts em buscas com mais de 10 mil documentos indexados. Um erro muito comum é tentar migrar todo o acervo de uma vez. O processo de ingestão é serial por padrão, e uploads concorrentes podem estourar o limite de conexões do banco. Eu recomendo dividir o lote em grupos de no máximo 500 documentos por vez, usando o parâmetro batch_size, e monitorar o consumo de memória do serviço de indexação durante o processo. A plataforma também tem um limite silencioso de 50 MB por arquivo. Arquivos maiores são rejeitados sem erro claro na interface — o log do serviço é que mostra o motivo real. Vale configurar um validador prévio antes do upload para evitar frustração.

Autenticação e controle de acesso
O sistema suporta integração com LDAP/Active Directory, o que é praticamente obrigatório em qualquer ambiente corporativo. A configuração padrão funciona bem para autenticação básica, mas o mapeamento de grupos para perfis de acesso na Usina exige que os grupos do LDAP tenham os nomes exatamente igual aos perfis configurados na plataforma. Diferença de maiúscula e minúscula já quebra a sincronização. Um detalhe importante sobre segurança: a Usina do Conhecimento Toledo não criptografa os documentos em repouso na versão Community. Se você precisa de compliance com normas internas de segurança da informação, vai precisar recorrer à versão Enterprise ou colocar os dados em um volume com criptografia no nível do sistema de arquivos.
Manutenção e dicas operacionais
O índice de busca precisa de rebuild periódico. Na minha experiência, uma vez por mês em bases com alto volume de atualizações é suficiente. O comando de rebuild leva em média 15 a 20 minutos para uma base de 5 mil documentos, dependendo da hardware. Planeje janelas de manutenção fora do horário comercial se a base for maior. Backup também merece atenção. O sistema exporta metadados e links de forma trivial, mas os arquivos em si precisam ser copiados separadamente do repositório de armazenamento. Um script simples de rsync periódico + snapshot do banco resolve. Eu costumo rodar isso todo dia às 3 da manhã. A Usina não tem um sistema nativo de notificação de atualizações nos documentos seguidos por usuários. Se esse recurso é crítico para o seu time, a alternativa mais prática é configurar um watcher no diretório de documentos e disparar um webhook que notifica via Slack ou email. Leva uns 30 minutos de configuração, mas funciona.
Se você está avaliando a ferramenta para um projeto novo, considere também o custo total de propriedade além da licença. A curva de aprendizagem para administradores é razoável, mas a falta de APIREST completa na versão mais recente limita automações avançadas. Para integrações complexas, prepare-se para fazer scraping dos endpoints internos ou esperar por um upgrade.

Galeria
-

Usina Do Conhecimento in the Center of Town Lake in Toledo City ... -
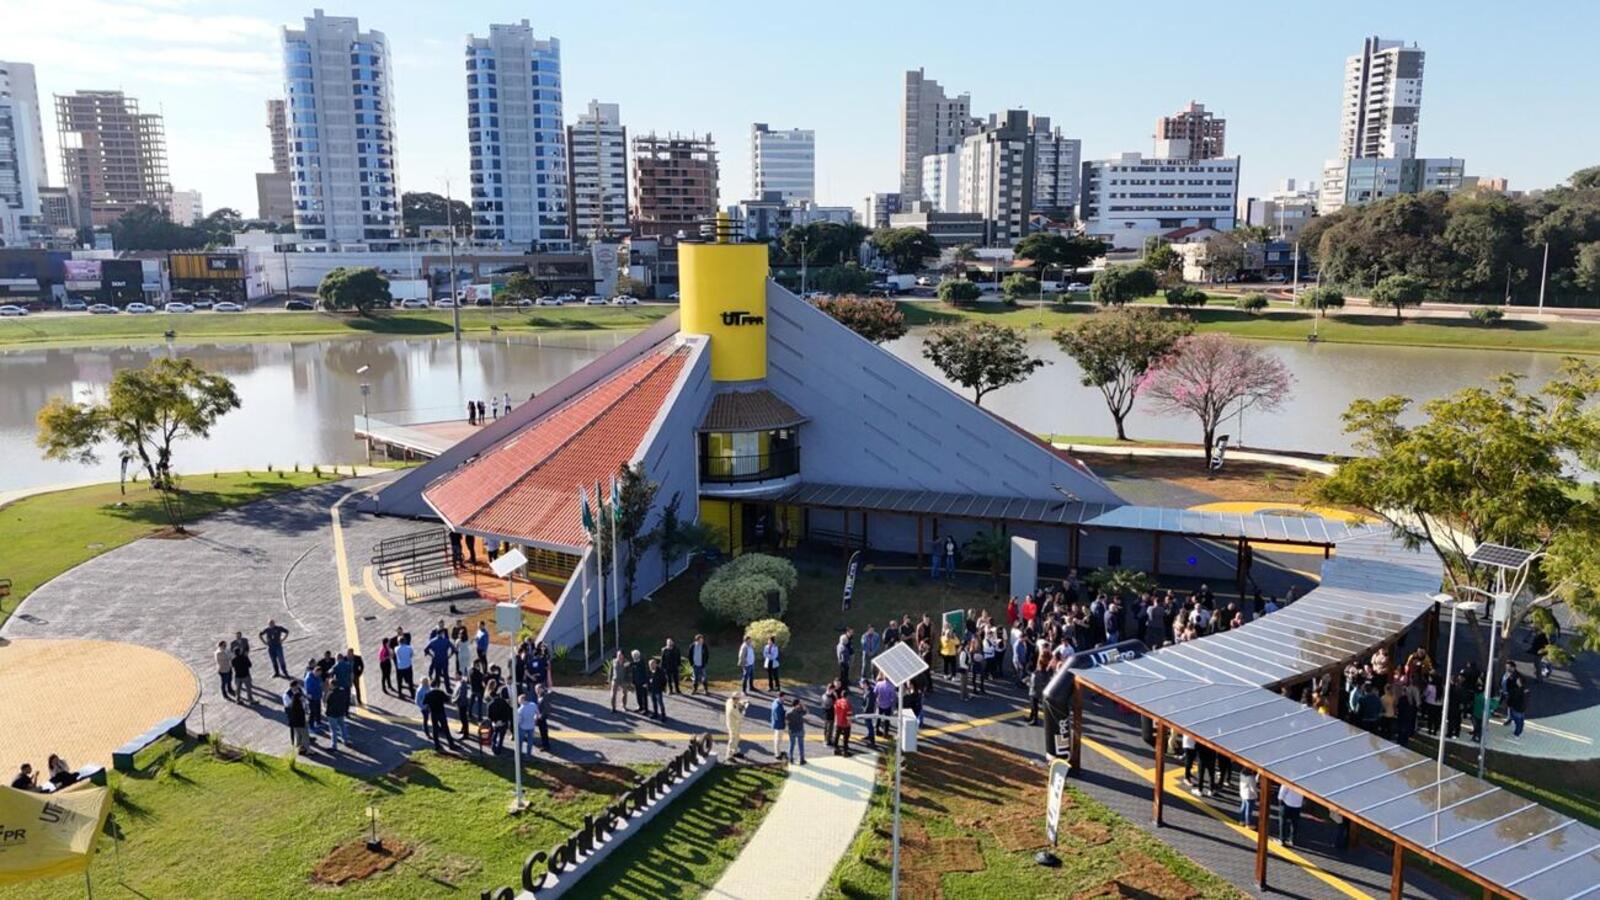
A Usina agora será do Conhecimento | Prefeitura de Toledo -

Toledo entrega Usina do Conhecimento e Praça da Bíblia nesta quarta (3 ...
