Variancia E Desvio Padrao Formulas

Calculando variancia e desvio padrão na prática
A maioria das pessoas começa errado porque olha para a fórmula antes de entender o que está acontecendo. Vou mostrar os cálculos diretos e depois explicar o que eles realmente significam, porque só de saber a fórmula você não aprende a interpretar nada. A variância populacional é calculada assim: divide-se a soma dos quadrados das diferenças entre cada valor e a média pelo total de observações. O desvio padrão é simplesmente a raiz quadrada da variância. Para amostras, a coisa muda porque divide-se por n menos um no lugar de n. A diferença parece pequena mas ela é real e afeta seus números quando o grupo não é grande. Aqui estão as fórmulas escritas de forma limpa. Variância populacional: ² = (x - )² / N. Variância amostral: s² = (x - x)² / (n - 1). Desvio padrão populacional: = ². Desvio padrão amostral: s = s². Onde x é cada valor, é a média populacional, x é a média amostral e N ou n é o tamanho da amostra.
No meu caso, eu estava processando dados de temperatura de sensores industriais com cerca de 400 leituras e a variância deu algo extremamente baixo, tipo 0.003. Aí eu olhei e percebi que os valores estavam em graus Celsius com três casas decimais e uma leve deriva térmica do equipamento. A média parecia estável mas o desvio padrão, quando arredondado para duas casas, simplesmente sumia. A workaround foi converter tudo para Kelvin primeiro e depois recalcular. O desvio padrão saiu como 0.057 K, um número que faz sentido físico. Converter a unidade antes de calcular evitou que a precisão numérica do dado em escala Celsius mascaras a variação real. Isso aconteceu comigo uma vez e levou dois dias pra perceber o erro. O que ninguém te conta sobre variância é que ela é sensível a outliers de forma desproporcional porque ela eleva tudo ao quadrado. Um único ponto distante pode inflar a variância por cinco ou seis vezes sem necessariamente indicar que o resto dos dados está assim. Eu já vi gente usar variância pura para detectar anomalia e o resultado era uma bagunça porque três ou quatro pontos raros dominavam tudo. O truque é olhar o coeficiente de variação, que é o desvio padrão dividido pela média, expresso em porcentagem. Isso normaliza a escala e permite comparar dispersão entre grupos com médias muito diferentes. Se um conjunto tem média 100 e desvio 10, o coeficiente é 10 por cento. Outro com média 2 e desvio 1 também tem 50 por cento. São distributions diferentes mas o coeficiente mostra isso de cara. Outro detalhe que causa confusão é a diferença entre variância populacional e amostral. Quando você tem acesso a todos os dados da população, usa N no denominador. Quando você está trabalhando com uma amostra pra estimar a população, usa n menos um. Esse n menos um se chama correção de Bessel e ela serve pra corrigir o viés de subestimação. Sem ela, a variância amostral tende a ser sistematicamente menor do que a variância real da população. Em amostras grandes, a diferença entre dividir por n ou n menos um é mínima. Com menos de trinta observações, a correção faz diferença sim e usar a fórmula errada pode te dar um desvio padrão até dez por cento menor do que deveria.
Um erro comum é confundir variância com amplitude. A amplitude só olha o máximo menos o mínimo. Dois conjuntos podem ter a mesma amplitude mas distribuições completamente diferentes. Um deles pode ter todos os pontos concentrados nas pontas e outro no centro. A variância captura isso porque considera a distância de cada ponto em relação à média. Você nunca deve usar amplitude no lugar de variância quando precisar de uma medida robusta de dispersão. Vou dar um exemplo prático rápido pra fixar. Suponha que você tenha os valores 4, 8, 6, 10 e 12. A média é 8. As diferenças ao quadrado são 16, 4, 4, 4 e 16. A soma é 44. Se isso for uma população, a variância é 44 dividido por 5, que dá 8.8. O desvio padrão é a raiz quadrada de 8.8, aproximadamente 2.97. Se for amostra, a variância é 44 dividido por 4, que dá 11. O desvio padrão é raiz de 11, cerca de 3.32. Pequena diferença numérica mas conceitual importante. Note que o desvio padrão está na mesma unidade dos dados originais, enquanto a variância está na unidade ao quadrado. Isso faz a variância ser mais difícil de interpretar diretamente. Quem trabalha com dados reais precisa saber que a variância assume uma distribuição simétrica em torno da média para fazer sentido pleno. Se seus dados são assimétricos, como renda familiar ou tempo de resposta de um servidor, a variância sozinha engana. Nesses casos, além da variância, calcule quartis e intervalo interquartil. O IQR é Q3 menos Q1 e ele é muito mais robusto porque não é afetado por caudas longas. Eu uso IQR pra análise exploratória rápida e variância só quando a distribuição se aproxima do normal ou quando o modelo exige variância explícita, como em ANOVA ou regressão.

Agora, um aviso direto: variância e desvio padrão não funcionam bem quando seus dados têm valores extremos recorrentes ou distribuição multimodal. Se você tem dois picos distintos no histograma, o desvio padrão vai dar um número médio que não representa nenhum dos grupos. Nesse cenário, a solução é segmentar os dados por cluster e calcular a variância dentro de cada grupo. Fazer isso diretamente nos dados brutos só vai mascarar a estrutura real. Se você quiser implementar isso rapidamente, a maioria das planilhas e linguagens já tem a função pronta. No Excel, VAR.P calcula variância populacional e VAR.S calcula variância amostral. O DESVPAD.P e DESVPAD.S fazem o mesmo pro desvio padrão. Em Python, numpy.var e numpy.std rodam em segundos e aceitam o parâmetro ddof pra controlar a correção de Bessel. Em R, var e sd são diretos. Nada disso exige download de ferramenta externa, mas se você quiser um arquivo de referência rápido, posso indicar scripts prontos de análise exploratória que já vêm com verificação de normalidade embutida. O ponto crucial que você precisa levar pra casa é que variância e desvio padrão são medidas complementares, não independentes. A variância dá o quadrado da dispersão e é útil matematicamente. O desvio padrão devolve a unidade original e é mais intuitivo. Use os dois. Confie neles quando seus dados forem aproximadamente normais e sem outliers dominance. Não confie cegamente quando houver assimetria forte, multimodalidade ou poucos dados com correção inadequada. Nesses casos, junte à média móvel, IQR e testadoras de normalidade antes de tomar qualquer decisão baseada apenas na variância.
Se o seu objetivo é monitorar estabilidade de processo, considere também o rango móvel médio como alternativa prática. Ele é mais resistente a valores isolados e costuma ser suficiente para cartas de controle. A variância entra mesmo quando você precisa de modelos estatísticos formais ou estimação de parâmetros, não como ferramenta única de descrição. Resumindo de forma seca: você agora sabe as fórmulas, sabe quando usar cada denominador, sabe que unidade aparece em cada resultado e sabe que existem situações em que variância e desvio padrão simplesmente não são a melhor escolha. O resto é aplicar com critério.
Galeria
-
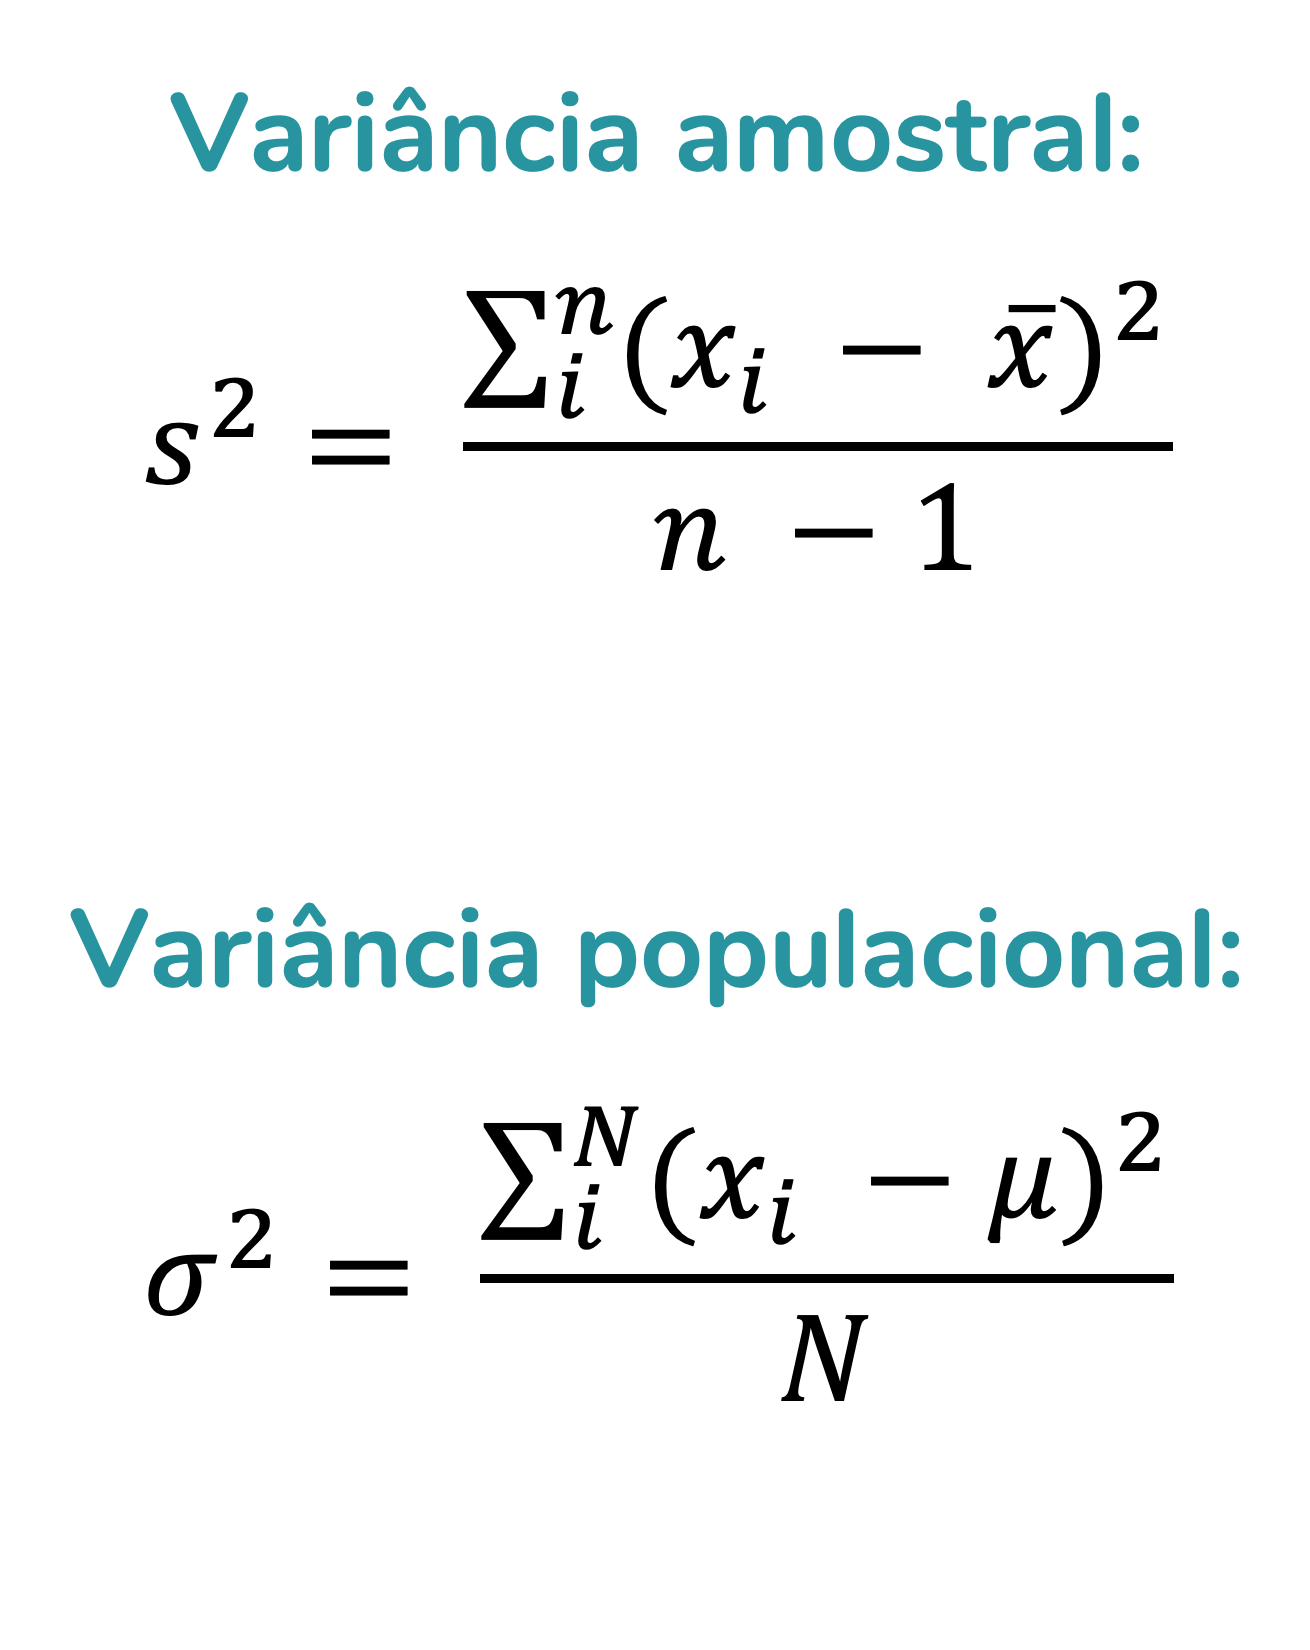
O que é variância? E desvio-padrão? | Fernanda Peres | Estatística aplicada -

Como Calcular O Desvio Padrão Da Variância – CTEVJ -

Variância e desvio padrão | Desvio padrão resumo, Medidas de dispersão ... -

Variância E Desvio Padrão Exercícios Resolvidos Pdf - ZULEDU
