Variaveis Sao Objetos De Estudo De Interesse Do Pesquisador
Entendendo o que você realmente está medindo na sua pesquisa
Ao iniciar qualquer projeto empírico, a definição das variáveis é frequentemente tratada como uma etapa burocrática, algo que se passa rápido para chegar à análise. Na prática, essa é a fase onde a maioria dos estudos encontra seus primeiros problemas sérios. Quando eu comecei a trabalhar com levantamentos quantitativos em educação, não dava conta de como uma variável mal operacionalizada podia distorcer completamente os resultados meses depois. Essa frase resume uma verdade fundamental da metodologia: as variáveis não existem independentemente do pesquisador. Elas são construídas deliberadamente para capturar aspectos específicos da realidade que o estudo pretende examinar. A escolha do que mede e do que ignora já é, em si, uma decisão teórica carregada de implicações. O problema prático que encontrei foi com uma escala de desempenho acadêmico que eu havia adaptado de um artigo anglófono. O instrumento original media "engajamento comportamental" através de indicadores como frequência de participação em aulas. No meu contexto de pesquisa, muitos alunos participavam ativamente mas não compareciam presencialmente, pois as aulas eram gravadas. A variável simplesmente não captava o fenômeno que eu pensava estar medindo. Passei três semanas refazendo a operacionalização antes de rodar a coleta. A solução foi incluir indicadores de engajamento cognitivo e emocional — tempo de interação nos fóruns, qualidade dos posts, autorrelato de esforço percebido — em vez de confiar apenas em presença física. O modelo de confiabilidade (alpha de Cronbach) dobrou quando essas dimensões foram incorporadas.
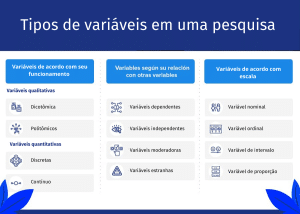
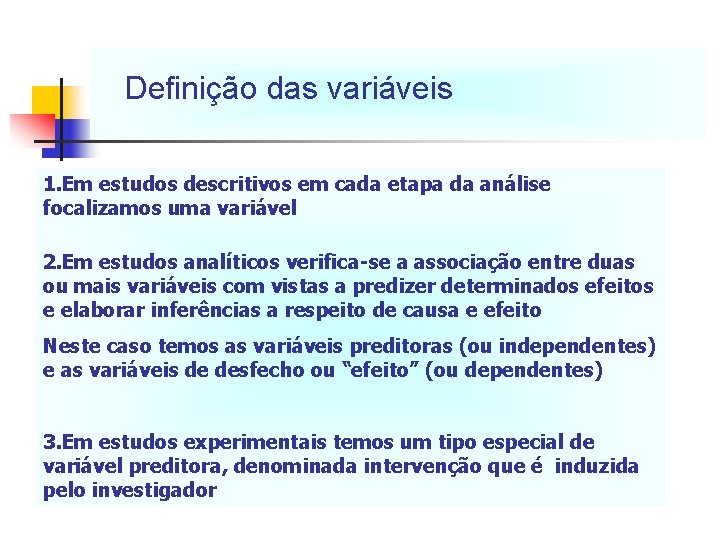
Variáveis dependentes, independentes, controladoras, moderadoras e mediadoras não são categorias que surgem automaticamente dos dados. Elas precisam ser estabelecidas antes da coleta, com base em um modelo teórico prévio. Definir isso depois é um erro comum que compromete toda a estrutura analítica. Se você só percebe quais são suas variáveis importantes depois de ver os cruzamentos, seu estudo já nasceu comprometido.
Operacionalização na prática
A operationalização é o processo de transformar um constructo abstrato em algo mensurável. Variáveis demográficas como idade e gênero são diretas — você as coleta com perguntas objetivas. Variáveis latentes como satisfação, motivação ou confiança exigem instrumentos validados ou, na ausência deles, a construção de escalas com itens específicos. Um item mal formulado pode inverter a direção da relação que você pretende observar. Na minha experiência, o maior erro de operacionalização que já vi foi com variáveis de contexto organizacional. Pesquisadores usavam dados secundários de demissão de funcionários como proxy de "clima organizacional". A correlação era estatisticamente significativa em três dos cinco estudos que analisei, mas o efeito prático era insignificante — turnover alto pode significar desde uma cultura tóxica até uma empresa em crescimento acelerado que reposiciona equipes constantemente. A variável capta o fenômeno, mas capta de forma ambígua, e essa ambiguidade quase nunca é discutida nas limitações. Uma dica útil e pouco óbvia: quando for construir itens para uma variável latente, evite que mais de um item meça exatamente o mesmo aspecto conceitual. Se três perguntas de uma escala perguntam sobre "satisfação com o salário" usando palavras praticamente sinonímicas, você está inflacionando artificialmente a confiabilidade interna sem ganhar validade de construto. O alpha de Cronbach vai subir, mas a escala não está medindo mais do que uma única dimensão — ela está repetindo a mesma dimensão três vezes.

Problemas que aparecem durante a análise
Colinearity entre variáveis independentes é um dos problemas mais silenciosos em modelos de regressão. Dois ou mais preditores que se correlacionam fortemente entre si (acima de 0,8 em geral) geram instabilidade nos coeficientes estimados. O resultado é que pequenas alterações no modelo — adicionar ou remover uma variável, excluir um outlier — podem fazer um coeficiente mudar de direção. O VIF (variance inflation factor) é a métrica padrão para diagnosticar isso. Valores acima de 5 ou 10 indicam colinearidade problemática, dependendo da convenção adotada. Outro ponto que poucos mencionam: variáveis controladoras não são automaticamente melhores quanto mais você adiciona ao modelo. Cada controle consome graus de liberdade e introduz variância extra. Em amostras pequenas, adicionar dez controles sem justificativa teórica forte pode piorar a capacidade do modelo de detectar efeitos reais. A regra prática é controlar apenas por variáveis que estejam empiricamente associadas tanto ao preditor quanto ao desfecho, e que não estejam no caminho causal entre eles. Controlar por uma variável que é consequência da independente é controlar por um mediador, o que suprime o efeito que você quer estimar. Em relação a outliers, a tendência é removê-los imediatamente. Eu já vi pesquisadoras removerem 12% dos casos assim que os gráficos de dispersão mostravam pontos distantes. Antes de excluir qualquer observação, teste se a remoção altera substantivamente os coeficientes. Se os resultados permanecem estáveis sem esses casos, aí sim justifique a exclusão. Se os coeficientes mudam drasticamente, o outlier pode estar contendo informação importante sobre a variabilidade do fenômeno, especialmente em amostras não probabilísticas.
Ferramentas para acompanhar o processo
Não existe software que defina variáveis por você, mas algumas ferramentas organizam melhor a documentação do que outras. Planilhas de matriz de medidas — onde cada linha é uma variável e cada coluna registra constructo, tipo, fonte, itens, confiabilidade esperada e estado atual — são o mínimo que um pesquisador sério deveria manter. Eu uso uma planilha desse tipo para cada estudo, e ela me economiza horas na fase de análise porque evita que eu tenha que rastrear qual operacionalização usei em qual momento. Para análise estatística, R com o pacote semver para validação de construtos, e o brms para modelos bayesianos, funciona bem. Para quem prefere interfaces gráficas, o jamovi oferece uma combinação razoável de acessibilidade e rigor — ele mostra diagnosticas de colinearidade e pressupostos de normalidade em tempo real enquanto você constrói o modelo, o que reduz bastante o risco de publicar resultados baseados em violações não verificadas. O SPSS ainda é amplamente usado em programas de pós-graduação, mas sua abordagem de clique-e-rode esconde muitos dos detalhes que importa acompanhar.
O que esse conceito não resolve
Reconhecer que variaveis sao objetos de estudo de interesse do pesquisador não substitui a necessidade de revisão de literatura sistemática. Variáveis bem definidas em um campo maduro podem ser simplesmente copiadas de estudos anteriores sem crítica, criando uma ilusão de rigor metodológico. O que faz uma variável ser relevante para um pesquisador em determinado momento histórico muitas vezes tem mais a ver com tendências disciplinares do que com evidência acumulada. Estudos sobre burnout profissional, por exemplo, multiplicaram suas publicações após 2020 sem que houvesse mudanças proporcionais na definição conceitual do constructo ou na validade de seus instrumentos de medida. Além disso, a ênfase excessiva em variáveis quantificáveis pode deixar de fora dimensões qualitativas importantes do fenômeno estudado. Quando se trata de experiências subjetivas complexas — como luto, identidade cultural, trauma — a tentativa de reduzir tudo a escala Likert de cinco pontos frequentemente produz dados que parecem precisos mas são superficialmente pobres. Nesses casos, métodos mistos ou abordagens predominantemente qualitativas costumam produzir descobertas mais válidas, ainda que menos generalizáveis. Por fim, variáveis não capturam interações emergentes. Relações não lineares, efeitos de soglia e dinâmicas temporais são frequentemente perdidos quando se trata as variáveis como entidades estáticas e isoladas. Modelos de equações estruturais lidam parcialmente com isso, mas exigem amostras grandes e especificação correta prévia — e quando a especificação está errada, o modelo simplesmente não converge ou converge para uma solução imprópria, o que passa despercebido por muitos revisores.

Galeria
-

Etapas do processo da pesquisa. As variáveis utilizadas para análise ... -
Oficina sobre tipos de estudos científicos | PPTX -
Tipos de Estudos Epidemiolgicos Prof Eliseu Alves Waldman
