Voce Foi Contratado Para Sincronizar
Guia prático de sincronização em ambientes reais
A maioria dos relatos sobre sincronização começa com a premissa de que o problema é técnico. Na prática, o problema quase sempre é de infraestrutura e de expectativas. Quando voce foi contratado para sincronizar servidores, clocks, bancos de dados ou arquivos, o primeiro erro comum é assumir que a ferramenta resolve tudo sozinha. Ela não resolve. Ela executa. O resto depende de como você configura o ambiente, quais limites conhece e quais gargalos ignora. Sincronizar é garantir que dois ou mais pontos do sistema compartilhem o mesmo estado dentro de uma tolerância aceitável. A tolerância varia conforme o contexto. Para NTP (Network Time Protocol), a janela pode ser de milissegundos. Para replicação de banco de dados, pode ser segundos. Para sincronização de arquivos via rsync ou ferramentas similares, pode ser minutos. Definir a janela correta antes de instalar qualquer coisa evita retrabalho. Eu já vi gente gastar três dias ajustando um daemon de sincronia apenas porque ninguém tinha definido se o objetivo era consistência forte ou eventual. Os dois pedidos exigem arquiteturas completamente diferentes. Aqui vai um exemplo direto. Você tem dois servidores de aplicação em regiões distintas e precisa que os logs e os dados críticos estejam alinhados. A resposta imediata é "usa replicação assíncrona". Mas isso só funciona se a aplicação for tolerante a pequenos descompasses. Se algum transaction precisa ser lida por ambos os lados instantaneamente, você entra em zoneamento de latência, heartbeat mais apertado ou cai em replicação síncrona. Replicação síncrona trava performance em WAN. Assíncrona cria janelas de inconsistência. A escolha não é neutra. Ela define o que quebra primeiro quando algo dá errado.
como começar sem quebrar nada
O passo inicial costuma ser simples, mas ele é ignorado com frequência. Mapeie os fluxos. Anote quais dados precisam estar sincronizados, quais são sensíveis à latência e quais podem esperar. Depois disso, defina o ciclo de atualização. Um intervalo de 5 segundos para logs é razoável. Para um banco transacional, esse mesmo intervalo pode gerar conflitos em cascata. O ideal é usar um mecanismo de versionamento, como timestamps precisos ou Logical Logs, dependendo da stack que você está operando. Isso reduz colisões e evita que um evento sobrescreva outro por acaso. Se o tema é sincronização de horário, comece com NTP. Configure os servidores primários e secundários, verifique as camadas destrans e monitore o jitter. Em ambientes corporativos, usar servidores NTP internos como pool local evita dependência de redes públicas. A desvantagem é que você precisa manter a precisão desses servidores internos alinhada a fontes confiáveis. Eu tive um caso em que um Data Center mudou o horário de verão de um fuso sem ajustar a configuração NTP. O resultado foi um drift de 3600 segundos em duas horas. Sistemas agendados erraram jobs, certificados TLS falharam na validação e filas de message broker desincronizaram. A correção não foi reinstalar o serviço. Foi corrigir o fuso no host pai, recarregar a configuração e rodar um resync forçado com o servidor raiz. Dica prática: depois de qualquer ajuste de timezone, rode um ntpq -p e verifique o offset antes de liberar a fila de trabalho.
edge case que todo mundo esquece
Um dos problemas mais chatos que eu encontrei ao lidar com sincronização foi o seguinte. Tinha um cluster de três nós rodando réplicas de banco e um scheduler distribuído. O scheduler disparava jobs de sync a cada 10 segundos. Até aí, funcionando. O problema surgiu quando um dos nós teve uma micro interrupção de rede de 8 segundos. Como o protocolo usava heartbeat assíncrono, o nó entrou em estado de half-sync. Os outros dois continuaram recebendo writes e geraram divergência de registros. Quando o nó voltou, ele aplicou um commit log desalinhado e corrompeu a sequência de transactions. A correção foi entrar no modo read-only, forçar um snapshot consistente, reprocessar o log a partir do último ponto conhecido e só então retornar ao cluster. Não existe automação que resolva isso sem supervisionamento. Ferramentas de sync não detectam meia-conexão. Elas detectam ausência total. Outro ponto que pouca gente leva a sério é a resolução de conflitos. Se dois escritores atualizam a mesma chave simultaneamente, o sistema precisa de uma política definida. Last-write-wins é simples, mas perigoso. Vector clocks são mais seguros, mas aumentam a complexidade. Merge functions customizadas são ideais para domínios específicos, como carrinhos de compra ou estoques. Escolher a política errada gera perda silenciosa de dados. Eu vi um operador escolher last-write-wins para um sistema de inventário. O resultado foi produtos sendo vendidos duas vezes porque dois armazéns atualizaram o estoque no mesmo segundo e um dos updates foi descartado. A solução final foi migrar para uma função de merge baseada em soma ponderada e auditoria manual dos itens críticos durante uma semana de transição.

ferramentas e quando elas falham
rsync é excelente para arquivos e backups incrementais. Funciona bem em LAN. Em WAN com alta latência, o overhead de handshake e a verificação de checksum podem transformar uma cópia de 50 GB em algo que leva horas. Nesse cenário, alternativas como rclone com compressão ativa ou soluções baseadas em delta-transfer com hash regional reduzem o tempo em até 60%. Para banco de dados, MySQL binlog replication é padrão. PostgreSQL usa WAL streaming. Ambos exigem monitoramento de lag. Se o rep lag passar de 30 segundos em produção crítica, o sistema de relatórios pode entregar resultados defasados sem que ninguém perceba imediatamente. Um alert baseado em segundos de lag é mais útil do que um alert baseado em estado do serviço, porque o serviço continua "up" mesmo estando inconsistente. Há ainda o caso de sincronização em nuvem híbrida. Arquivos subindo para S3, Blob ou GCS parecem simples, mas o custo de requisições e a latência de consistency model podem surpreender. Strong consistency em S3 é real agora, mas replicações cross-region ainda seguem eventual consistency por padrão. Se sua aplicação depende de leitura imediata após write, você precisa forçar a consistência ou ajustar a arquitetura para aceitar read-after-write com retry. Ignorar isso gera bugs que aparecem só em produção e são péssimos de reproduzir em staging.
limitações reais que ninguém anuncia
Sincronização nunca é perfeita. Sempre existe uma janela entre o momento em que uma mudança é aplicada em um nó e o momento em que ela aparece no outro. Essa janela varia de milissegundos a segundos, dependendo do protocolo, da carga e da topologia de rede. Quanto maior a distância física, maior a latência. Isso é física, não configuração. Tentar compensar com polling mais agressivo só aumenta carga de CPU e tráfego de rede. O melhor ajuste é conhecer a latência média do seu link e definir intervalos de sync compatíveis. Se o link tem 120ms de latência média, um intervalo de 50ms é inútil e prejudicial. Outro limite importante é a escalabilidade de writers. Sistemas de sync geralmente suportam muitos readers, mas writers concorrentes criam contention. A contenção aumenta não-linearmente. Dois writers concorrentes podem dobrar o tempo de convergência. Quatro writers podem triplicar. Se sua carga espera múltiplos writers ativos, considere sharding por chave ou usar um mediator centralizado para serializar writes críticos. Alternativamente, migre para um modelo event-sourcing com append-only log, que elimina conflitos na origem e transfere a complexidade para a reconstrução de estado. Também é honesto dizer que sincronização não substitui backup. Se um nó corrupto espalha um estado errado para todos os outros, você terá todos os nós consistentes e todos errados. Ter sincronização e não ter snapshots pontuais é ter uma cópia rápida do problema. Rodar backups imutáveis uma vez ao dia, preferencialmente em storage separado, ancora a recuperação em um ponto conhecido.
checklist que eu uso antes de liberar produção
- Definição clara de consistência esperada: forte, eventual ou session.
- Topologia mapeada: quantos nós, quantas regiões, qual a latência entre eles.
- Política de conflito documentada e testada com dados reais, não com dados sintéticos.
- Monitor de lag em segundos, com alertas em três níveis: warn, critical e recovery.
- Plano de rollback que inclui snapshot anterior e procedimento de reconexão segura.
- Teste de failover real, não apenas stop/start. Simule queda de link e verifique se o recovery acontece em menos de X minutos, onde X foi acordado com o negócio.
Quando voce foi contratado para sincronizar, o trabalho não termina quando os nós ficam verdes. Ele termina quando o time sabe o que fazer se um nó travar no meio de uma transação, se o link cair durante um batch e se o clock desviar por causa de migração de fuso. Ferramentas são úteis. Conhecimento dos limites é o que evita dor de cabeça. Se você ainda não tem isso documentado, comece pela definição de SLA de sincronia e pela lista de cenários de falha. O resto segue naturalmente.

Galeria
-

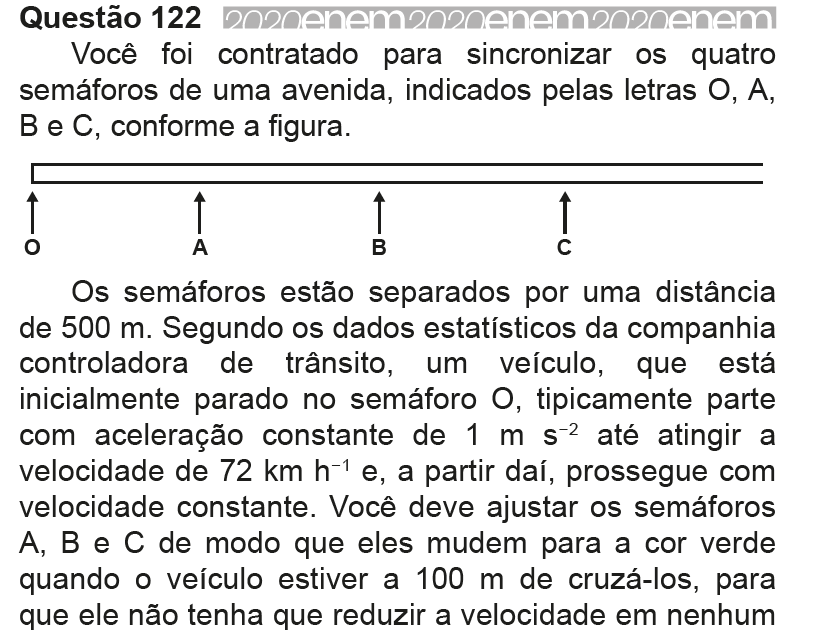
RESOLUÇÃO ENEM 2020 - Você foi contratado para sincronizar os quatro ... -

Enem 2020 - Você foi contratado para sincronizar os quatro semáforos de ... -

Enem 2020 | Você foi contratado para sincronizar os quatro semáforos de ...
