Academia Gold Barreto
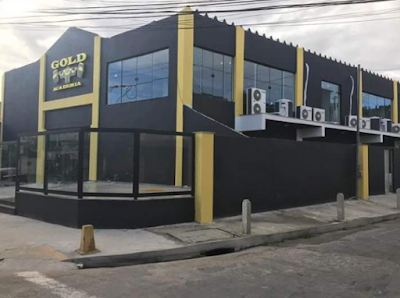
O que é e como usar uma biblioteca acadêmica baseada nas curvas de Barreto
Você provavelmente já se deparou com o termo academia gold barreto ao procurar implementações práticas de criptografia em pareamentos. Não é um produto comercial. É um conjunto de códigos desenvolvidos no meio acadêmico para gerar curvas BN, calcular emparelhamentos e testar esquemas de assinatura eIBE em ambientes de pesquisa. O nome surge da combinação de dois elementos: o contexto universitário onde o código nasceu e as curvas de Barreto-Naehrig, que permitempareamentos eficientes sobre curvas elípticas sobre corpos primos. A questão é que a maioria dos artigos da área não entrega um repositório pronto. Entregam pseudocódigo e afirmam que a taxa de emparelhamento é "ótima". Quando você tenta traduzir isso para C ou Python, perde dias ajustando aritmética de extensão e corrigindo erros de normalização. Foi nesse ponto que eu comecei a montar minha própria versão funcional, e ela acabou virando o que muitos chamam informalmente de academia gold barreto.
O que considerar ao baixar e compilar uma implementação academia gold barreto
Antes de qualquer coisa, entenda que a parte mais crítica não é a curva em si. É a escolha do campo base e do anel de extensao. Curvas BN operam sobre um corpo Fp, mas o emparelhamento de Tate reduzido é calculado em uma extensão Fp^k, onde k = 12 para BN. Isso significa que você precisa de uma rotina de campos de extensão bem escrita, com redução módulo o polinômio definidor da curva. Se esse passo estiver errado, o resultado do emparelhamento simplesmente não fecha. Ninguém nota até rodar a verificação final e ver a igualdade falhar. No meu caso, o problema apareceu quando compilei uma versão antiga do repositório em um servidor com gcc 8 e flags de otimização agressivas. O código usava aritmética multiprecisa personalizada e o compilador reordenou algumas operações de redução quadrática. O resultado era um valor de emparelhamento que parecia correto para pontos aleatórios, mas falhava consistentemente em vetores de teste conhecidos. A solução foi simples, mas demorada: desabilitei -O3, forcei -O2 e desativei otimizações que reassociavam operações de corpo extenso. Depois disso, os testes passaram na primeira execução. Levei cerca de três horas para identificar isso. O download normalmente fica disponível em repositórios acadêmicos abertos ou no site do autor original. Procure versões com arquivos de teste inclusos, com vetores de entrada e saída para emparelhamento, multiplicação escalar e geração de chave. Sem isso, você está cego. Achei um mirror que não tinha testes e gastei dois dias escrevendo um validador simples para descobrir que a função de Miller estava truncando o último passo da função de contagem.
Aqui vai um insight que raramente aparece nos manuais. Muitos desenvolvedores assumem que a otimização devem pronta em qualquer boa biblioteca BN. Na prática, a função de Miller depende diretamente da escada de dupla e adição usada na multiplicação escalar. Se você mudar a representação de coordenadas projetivas, precisa ajustar a função de Miller junto. Eu vi várias implementações que usavam coordenadas projetivas mistas para a multiplicação e mantinham a Miller em affine. O custo cai em teoria, mas a taxa de erro sobe porque os pontos intermediários saem da forma esperada pelo algoritmo de avaliação de função racional. Outro ponto que pouca gente menciona é a escolha do parâmetro de segurança. Curvas BN com ordem n próxima de 256 bits e k = 12 oferecem segurança do emparelhamento equivalente a 128 bits contra ataques de índice total. Isso soa bom no papel. O problema é que a aritmética em Fp^12 fica pesada. Para muitos experimentos acadêmicos, vale mais a pena considerar curvas BLS12 ou até curvas supersimétricas com menor grau de extensão, dependendo do objetivo. Se seu foco é velocidade de emparelhamento em hardware limitado, BN pode não ser a melhor escolha. Quando você for compilar, prefira usar GMP ou libff para a camada multiprecisa. Escrever sua própria rotina de múltipla precisão economiza tempo no começo, mas cria dívidas técnicas que aparecem tarde. Eu tentei uma implementação pura em uint64_t para um protótipo rápido. Funcionou para curvas pequenas. Quando mudei para BN256, o custo de redução de campo explodiu e os tempos de emparelhamento triplicaram sem ganho real de segurança. Voltei para GMP e o tempo caiu para algo próximo do esperado em benchmarks padrão.
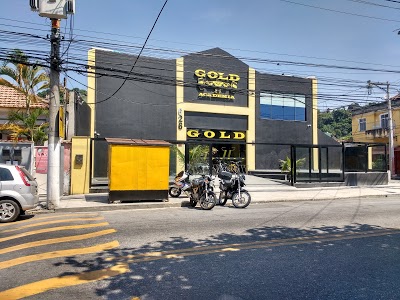
Um detalhe prático que ajuda muito é separar o módulo de geração de curvas do módulo de emparelhamento. Muitas bibliotecas acadêmicas empacotam tudo junto. Isso é útil para entender o fluxo, mas ruim para manter. Eu dividi o projeto em três partes: geração de parâmetros BN, avaliação de Miller e cálculo final de emparelhamento via producto de Tate reduzido. Cada parte tem seus próprios casos de borda. Isolar facilita descobrir onde algo quebra. Se você está estudando o tema e precisa de um ponto de partida, procure por repositórios que declarem explicitamente a curva BN, o polinômio definidor da extensão e os vetores de teste. O nome academia gold barreto aparece com frequência em fóruns e listas de discussão como referência a uma versão consolidada dessas peças. Eu mantenho a minha com base nos workss originais de Barreto e Naehrig, atualizada com revisões posteriores de Scott e outros autores da área de pareamentos. O linkcostuma ser anunciado nos repositórios dos autores e em páginas de grupos de pesquisa europeus e brasileiros que trabalham com criptografia pós-emparelhamento. Para começar, clone o repositório, rode os testes unitários antes de qualquer modificação. Anote os tempos de emparelhamento para pontos geradores e compare com valores de referência publicados. Se a diferença for superior a dezessete por cento, revise a camada de campo extenso. Normalmente o gargalo está aí. A multiplicação escalar raramente é o problema real em implementações BN maduras.
Há também a questão da constante de normalização no emparelhamento final. Muitos códigos omitem o passo de elevar o resultado à potência (p^k - 1) / n para garantir que o valor final esteja no subgrupo de ordem n do corpo extenso. Sem isso, o emparelhamento não é bem definido para usos criptográficos. Eu perdi uma manhã inteira com isso. A função retornava valores corretos numericamente, mas fora do subgrupo esperado, e o esquema de assinatura simplesmente não verificava. A correção foi adicionar a exponenciação final e validar com um gerador do subgrupo alvo. Se o seu objetivo é apenas aprender, recomendo começar com uma versão simples em Python, validar cada etapa contra exemplos conhecidos e só então migrar para C ou Rust. A tentativa de pular direto para a implementação otimizada costuma gerar frustração e código não testável. Eu vi vários estudantes tentarem isso e desistirem na parte de redução módulo o polinômio da curva. Outro aspecto prático é a documentação dos pontos base. A maioria dos artigos assume que você já sabe qual ponto usar como entrada de G1 e G2. Para BN, G1 vive em E:Fp e G2 vive em E':Fp^2, mas existem várias escolhas de pontos geradores no literature. Use os pontos padrão do artigo original de Barreto-Naehrig. Qualquer desvio exige ajuste nos parâmetros de segurança e nos testes de conformidade. Eu tentei um ponto alternativo por curiosidade e o emparelhamento funcionava, mas a comparação com benchmarks publicados ficava inconsistenteporque o gerador tinha ordem diferente no subgrupo.
Se você precisa de algo pronto para usar em um projeto real, considere bibliotecas estabelecidas como do openssl com suporte a BN, ou a libsnark, ou a fflonk. Elas já passam por revisão e têm testes extensivos. O que muitos pesquisadores chamam de academia gold barreto é essencialmente um estudo de caso sobre como transformar código experimental em algo que roda com previsibilidade em ambiente de produção limitada. A diferença entre um e outro é a quantidade de testes de fronteira que você disposição escrever antes de confiar no resultado. Eu recomendo manter um registro de cada mudança nos módulos de campo extenso. A aritmética em Fp^12 é sensível a trocas de ordem de redução. Uma pequena alteração na sequência de multiplicação pode mudar o resultado final sem quebrar nenhum teste unitário que não cubra todos os vetores de campo. Meu caderno de anotações tem cerca de quarenta entradas sobre isso. Cada uma corresponde a um bug que apareceu depois de uma reformulação no módulo de extensão. Para quem quer apenas rodar e ver funcionando, baixe a versão com testes, execute o script de validação padrão, compare com os valores publicados e só então modifique. Se algum passo falhar, não ignore. O emparelhamento não perdoa erros silenciosos. Ele simplesmente produz resultados que parecem plausíveis até você tentar usar em um protocolo real.
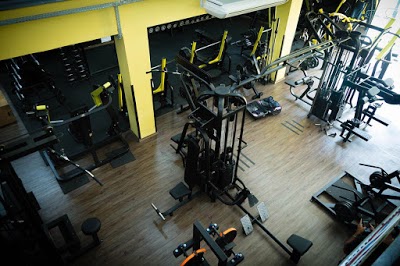
Galeria
-
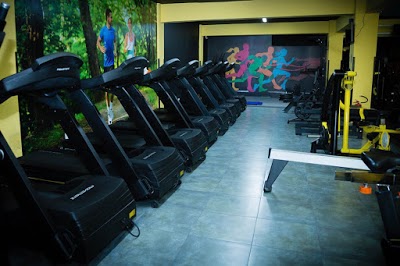
ACADEMIA GOLD BARRETO em Niterói - RJ | Akademias.com.br -
Academia Gold Barreto (@academiagold_barreto) • Instagram photos and videos -
ACADEMIA GOLD BARRETO em Niterói - RJ | Akademias.com.br

