Como As Dispersões Se Classificam

Medidas de dispersão: o que realmente importa na prática
A gente costuma começar ensinando amplitude, depois variância, desvio padrão e coeficiente de variação. A ordem não é sagrada, mas funciona porque constrói em cima do que você já vê. Amplitude é o primeiro número que uma turma consegue calcular sem travar. Elas se agrupam em duas linhas. Absolutas, quando o resultado fica na mesma unidade dos dados. Relativas, quando viram um índice sem unidade, feito pra comparar séries diferentes. Dentro das absolutas, a amplitude é a mais grosseira. Funciona quando você precisa de uma resposta rápida num relatório e o público não vai questionar. Mas ela só olha dois valores. Se sua amostra tiver um outlier forte, a amplitude já mentiu pra você.
A variância é o próximo degrau. Ela pega cada desvio em relação à média, eleva ao quadrado e tira a média desses quadrados. O detalhe que todo mundo perde: ao elevar ao quadrado, você muda a unidade. Variância de salário fica em reais ao quadrado. Isso estraga a interpretação direta, mas é exatamente por isso que existe o desvio padrão. O desvio padrão volta pra unidade original. Ele é a raiz quadrada da variância. Na prática, você lê assim: a maioria dos seus dados cai num intervalo perto da média, e esse intervalo tem tamanho controlado pelo desvio padrão. Se a distribuição for aproximadamente normal, cerca de 68% dos valores ficam dentro de um desvio padrão da média. Não precisa ser perfeitamente normal pra esse número ser uma bússola útil, mas o controle fica mais fraco quando a coisa tá bem assimétrica. A amplitude interquartílica, o chamado IQR, corta as pontas e fica com o meio. É a medida que eu mais uso quando os dados têm caudas pesadas. Ela ignora os 25% menores e os 25% maiores e concentra no quartil entre o Q1 e o Q3. Isso elimina o efeito destrutivo de valores extremos que distorce amplitude e variância.
Quando a comparação envolve séries com médias muito diferentes, as medidas absolutas viram piada. Salário e idade não se comparam por variância sozinha. Aí entra o coeficiente de variação. Ele divide o desvio padrão pela média e transforma tudo em percentual. Um CV de 15% significa que o desvio padrão corresponde a 15% da média. Quando a média é próxima de zero, esse número explode. Anote isso, porque já vi gente reportar CV de 800% em dados de temperatura em Kelvin convertidos sem ajustar a interpretação. Tem outra medida relativa que faz sentido em contextos específicos. O desvio médio absoluto, ou DMA, pega os desvios absolutos em relação à média e tira a média deles. Ele é mais robusto que a variância em distribuições com outliers, mas é menos usado em teoria estatística avançada porque não tem propriedades algébricas tão bonitas. Não Ignorando isso, é uma ferramenta válida quando o objetivo é clareza operacional. O percentil é um conceito separado, mas aparece junto porque ajuda a montar amplitude interquartílica e outros indicadores. Percentil 90 não é dispersão por si só. É uma posição. A diferença entre percentis é que vira medida de dispersão.

Na mão, o cálculo roda assim. Para variância amostral, some os quadrados dos desvios e divida por n menos um. Para população, divide por n. A escolha muda o número. Em amostras pequenas, a correção por n menos um evita subestimar a variabilidade. Se você usar n em tudo, suas estimativas vão ficarsystematicamente baixas e seus intervalos de confiança não vão fechar direito. O trabalho real começa quando os dados não querem se comportar. No meu último projeto com dados de tempo de resposta de API, a média era 120 milissegundos, mas a distribuição tinha cauda longa porque alguns endpoints entravam em retry. Amplitude dava 4 segundos. Variância dava um número tão grande que parecia erro de digitação. Desvio padrão voltava em centenas de milissegundos. Coeficiente de variação passava de 200%. Nenhuma dessas medidas contava a história inteira. A solução que funcionou foi combinar IQR com desvio padrão trimado. Eu cortei 5% das pontas de cada lado, recalculei a média e o desvio padrão, e usei o IQR para validar a estabilidade do centro. Isso reduziu o tempo de análise de horas para minutos e evitou decisões baseadas em valores que só existiam por causa de timeouts mal configurados.
Se você precisa de algo rápido e os dados são limpos, amplitude já basta para um primeiro olhar. Se quer comparar duas séries com escalas diferentes, vire para o coeficiente de variação. Se os dados têm outliers, use amplitude interquartílica. Se a forma da distribuição é importante, considere também assimetria e curtose junto com o desvio padrão, porque sozinha a dispersão não conta tudo. Erros comuns que aparecem todo dia. Misturar variância populacional com amostral sem avisar. Usar coeficiente de variação quando a média é próxima de zero. Reportar só amplitude em distribuições assimétricas e achar que está sendo rigoroso. Confundir desvio padrão com margem de erro. Desvio padrão descreve seus dados. Margem de erro fala da incerteza da média em relação à população. São coisas diferentes. Outro ponto que ninguém menciona com frequência suficiente. Medida de dispersão não vale muito se a medida de tendência central for inadequada. Se sua média foi corrompida por outliers, usar desvio padrão em torno dela vai distorcer a leitura. Nesse caso, use mediana com IQR. A combinação faz mais sentido do que insistir em média mais desvio padrão em dados que não respeitam essa parelha.
Resumindo de forma útil. Amplitude para velocidade. Variância e desvio padrão para modelsque assumem simetria razoável. IQR quando outliers estão presentes. Coeficiente de variação para comparação relativa. DMA quando a interpretação em unidade original importa mais que propriedade teórica. A escolha não é estética. Ela define se sua conclusão vai sobreviver ao primeiro questionamento.

Galeria
-
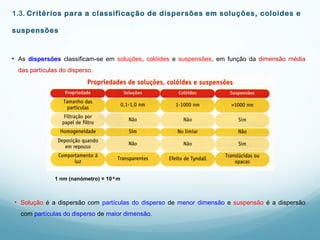
1. dispersões | PPT -

Tipos de Dispersões. Estudo dos Tipos de Dispersões - Brasil Escola -
Classificação de Dispersões Químicas | PDF | Coloide | Mistura

